


Python爬虫模拟知乎登录:Cookie与Session实战详解

本文详解如何利用Python爬虫模拟知乎登录。通过解析HTTP Cookie机制,使用requests库的session对象自动管理Cookie,结合BeautifulSoup提取_xsrf令牌,并调用接口获取验证码,实现自动登录流程。代码示例展示了从加载本地Cookie到提交登录请求的完整逻辑,帮助开发者掌握动态网页抓取中的身份验证技巧。
前言
对于从事爬虫开发的工程师而言,许多页面在未登录状态下禁止抓取,例如知乎的话题页面强制要求用户登录。实现这一过程的关键在于理解并应用HTTP协议中的Cookie技术。
登录原理
Cookie机制的设计初衷是为了解决HTTP无状态协议的问题。由于HTTP本身不维护会话状态,服务器无法识别连续请求是否来自同一客户端。Cookie技术应运而生,它作为服务端分配给客户端的唯一标识,使得服务器能够追踪用户状态,从而在HTTP协议之上构建会话(session)管理。
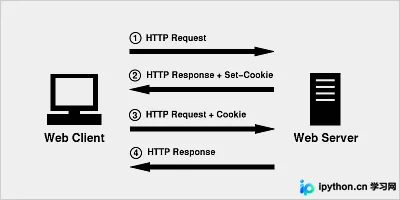
- 浏览器首次发起HTTP请求时,请求头中不包含任何Cookie信息。
- 服务器处理请求后,在返回HTTP响应的同时,会在响应头中携带Cookie信息发送给浏览器。
- 当浏览器发起第二次请求时,会自动将之前服务器返回的Cookie信息附加在请求头中发送给服务器。
- 服务器接收到HTTP请求后,检查请求头中的Cookie字段。若存在有效的Cookie,服务器即可确认该用户之前的交互记录,从而维持会话状态。
实战应用
熟悉知乎操作的用户知道,只需输入用户名、密码及验证码即可完成登录。这仅是用户界面的表象,其背后的技术细节需借助浏览器开发者工具进行深入分析。接下来,我们将使用Chrome浏览器观察填写表单后浏览器发送的具体请求过程。
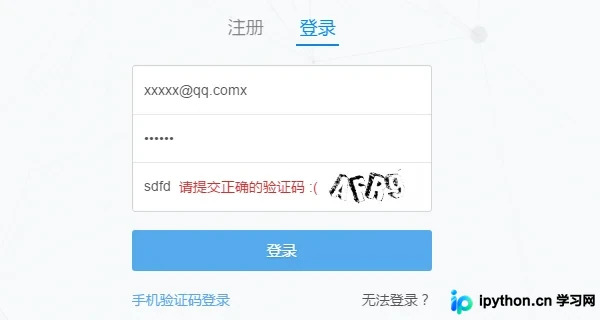
(若已登录,请先退出)首先访问知乎登录页面 https://www.zhihu.com/#signin ,按下F12打开Chrome开发者工具。尝试输入错误的验证码,以观察浏览器发送请求的具体行为。
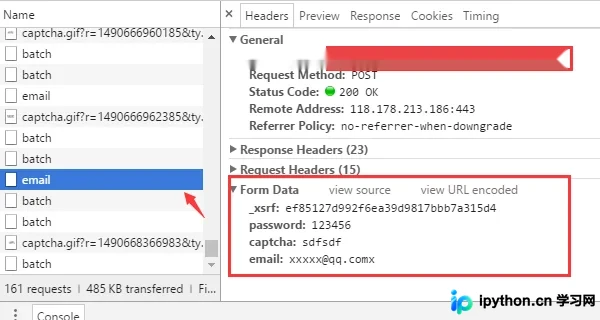
通过分析浏览器的网络请求,可以提取出几个关键信息:
- 登录提交的URL地址为 https://www.zhihu.com/login/email 。
- 登录请求所需的表单数据包含四项:用户名(email)、密码(password)、验证码(captcha)以及 _xsrf 。
- 获取验证码图片的URL地址为 https://www.zhihu.com/captcha.gif?r=1490690391695&type=login 。
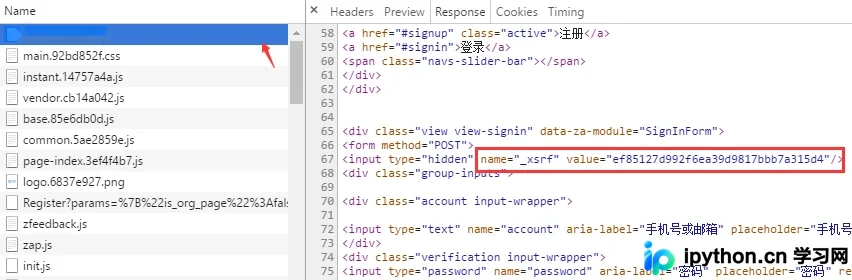
_xsrf 是什么?若你对CSRF(跨站请求伪造)攻击有深入了解,便知其作用。_xsrf 是一串伪随机数,旨在防止跨站请求伪造攻击。通常它存在于网页的 form 表单标签中。通过在页面上搜索 “xsrf”,可以发现 _xsrf 隐藏在一个隐藏的 input 标签内。
明确了浏览器登录所需数据的获取方式后,即可开始编写Python代码模拟浏览器登录。实现此功能依赖的两个第三方库是 requests 和 BeautifulSoup,请先安装它们。
pip install beautifulsoup4==4.5.3
pip install requests==2.13.0
http.cookiejar 模块用于自动处理HTTP Cookie,其中 LWPCookieJar 对象是对Cookie的封装,支持将Cookie保存到文件以及从文件中加载。
session 对象提供了Cookie的持久化存储和连接池功能,可以通过 session 对象发送HTTP请求。
首先尝试从 cookies.txt 文件中加载Cookie信息。由于首次运行程序时本地尚不存在Cookie文件,因此会触发 LoadError 异常。
from http import cookiejar
session = requests.session()
session.cookies = cookiejar.LWPCookieJar(filename='cookies.txt')
try:
 session.cookies.load(ignore_discard=True)
except LoadError:
 print("load cookies failed")
获取 xsrf
前文已定位到 xsrf 所在的标签,利用 BeautifulSoup 的 find 方法可以便捷地提取该值。
def get_xsrf():
 response = session.get("https://www.zhihu.com", headers=headers)
 soup = BeautifulSoup(response.content, "html.parser")
 xsrf = soup.find('input', attrs={"name": "_xsrf"}).get("value")
 return xsrf
获取验证码
验证码通过 /captcha.gif 接口返回。在此步骤中,我们将验证码图片下载并保存至当前目录,由人工进行识别。当然,你也可以集成第三方支持库(如 pytesser)来实现自动识别。
def get_captcha():
 """
 把验证码图片保存到当前目录,手动识别验证码
 :return:
 """
 t = str(int(time.time() * 1000))
 captcha_url = 'https://www.zhihu.com/captcha.gif?r=' + t + "&type=login"
 r = session.get(captcha_url, headers=headers)
 with open('captcha.jpg', 'wb') as f:
  f.write(r.content)
 captcha = input("验证码:")
 return captcha
登录
当所有参数准备就绪后,即可向登录接口发起请求。
def login(email, password):
 login_url = 'https://www.zhihu.com/login/email'
 data = {
  'email': email,
  'password': password,
  '_xsrf': get_xsrf(),
  "captcha": get_captcha(),
  'remember_me': 'true'}
 response = session.post(login_url, data=data, headers=headers)
 login_code = response.json()
 print(login_code['msg'])
 for i in session.cookies:
  print(i)
 session.cookies.save()
请求成功后,session 对象会自动将服务端返回的Cookie信息填充至 session.cookies 中。在后续的请求中,客户端即可自动携带这些Cookie访问需要登录权限的页面。
auto_login.py 示例代码
# encoding: utf-8
# !/usr/bin/env python
"""
作者:liuzhijun
"""
import time
from http import cookiejar

import requests
from bs4 import BeautifulSoup

headers = {
  "Host": "www.zhihu.com",
  "Referer": "https://www.zhihu.com/",
  'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_10_5) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/56.0.2924.87'
}

# 使用登录cookie信息
session = requests.session()
session.cookies = cookiejar.LWPCookieJar(filename='cookies.txt')
try:
  print(session.cookies)
  session.cookies.load(ignore_discard=True)

except:
  print("还没有cookie信息")


def get_xsrf():
  response = session.get("https://www.zhihu.com", headers=headers)
  soup = BeautifulSoup(response.content, "html.parser")
  xsrf = soup.find('input', attrs={"name": "_xsrf"}).get("value")
  return xsrf


def get_captcha():
  """
  把验证码图片保存到当前目录,手动识别验证码
  :return:
  """
  t = str(int(time.time() * 1000))
  captcha_url = 'https://www.zhihu.com/captcha.gif?r=' + t + "&type=login"
  r = session.get(captcha_url, headers=headers)
  with open('captcha.jpg', 'wb') as f:
    f.write(r.content)
  captcha = input("验证码:")
  return captcha


def login(email, password):
  login_url = 'https://www.zhihu.com/login/email'
  data = {
    'email': email,
    'password': password,
    '_xsrf': get_xsrf(),
    "captcha": get_captcha(),
    'remember_me': 'true'}
  response = session.post(login_url, data=data, headers=headers)
  login_code = response.json()
  print(login_code['msg'])
  for i in session.cookies:
    print(i)
  session.cookies.save()


if __name__ == '__main__':
  email = "xxxx"
  password = "xxxxx"
  login(email, password)
github源码地址:https://github.com/lzjun567/crawler_html2pdf/blob/master/zhihu/auto_login.py
总结
以上内容完整介绍了Python爬虫模拟知乎登录的方法,希望能为读者在学习或使用Python时提供有益的帮助。如有任何疑问,欢迎留言交流,感谢大家对本站的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















