


MySQL内部临时表原理与优化:UNION、GROUP BY使用场景详解

MySQL在执行复杂查询时,经常需要使用内部临时表来暂存中间结果或进行排序去重。本文将深入剖析在UNION去重、GROUP BY聚合以及DISTINCT操作中,临时表的创建逻辑与执行流程,并结合tmp_table_size参数分析内存转磁盘的临界点,最后提供通过索引改造和优化器提示提升性能的具体方案。
UNION 去重的临时表机制
UNION指令用于合并多个子查询的结果集并去除重复行。由于需要对不同来源的数据进行比对过滤,MySQL通常会在后端创建一个内存临时表来实现这一语义。
第1步:准备测试数据
为了观察临时表的行为,首先建立一个包含索引的基础表并填充数据:
CREATE TABLE t1(id INT PRIMARY KEY, a INT, b INT, INDEX(a));
DELIMITER ;;
CREATE PROCEDURE idata()
BEGIN
    DECLARE i INT;
    SET i=1;
    WHILE (i<= 1000) DO
        INSERT INTO t1 VALUES (i,i,i);
        SET i=i+1;
    END WHILE;
END;;
DELIMITER ;
CALL idata();
第2步:执行UNION查询并分析执行计划
运行以下带UNIO操作符的查询,并通过EXPLAIN查看其底层实现:
(SELECT 1000 AS f) UNION (SELECT id FROM t1 ORDER BY id DESC LIMIT 2);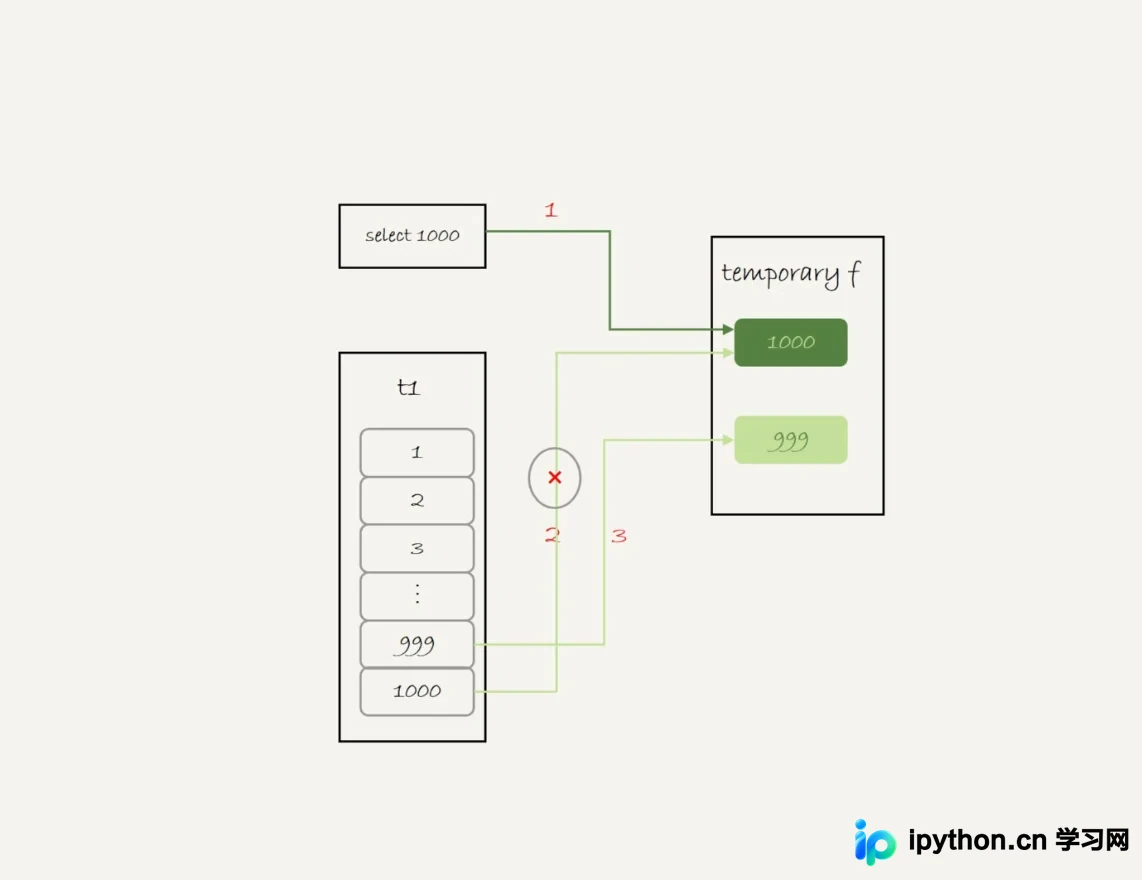
- 执行计划中的
Extra字段显示Using temporary,表明在处理UNION RESULT阶段创建了临时表。 - 该临时表为内存表结构,仅包含一个整型字段且设为主键,利用主键的唯一性约束自动去重。
其具体执行过程如下:
- 初始化一个只含一个字段的内存临时表。
- 执行第一个子查询得到值
1000,尝试插入临时表,插入成功。 - 执行第二个子查询
SELECT id FROM t1 ORDER BY id DESC LIMIT 2,分别取出1000和999。 - 插入
1000时因违反唯一性约束失败(已被第一步存入),跳过;插入999时成功。 - 最终返回临时表中的数据。
UNION ALL 的性能差异
若采用 UNION ALL 则没有去重需求,MySQL 会直接将各子查询结果发给客户端,无需建立临时表。对比如下:
mysql> EXPLAIN (SELECT 1000 AS f) UNION ALL (SELECT id FROM t1 ORDER BY id DESC LIMIT 2);该语句的执行计划中不再出现 Using temporary,查询效率更高。
GROUP BY 分组操作的内部实现
在使用 GROUP BY 进行聚合运算时,如果查询涉及非直接索引排序的列,或者计算了聚合函数(如 COUNT),MySQL 同样可能需要借助临时表。
1. 内存充足时的标准处理流程
默认情况下,MySQL 使用的内存临时表大小上限为 tmp_table_size 变量所设定的值(通常是 16MB):
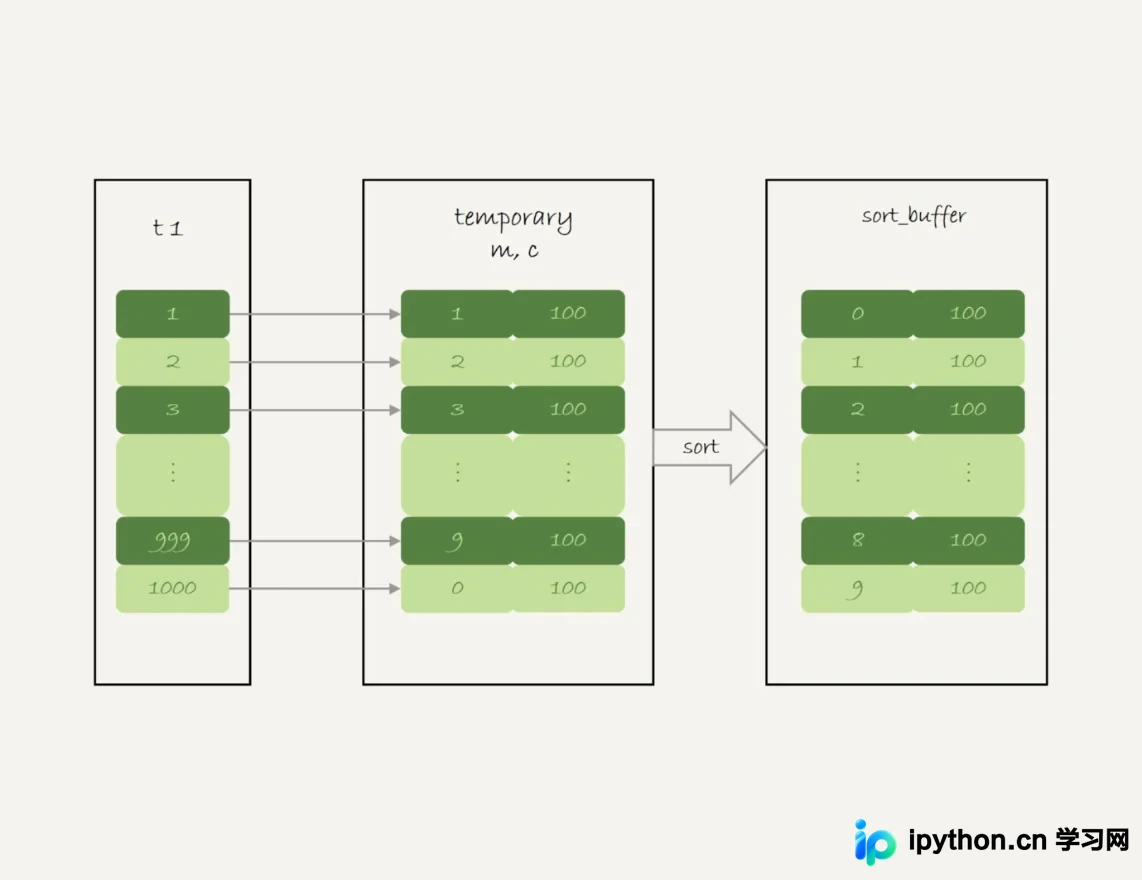
SHOW VARIABLES like '%tmp_table_size%';当查询语句较长,例如:SELECT id%10 AS m, COUNT(*) AS c FROM t1 GROUP BY m;,执行计划显示包含 Using temporary 和 Using filesort:
其背后的执行步骤为:
- 创建带有两个字段的内存临时表,以
m作为主键。 - 扫描原表索引
a获取所有id值。 - 对每一行的
id % 10结果进行哈希映射:若临时表中不存在该行则新建记录计为1,若存在则将计数累加。 - 遍历全部数据后,再根据主键
m进行排序(即filesort),将结果发回客户端。
2. 优化手段:跳过不必要的排序
如果在应用层不需要特定顺序的输出结果,可通过添加 ORDER BY NULL 强制关闭最后的排序过程,进而节省一部分 CPU 开销:
SELECT id%10 AS m, COUNT(*) AS c FROM t1 GROUP BY m ORDER BY NULL;此时 EXPLAIN 输出中 Using filesort 消失,但依然需要 Using temporary。
3. 内存不足时的退化与风险
当需要分组的基数(distinct key)较大,导致产生的临时表超出了 tmp_table_size 限制时,MySQL 会将内存临时表转换为基于磁盘的临时表。在较新的 MySQL 版本中可能默认退化为 InnoDB 引擎表。
这种操作不仅消耗大量 I/O,还可能因为长时间持有锁或占用空间而导致系统性能骤降。因此,控制数据量或改变算法是必要的防御手段。
内部临时表的针对性优化方案
针对上述问题,主要有两种优化路径:一是重构 SQL 利用现有索引消除临时表,二是使用 Hint 改变优化策略。此外还要留意DISTINCT 的特殊情况。
优化方案一:利用生成列构建索引
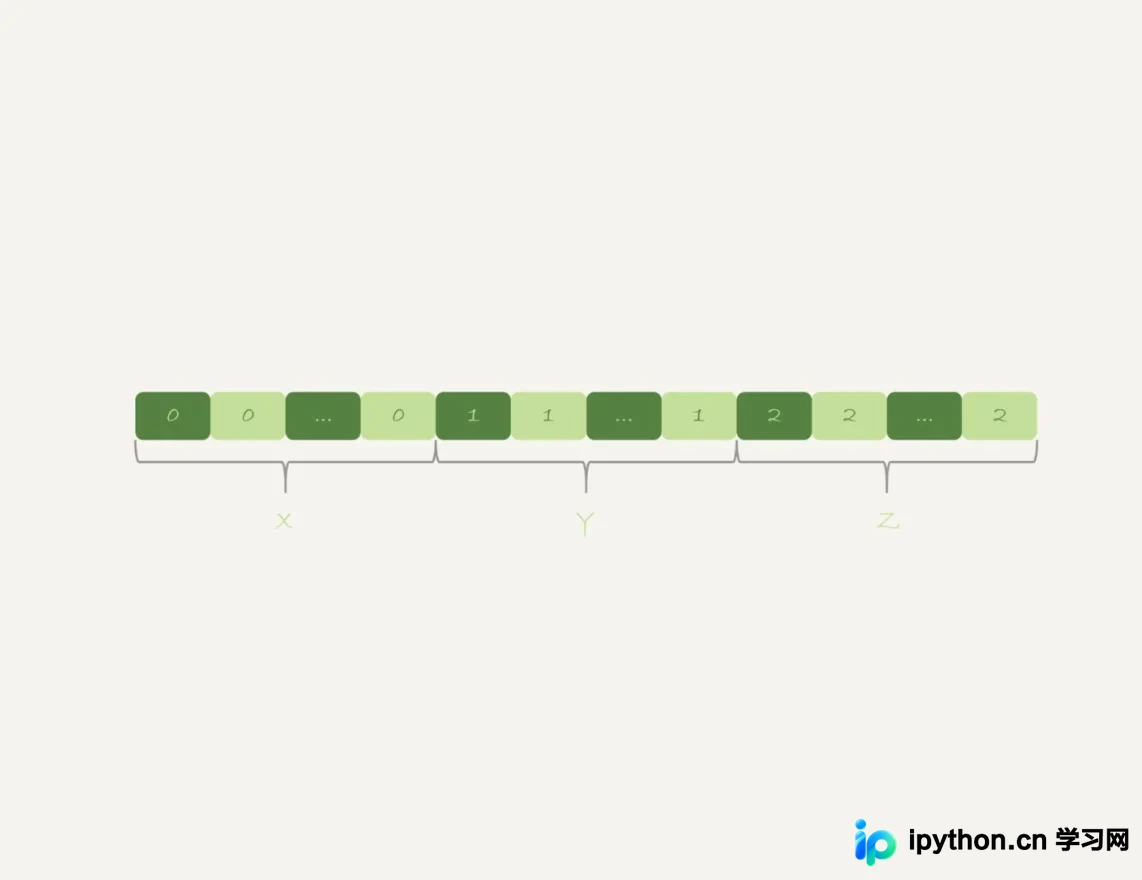
既然造成 GROUP BY 使用临时表的核心原因是“输入数据无序,无法直接顺次累加”,那么使数据前置有序就能规避此步骤。可以通过增加生成的虚拟列并在其上建立覆盖索引来解决:
-- 添加辅助列并使用索引
ALTER TABLE t1 ADD COLUMN z INT GENERATED ALWAYS AS(id % 100), ADD INDEX(z);再次查询时:SELECT z, COUNT(*) AS c FROM t1 GROUP BY z;,优化器将直接使用 index 类型的全索引扫描,彻底消除 Using temporary 与排序动作:
优化方案二:强制转为数组排序(SQL_BIG_RESULT)
对于数据量极大且不适合单纯依靠索引优化的巨型分组,可以主动告知优化器数据规模庞大,促使它放弃构造二维的临时表(B+树结构),转而直接在内存中使用连续内存块做线性扫描后再整体排序。
引入提示符 SQL_BIG_RESULT 即可达成目的:
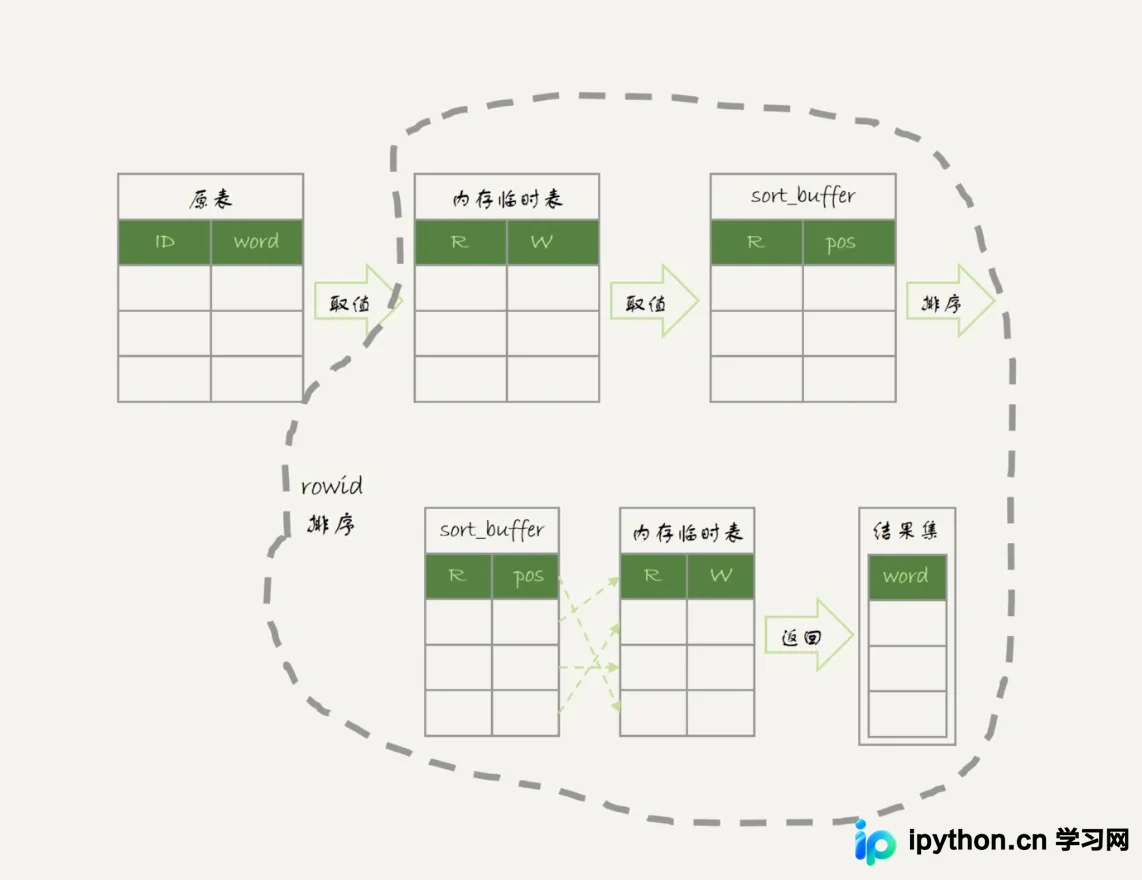
SELECT SQL_BIG_RESULT id%100 AS m, COUNT(*) AS c FROM t1 GROUP BY m;此时执行计划变更为 Using filesort 而不再显示 Using temporary,这表示优化器采用了类似外部排序的方式,将相关数据提取到 sort_buffer 中进行独立阵列排序。
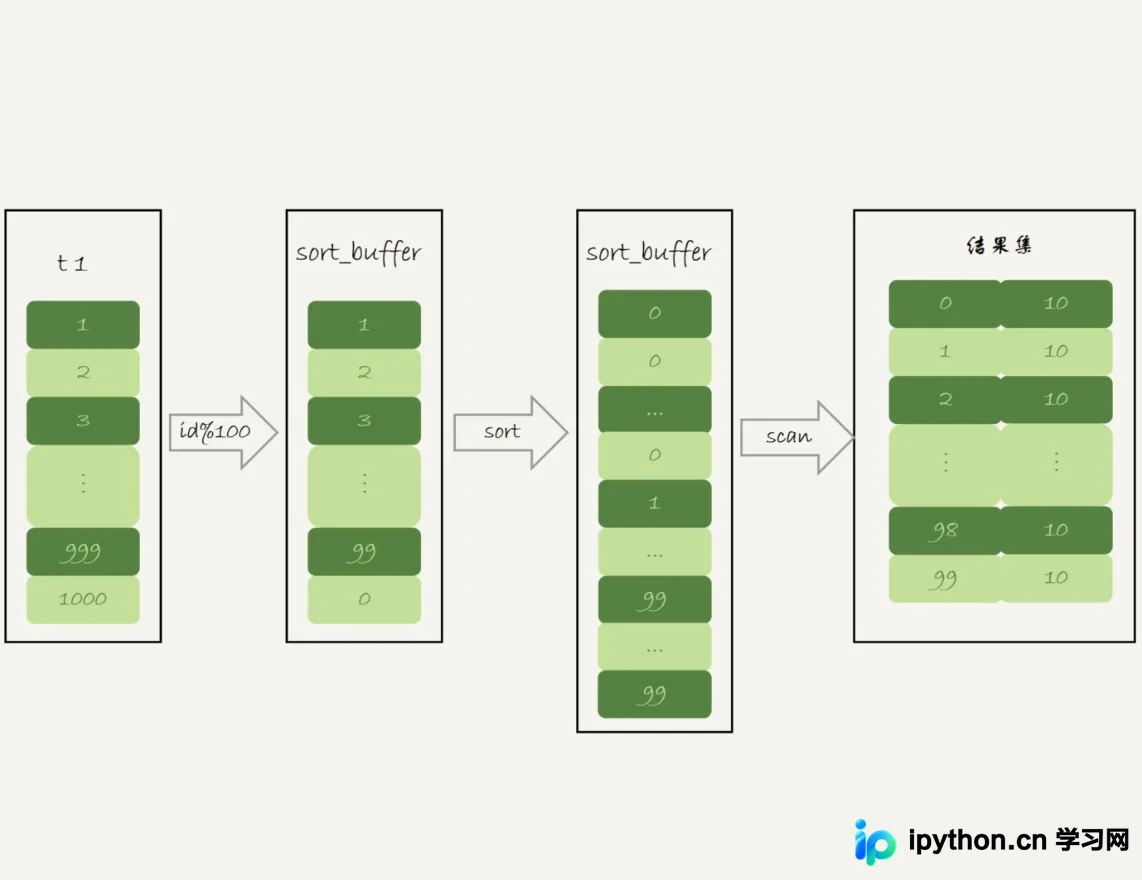
关于 DISTINCT 与 GROUP BY 的等价性
在标准 SQL 规范下,SELECT a, COUNT(*) FROM t GROUP BY a; 必须经过聚合运算。但如果去掉聚合函数变成 SELECT a FROM t GROUP BY a ORDER BY NULL;,其语义便与 SELECT DISTINCT a FROM t; 一致。这两类写法都会经历“建立唯一索引的临时表->查重->返回”的过程,在性能特征上属于同一梯队。
总结与最佳实践
综合以上分析,我们可以得出关于管理 MySQL 内部临时表的若干核心建议:
- 识别触发场景:凡是不能在一遍读取中完成输出的操作(如跨表 UNION、未走索引排序的 GROUP BY),都高度依赖临时表。
- 善用工具排查:日常运维务必检查
EXPLAIN中的Extra项。理想的查询应避免出现Using temporary和Using filesort。 - 减少排序代价:若业务允许结果任意序,请坚决在
GROUP BY末尾追加ORDER BY NULL以切断末端排序开销。 - 调整存储介质:尽量确保所需聚合的关键字范围保持在内存阈值内(调节
tmp_table_size)。倘若数据体量超出常规预估,不妨尝试使用SQL_BIG_RESULT引导优化器走高速排序通道而非笨重的磁盘建表。
以上就是MySQL内部临时表的具体使用及调优方案的详细内容,更多关于MySQL进阶优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















