


数据库性能压测:Sysbench与JMeter场景设计

明确压测目标与Sysbench、JMeter工具选型
数据库性能压测的核心目标在于量化系统在不同负载下的处理能力与稳定性,关键指标包括吞吐量、每秒查询数(QPS)、每秒事务数(TPS)、响应时间(RT)、并发用户数及错误率。其中QPS侧重读操作,TPS侧重事务型读写,P95与P99延迟反映长尾用户体验。工具选型需严格区分场景:Sysbench专为数据库内核基准测试设计,通过标准化OLTP模型直接评估数据库引擎的极限性能,适合硬件调优与版本对比;JMeter则擅长模拟真实业务链路,通过HTTP或JDBC协议构造复杂请求序列,验证应用层与数据库的协同表现。测试前需明确环境基线,例如采用CentOS 7.9、MySQL 8.0.32,配置16核32G服务器,初始化100万条基准数据,确保压测结果具备横向可比性。
使用Sysbench设计数据库基准压测场景
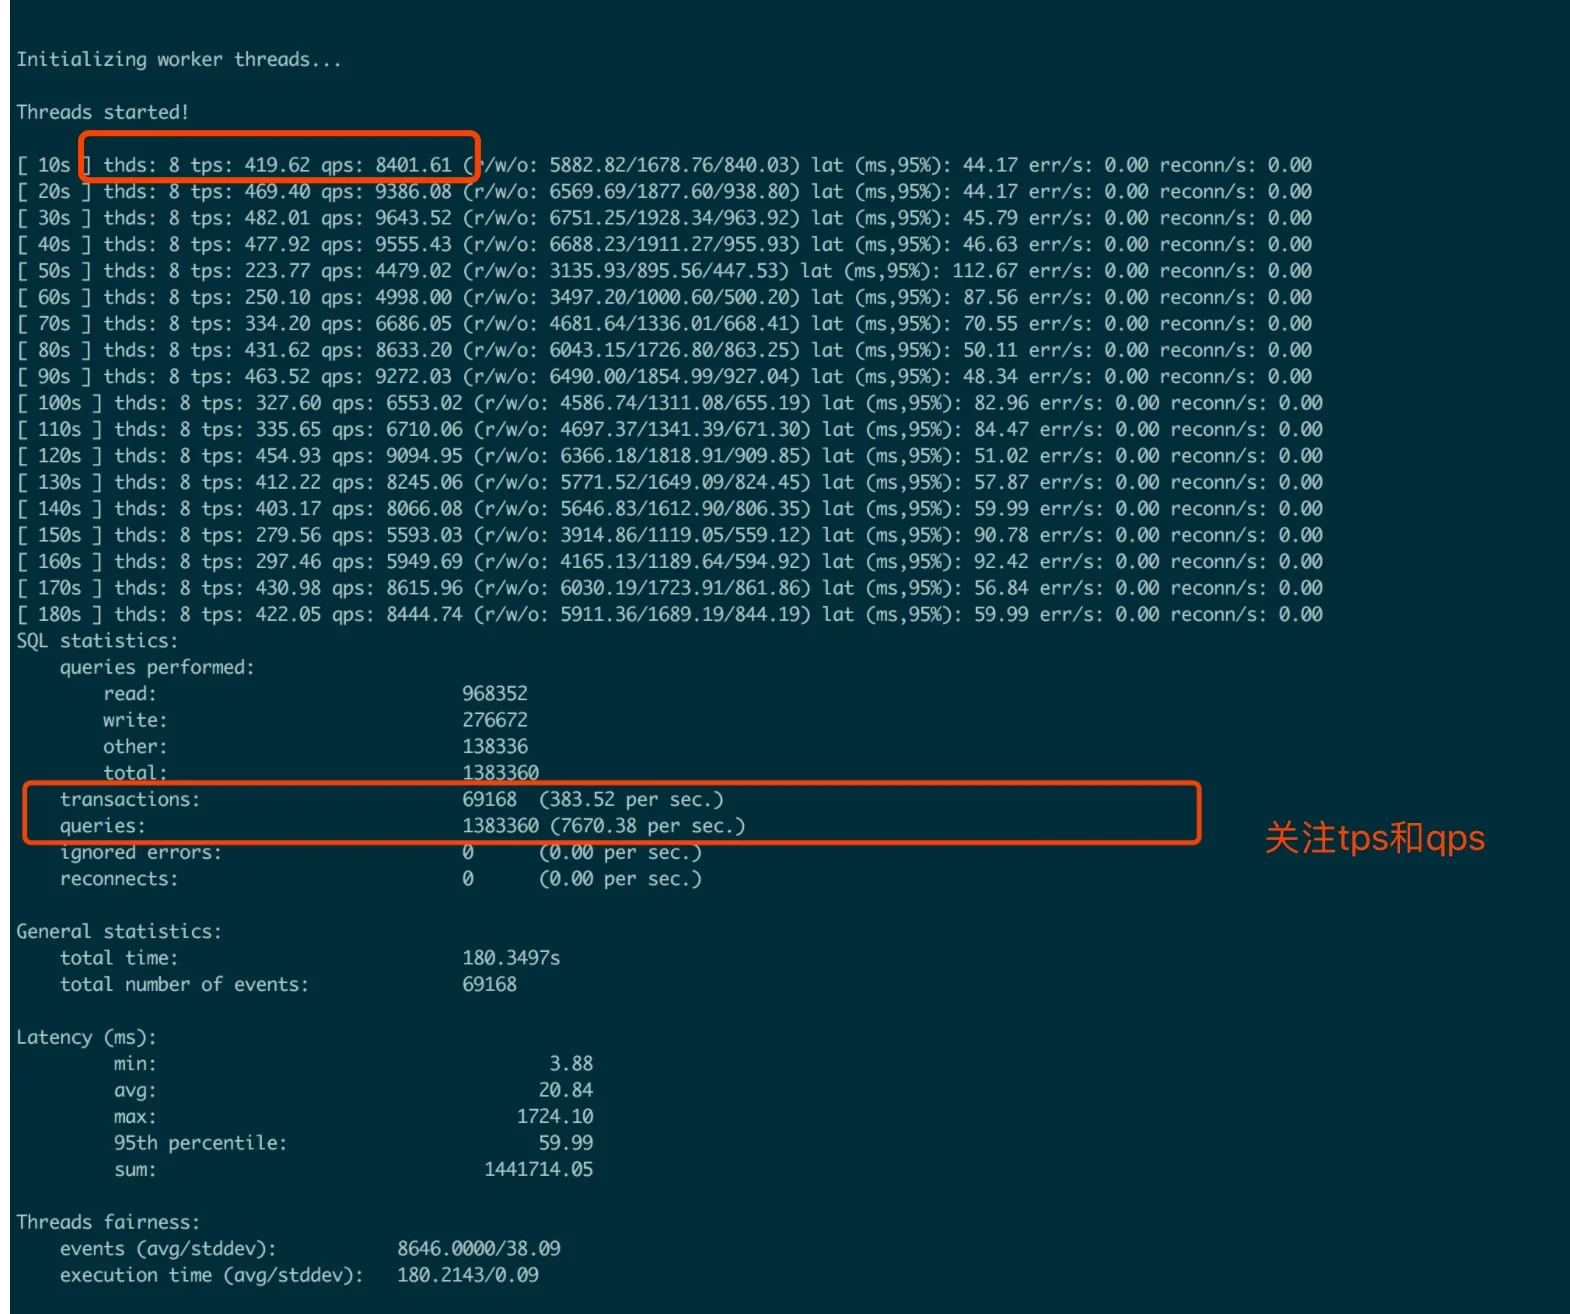
使用Sysbench进行基准压测需先通过包管理器安装并配置数据库连接。以MySQL为例,执行sysbench命令并绑定mysql-host、mysql-port、mysql-user等参数完成连接配置。数据准备阶段运行prepare命令生成指定数量的测试表与记录。场景设计聚焦OLTP混合读写,通过threads参数控制并发线程数,time设定压测时长,并开启report-interval实时输出。执行压测后,终端将逐段打印QPS、TPS、读写延迟及分位值。记录时需重点关注延迟分布与吞吐量曲线,若延迟随线程数呈指数上升而TPS停滞,即表明达到数据库处理瓶颈。
使用JMeter模拟真实业务数据库访问场景
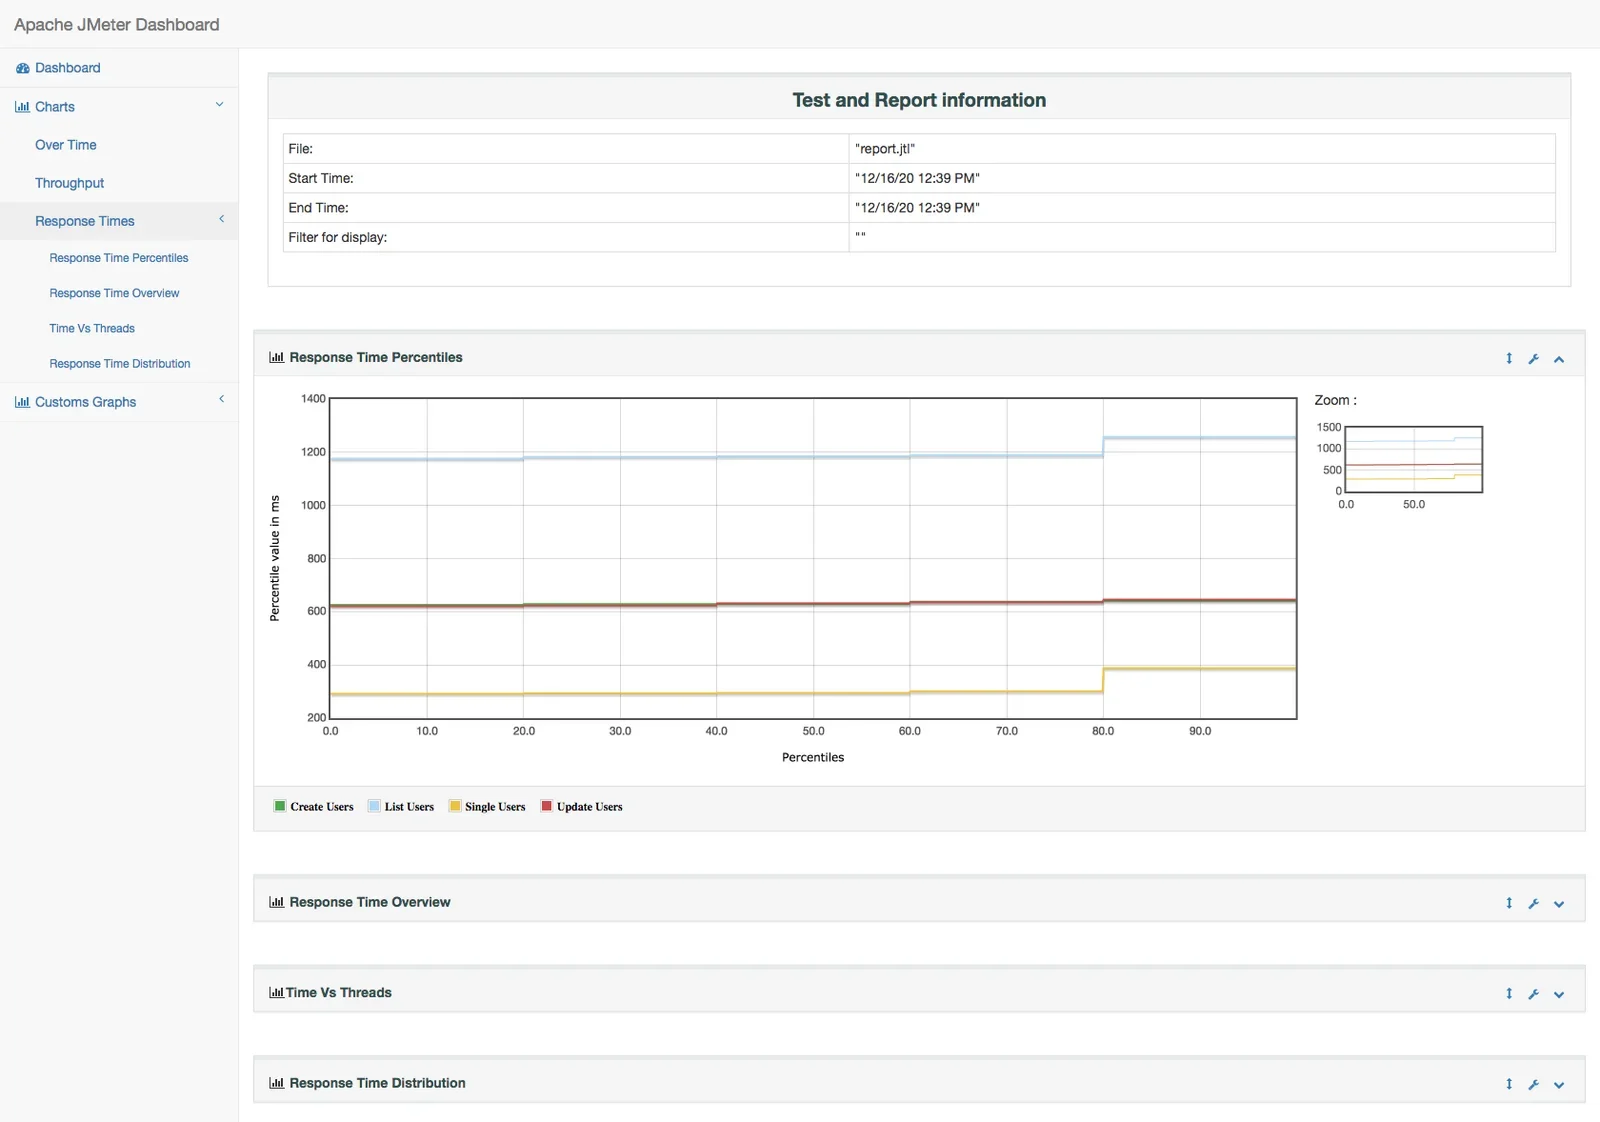
JMeter压测需围绕真实业务链路构建测试计划。首先创建线程组,设置并发用户数与Ramp-Up时间以模拟用户平滑接入,并设定循环次数或持续时间。通过添加JDBC连接配置组件绑定数据库连接池参数,随后使用JDBC Request编写SQL语句,或使用HTTP Request调用后端REST API。典型业务链路可设计为登录鉴权、商品查询与订单写入。直接JDBC压测跳过应用层,直接暴露数据库SQL执行效率,适合排查慢查询与索引失效;而通过应用接口压测则包含连接池分配、ORM映射等完整链路,更能反映生产环境真实负载。
执行压测并结合监控验证数据库性能
正式压测前必须执行数据预热与缓存处理,通过多次低并发请求将热点数据加载至内存缓存,避免冷启动导致的首次延迟虚高,并记录空闲状态下的基线指标。压测执行采用阶梯式递增策略,每阶段提升并发并稳定运行,观察吞吐量与延迟曲线,当TPS不再随并发增加而上升且延迟陡增时,即触及性能拐点。此时需联动监控体系验证瓶颈:观察CPU使用率是否饱和,检查磁盘IOPS与等待延迟,统计活跃连接数是否触达上限,并分析锁等待与行锁冲突。结合慢查询日志定位具体SQL,确保性能结论由多维指标交叉验证。
分析压测结果与常见避坑方法
压测结果分析需横向对比不同并发级别下的核心指标,绘制吞吐量与延迟的散点图。若延迟突破业务阈值且错误率攀升,需逐层排查连接池是否耗尽、SQL执行计划是否全表扫描、索引是否失效或应用层序列化耗时过长。常见避坑要点包括:数据量不足会导致缓存命中率虚高,需按生产比例生成海量数据;压测机自身资源瓶颈会限制发压能力,应使用分布式施压机;未清理系统缓存会导致结果不可复现;参数配置不一致会干扰对比结论。所有测试需固化脚本、环境与参数版本,确保结果可追溯。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















