


Python编写简易图书借阅管理系统实战指南

本文演示如何使用Python面向对象特性与内置模块开发一个命令行图书管理系统。通过构建数据模型与业务管理类,实现书籍信息录入、分类模糊查询、借阅归还状态流转及CSV本地存储同步功能,提供可直接运行的完整源码与逻辑解析。
系统目标与架构设计
该方案旨在解决基础书籍信息管理需求,核心功能包括一键查询全部或按作者/类别检索、新增书籍录入、借阅与归还的状态切换,以及底层数据的持久化保存。程序采用面向对象设计模式:Book类负责绑定每本书的具体属性(名称、作者、推荐语、类别、借阅状态),作为实例对象的模板;BookManager类则作为业务控制层,将菜单渲染、CRUD操作和文件读写方法封装在一起,便于统一调用与维护。
运行环境与准备条件
项目仅依赖Python标准库,无需安装第三方插件。运行前需确保以下基础环境就绪:
- Python 3.6 及以上版本(支持f-string语法更佳)
- 工作目录下准备名为
BookInfos.csv的数据源文件,表头格式建议为:书名,作者,推荐语,类别,状态(0未借出/1已借出) - 终端或IDE控制台支持标准输入输出交互
第1步:定义书籍数据模型
首先创建承载单本图书信息的类。使用 __init__ 初始化属性,并实现 __str__ 魔法方法以便直接打印时格式化显示借阅状态。同时预留子类接口,方便后续按“奇幻”“随笔”等分类扩展。
class Book:
    def __init__(self, name, author, recommendation, type, status=0):
        self.name = name
        self.author = author
        self.recommendation = recommendation
        self.status = status
        self.type = type

    def __str__(self):
        status_text = '已借出' if self.status == 1 else '未借出'
        return f'名称:《{self.name}》 作者:{self.author} 推荐语:{self.recommendation} 类别:{self.type} 状态:{status_text}'

# 分类子类示例(按需启用)
class FictionBook(Book):
    def __init__(self, **kwargs):
        super().__init__(type='奇幻', **kwargs)
第2步:管理系统初始化与CSV数据加载
主控制类 BookManager 在实例化时自动读取 BookInfos.csv,跳过表头并将每一行映射为 Book 实例存入列表。实际项目中CSV结构如下所示:
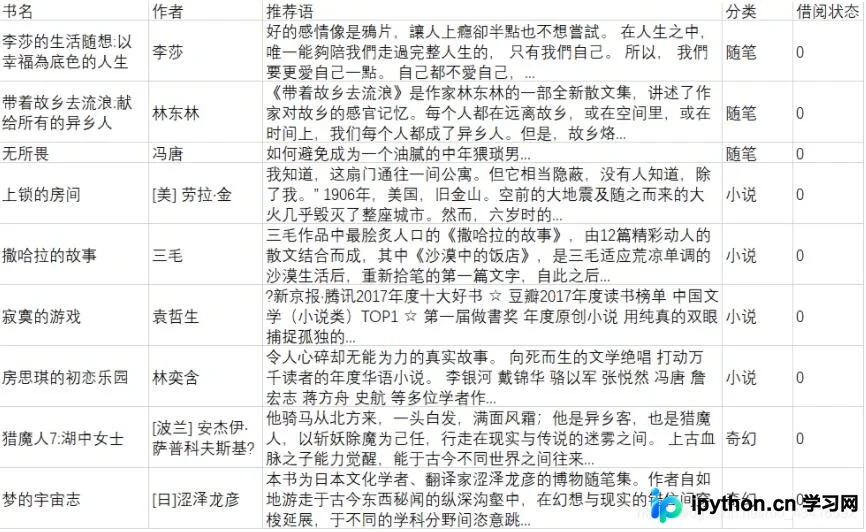
读取逻辑使用 csv.reader 逐行解析,确保内存中维护实时数据副本:
import csv
from itertools import islice

class BookManager:
    books = []

    def __init__(self):
        if not os.path.exists('BookInfos.csv'):
            print("提示:未检测到数据文件,系统将创建空表。")
            open('BookInfos.csv', 'w', newline='').close()

        with open('BookInfos.csv', 'r', encoding='utf-8') as f:
            readers = csv.reader(f)
            # 跳过第一行表头,读取剩余数据
            for row in islice(readers, 1, None):
                if row:  # 过滤空行
                    self.books.append(Book(row[0], row[1], row[2], row[3], int(row[4])))
第3步:实现菜单交互与核心业务逻辑
通过 while True 循环保持命令行常驻,根据用户输入分发至对应方法。核心操作入口与参数说明如下:
- 查询书籍:提供按作者名精确匹配、按类别筛选、全量打印三种选项
- 添加书籍:接收字符串输入后追加写入CSV末尾,同时更新内存列表
- 借阅/归还:校验书籍是否存在且状态允许,翻转
status值并触发底层文件同步
第4步:状态持久化与文件安全更新
为保证数据不丢失,修改借阅状态时需重写CSV文件。由于Python原生不支持随机访问特定单元格,此处采用安全的临时替换策略:
    @staticmethod
    def change_status(name):
        temp_path = "BookInfos_temp.csv"
        with open("BookInfos.csv", "r", encoding='utf-8') as in_f, \
             open(temp_path, "w", encoding='utf-8', newline='') as out_f:
            reader = csv.reader(in_f)
            writer = csv.writer(out_f)
            changed = False
            for row in reader:
                if row and row[0] == name:
                    current_st = int(row[4])
                    row[4] = str(int(not bool(current_st)))  # 0变1,1变0
                    changed = True
                writer.writerow(row)

        if changed:
            os.remove("BookInfos.csv")
            os.rename(temp_path, "BookInfos.csv")
            print("✅ CSV底层数据已同步更新")
        else:
            os.remove(temp_path)  # 清理无效临时文件
风险提示:覆盖原文件的写法在数据量极大时可能引发性能瓶颈或意外中断导致数据截断。生产环境建议改用关系型数据库(如SQLite)或增加备份机制。
完成判断与常见排错
运行 manager.menu() 后,若控制台正常输出欢迎语与数字菜单,且连续执行添加、查询、借阅、归还操作后 BookInfos.csv 内容实时反映状态变化,即表示系统部署完成。常见问题排查:
- NameError: name 'manager' is not defined:原代码在实例方法内误引用全局变量,已修正为
self.change_status()静态方法调用 - UnicodeDecodeError:CSV文件默认编码非UTF-8所致,读写时强制指定
encoding='utf-8' - 输入非整数报错:需在外层包裹
try...except ValueError捕获非法输入
简要总结
本文完整梳理了基于Python类体系与CSV轻量级存储的图书管理流程。通过模块化拆分数据实体与控制逻辑,清晰展示了面向对象编程在实际业务中的落地路径。代码已修复作用域隐患并优化文件写入安全,读者可直接复制运行并根据需求接入图形界面或网络请求进行二次开发。
以上就是基于Python类体系与CSV轻量级存储的图书管理流程的详细内容,更多关于Python桌面应用开发与自动化办公脚本的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















