


C语言带头双向循环链表接口实现详解与实战

带头双向循环链表是C语言数据结构中的高级组件,兼具操作灵活性与逻辑严密性。本文将深入剖析其结构特点,通过完整代码演示初始化、节点增删改查等核心接口的实现细节,并结合LeetCode真题讲解链表的算法实战应用。
为什么选择带头双向循环链表?
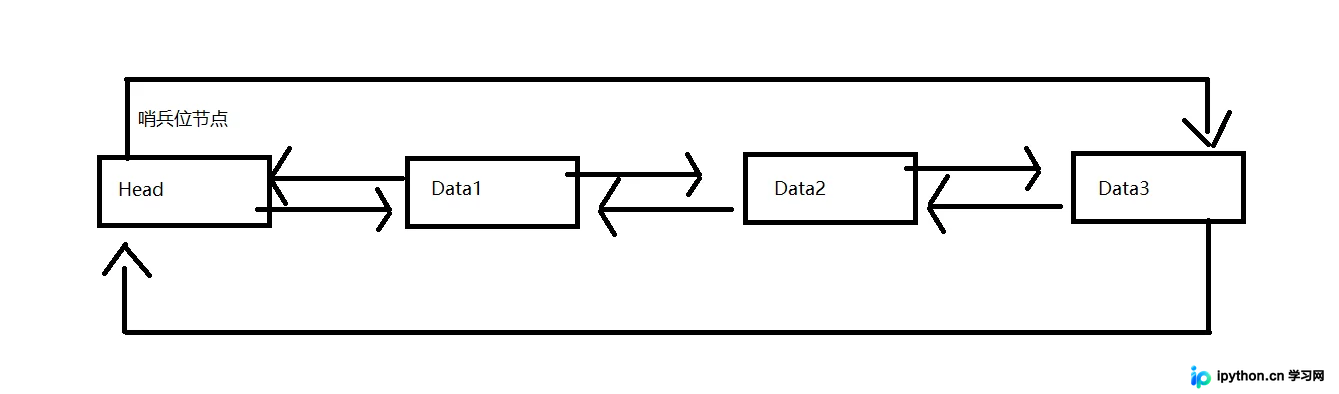
在常见的链表变体中(如单/双向、有头/无头、循环/非循环),带头双向循环链表因其特殊的结构设计,成为实际数据存储的首选方案。相较于其他结构,它解决了传统链表的诸多痛点:
- 简化边界处理:引入一个不存储有效数据的哨兵位头节点。这使得在进行头插或头删时,无需判断头指针是否为空,也无需传递二级指针,大幅降低了函数调用的复杂度。
- 双向遍历能力:每个节点包含指向前驱(
prev)和后继(next)的两个指针,支持双向高效移动。 - 无缝首尾衔接:最后一个节点的
next指向第一个节点,第一个节点的prev指向最后一个节点,形成闭环,便于全表遍历。
第1步:定义链表数据结构的类型
目的:明确节点的基本构成,为后续内存分配建立类型基础。
入口:<stdio.h>, <stdlib.h>
动作:使用 typedef 定义数据类型和节点结构体。通常将通用数据定义为 DataType,以便后续修改扩展性;每个节点需包含数据域及前后指针。
typedef int DataType;
typedef struct DListNode
{
	DataType data;       // 数据域
	DListNode* prev;     // 前驱指针
	DListNode* next;     // 后继指针
}DListNode;
第2步:完成带头双向循环链表的初始化
目的:创建哨兵位头节点,并使其自身的前后指针相互指向,确立环形状态。
操作说明:有两种常见写法,推荐使用返回节点地址的方式,语义更清晰且调用方便。
DListNode* DListInit()
{
	// 1. 为哨兵位申请内存
	DListNode* phead = (DListNode*)malloc(sizeof(DListNode));
	if (phead == NULL) {
		return NULL;
	}
	// 2. 关键步骤:初始化成环
	phead->next = phead;
	phead->prev = phead;
	return phead;
}
第3步:封装新节点创建函数
目的:统一内存申请逻辑,降低业务代码的重复率。
DListNode* BuyDListNode(DataType x)
{
	DListNode* temp = (DListNode*)malloc(sizeof(DListNode));
	if (temp == NULL) {
		printf("malloc fail\n");
		exit(-1);
	}
	// 初始化为独立节点时,先置为空指针是个好习惯,避免野指针
	temp->prev = NULL;
	temp->next = NULL;
	temp->data = x;
	return temp;
}
第4步:实现头插与尾插操作
目的:学习如何维护环形结构的链接关系。由于存在哨兵位,插入过程不需要判断链表是否为空。
头插逻辑:在哨兵位和原第一个数据节点之间插入新节点。
void DListPushFront(DListNode* phead, DataType x)
{
	DListNode* newnode = BuyDListNode(x);
	DListNode* firstNode = phead->next;

	// 1. 新节点连接后方(原第一个节点)
	firstNode->prev = newnode;
	newnode->next = firstNode;
	// 2. 新节点连接前方(哨兵位)
	newnode->prev = phead;
	phead->next = newnode;
}尾插逻辑:在原链表最后一个节点(即哨兵位的前驱)与哨兵位之间插入。
void DListPushBack(DListNode* phead, DataType x)
{
	DListNode* newnode = BuyDListNode(x);
	DListNode* tail = phead->prev;

	tail->next = newnode;      // 尾节点的后继指向新节点
	newnode->prev = tail;      // 新节点的前驱指向尾节点
	newnode->next = phead;     // 新节点的后继指向哨兵位(闭合环路)
	phead->prev = newnode;     // 哨兵位的前驱更新为新节点(新的尾部)
}
第5步:实现删除与查找接口
目的:掌握安全的内存释放与定位策略。带头双向循环链表在删除特定节点时无需传入头指针,因为可以通过节点自身的指针直接断开连接。
查找函数:遍历直到回到哨兵位或找到目标值。
DListNode* DListNodeFind(DListNode* phead, DataType x)
{
	DListNode* cur = phead->next;
	while (cur != phead)
	{
		if (cur->data == x) return cur;
		cur = cur->next;
	}
	return NULL;
}删除指定位置节点:利用 pos->prev 和 pos->next 即可完成局部断开,最后释放内存。
void DListNodeErase(DListNode* pos)
{
	if (!pos) return;
	DListNode* prev = pos->prev;
	DListNode* next = pos->next;

	prev->next = next;   // 左侧节点跳过当前节点
	next->prev = prev;   // 右侧节点跳过当前节点
	free(pos);           // 安全释放
	pos = NULL;          // 防止悬垂指针
}
在线OJ实战与应用场景
掌握底层结构后,应将其应用于解决实际问题。以 “寻找链表的中间节点” 为例(LeetCode 876),虽然题目针对普通单向链表,但其解题思路完全依赖对指针运动规律的深刻理解。
核心思路:采用快慢指针法。设置两个指针同时出发,快指针每次走两步,慢指针每次走一步。当快指针到达终点时,慢指针恰好位于链表正中间。
struct ListNode* middleNode(struct ListNode* head)
{
    struct ListNode* fast = head;
    struct ListNode* slow = head;
    while(fast && fast->next)
    {
        fast = fast->next->next; // 快指针一次两跳
        slow = slow->next;       // 慢指针一次一跳
    }
    return slow; // 此时slow即为中间节点
}
总结与避坑指南
- 画图辅助:在涉及复杂的指针断链、重连时(尤其是头删、尾删),务必先在纸上画出四个核心方向(上、下、左、右)的连线变化,确认无误后再写代码。
- 理解左右值:对于链表节点
phead->next,作为左值时表示修改该成员变量(修改指针指向),作为右值时则表示获取下一个节点的地址。 - 健壮性检查:在实现删除功能前,务必检查链表长度。例如
PopFront时若发现head->next == head,说明链表仅剩哨兵位,直接返回即可,避免非法访问。 - 优势验证:看似最复杂的数据结构,在使用了其特有的“哨兵位+双向+循环”特性后,往往能通过消除大量的
if-else分支判断,反而让核心逻辑更加简洁紧凑。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















