


C语言静态链表与动态链表核心区别及实现

在C语言编程中,链表是处理批量数据的核心数据结构。理解静态链表与动态链表的区别,关键在于内存分配方式:前者使用编译期或运行前固定的内存块,后者依赖堆区动态分配。本文将通过实例代码图解两者的实现逻辑、存储结构及操作差异,帮助开发者掌握何时使用何种链表以优化内存效率。
结果与目标:明确链表类型选择
在处理线性数据集合时,数组虽然简单但长度固定且可能浪费空间。链表通过节点间的指针链接解决了这一问题。我们的目标是厘清以下两种主要形式的适用场景:
- 静态链表:适用于节点数量确定、生命周期固定的简单场景。
- 动态链表:适用于节点数量不确定、需要频繁增删改查的复杂应用场景。
准备条件:理解“引用自身的结构体”
无论是静态还是动态链表,其基础单元都是包含数据域和指针域的结点。C语言允许结构体成员中包含指向自身类型的指针,这是构建链表的基石。
第1步:定义链表结点结构
目的:建立能够自我引用的数据结构。
入口:C语言标准库及自定义结构体。
动作:创建一个结构体,其中至少包含一个成员变量用于存储数据,以及一个类型为指向该结构体自身的指针变量用于连接下一个结点。
struct link
{
    char ch;              // 数据域
    struct link *p;       // 指针域,指向同类型结构体
} a;在上述代码中,a.p = &a 是合法表达式,因为 p 可以指向任何 struct link 类型的变量地址。这种结构使得多个同类型结构体变量可以通过指针相互串联。
真实操作顺序:构建静态链表
静态链表的所有结点在程序启动前或定义时已由系统分配固定的内存空间。即使它们在内存在上不连续,也无法在运行时新增或删除结点。
第2步:初始化静态链表节点
目的:将预先定义的多个独立结点串联成链。
入口:主函数 main()。
动作:
- 定义三个
NODETYPE结构的变量a,b,c作为链表的头、中、尾节点。 - 为每个节点的
data成员赋值。 - 通过指针赋值建立连接:
a.next = &b,b.next = &c。 - 将尾节点的指针置为空(
'\0'或NULL),标识链表结束。
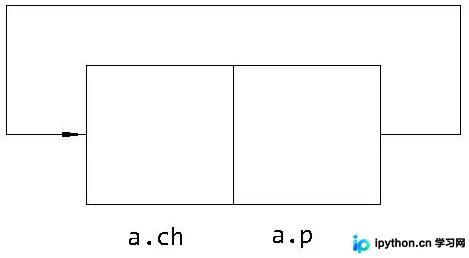
图1 引用自身的结构体示意图,展示指针如何指向同类对象
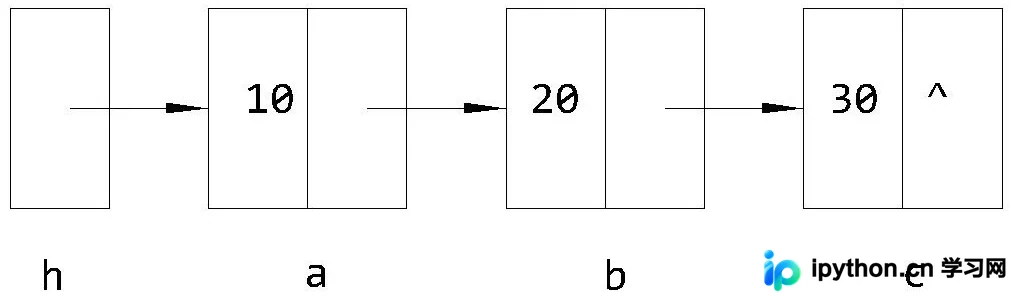
图2 静态链表存储结构示意图,显示节点a->b->c的物理分布
以下是完整的静态链表创建与遍历代码示例:
#include <stdio.h>

struct node
{
  int data;
  struct node *next;
};
typedef struct node NODETYPE;

int main()
{
  // a是头结点,b是中间节点,c是尾节点
  // h是基类型为NODETYPE的指针,指向头结点
  // p是基类型为NODETYPE的指针,用于遍历链表
  NODETYPE a, b, c, *h, *p;

  // 给变量中的data赋值
  a.data = 10;
  b.data = 20;
  c.data = 30;

  // 将节点相连
  h = &a;        // 头指针指向第一个节点
  a.next = &b;   // 头节点指向第二个节点
  b.next = &c;   // 第二个节点指向第三个节点
  c.next = '\0';  // 尾节点指针置空

  // 移动p,使之依次指向a、b、c,输出它们data中的值
  p = h;
  while (p) // 当p不为空时循环
  {
    printf("%d\t", p->data);
    p = p->next;  // p顺序后移
  }
  printf("\n");
  return 0;
}
第3步:判断静态链表完成状态
重要参数:尾节点的 next 必须为 NULL 或 '\0'。
可观察的完成状态:程序输出依次为 10 20 30,且无内存泄漏(因为使用的是栈内存或全局内存,无需手动释放)。
真实操作顺序:构建动态链表概念
与静态链表不同,动态链表在程序执行过程中根据需要随时开辟存储空间(通常使用 malloc 或 calloc),不需要时再释放(free)。这使得链表长度不受初始定义限制,但管理复杂度增加。
第4步:理解动态链表的指针维系
目的:确保节点间逻辑顺序不因内存动态分配而断裂。
入口:动态内存分配函数。
动作:
- 每个新节点没有预定义的名字,只能靠指针对接。
- 设置“头指针”
head,始终指向链表的第一个节点。 - 可选设置“头结点”(dummy head),其数据域可不存数据,仅用于统一插入删除逻辑;也可不设,直接让
head指向第一个有效数据节点。
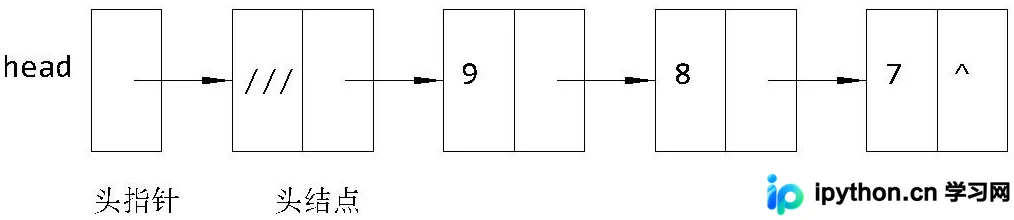
图3 带有头结点的单向动态链表结构
关键强调:动态链表中,如果某个节点的指针被意外修改导致“断开”,后续所有节点将因失去访问路径而无法回收,造成内存泄漏。因此,维护指针的连续性是动态链表编程的核心挑战。
完成判断与排错
如何区分两者?
静态链表:节点是普通变量(如 NODETYPE a, b, c),生命周期由作用域决定,无法在运行时动态增减。
动态链表:节点是动态分配的内存块(如 NODETYPE *newNode = malloc(...)),生命周期需手动管理,可无限扩展(受限于内存大小)。
常见错误排查
- 断链:在插入或删除节点时,忘记更新相邻节点的指针,导致链表断裂。
对策:先挂后解(先让新节点连上后继,再让前驱连上新节点)。 - 空指针引用:遍历时未检查
NULL,访问了尾节点的next。
对策:循环条件务必包含while (p != NULL)。 - 内存泄漏:动态分配的节点在程序退出前未被
free。
对策:在程序结束或不再需要链表时,遍历并释放所有节点。
简要总结
C语言链表通过指针将离散内存组织成有序序列。静态链表适合小规模、固定长度的数据,结构简单稳定;动态链表适合大规模、变化频繁的数据,灵活高效但需谨慎管理内存。理解struct node *next的自引用机制及头尾指针的处理,是掌握这两种链表的关键。以上就是C语言静态链表和动态链表详细内容,更多关于C语言数据结构优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















