


详解Python查找算法的实现(线性,二分,分块,插值)

本文深入解析Python中四种常见查找算法的实现与性能。涵盖线性查找及其前哨站优化、二分查找的递归与迭代实现、插值查找对中间位置的改进,以及分块查找的索引构建。详细分析各算法的时间复杂度、适用场景及优缺点,并提供完整代码示例与优化建议。
查找算法旨在从序列数据(即数据集)中检索特定数据(即关键字)是否存在。常见的查找算法包括以下几种:
- 线性查找:亦称顺序查找,适用于无序数列的查找场景。
- 二分查找:亦称折半查找,专门用于有序数列的查找。
- 插值查找:作为二分查找算法的改进版本。
- 分块查找:又称索引顺序查找,是对线性查找的优化改进。
- 树表查找:包含二叉查找树和平衡二叉树查找等类型。
- 哈希查找:通过关键字直接定位所需数据。
鉴于树表查找和哈希查找的内容篇幅较长,本文暂不展开。本文将重点详解除这两类之外的其他查找算法,逐一分析其优缺点,并探讨相应的优化方案。
1. 线性查找
线性查找,又称顺序查找,是一种基础、穷举式的暴力查找算法。其逻辑简单,易于理解和编码实现。然而,当数据量庞大时,由于其朴素穷举的思想且缺乏优化设计,算法性能往往较低。
线性查找的核心思想如下:
- 从列表头部开始,逐一扫描原始列表中的每个数据元素,并将其与给定的关键字进行比较。
- 若发现两者相等,则判定查找成功。
- 若扫描完整个列表仍未找到与关键字相等的数据,则判定查找失败。
基于上述算法描述,可以很容易地编写代码实现:
'''
线性查找算法
参数:
    nums: 序列
    key:关键字
返回值:
    关键字在序列中的位置
    如果没有,则返回 -1
'''
def line_find(nums, key):
    for i in range(len(nums)):
        if nums[i] == key:
            return i
    return -1
'''
测试线性算法
'''
if __name__ == "__main__":
    nums = [4, 1, 8, 10, 3, 5]
    key = int(input("请输入要查找的关键字:"))
    pos = line_find(nums, key)
    print("关键字 {0} 在数列的第 {1} 位置".format(key, pos))
'''
输出结果:
请输入要查找的关键字:3
关键字 3 在数列的 4 位置
'''
接下来分析线性查找算法的平均时间复杂度。
1. 最佳情况:若目标关键字恰好位于数列的第 1 个位置,则仅需查找 1 次即可成功。
例如,在数列=[4,1,8,10,3,5]中查找关键字 4。
此时仅需查找 1 次。
2. 最坏情况:直到扫描到数列尾部时才找到关键字。
例如,在数列=[4,1,8,10,3,5]中查找是否存在关键字 5。
此时查找次数等于数列长度,本例中为 6 次。
3. 一般情况:若关键字位于数列中间某位置,其被查找到的概率为 1/n 。
其中 n 代表数列的长度。
线性查找的平均查找次数计算公式为 (1+n)/2。转换为大 O 表示法,其时间复杂度为 O(n) 。
在大 O 表示法中,常数项通常被忽略。
线性查找的最坏情况是:扫描完整整个数列后,仍未找到目标关键字。
例如,在数列=[4,1,8,10,3,5]中查找是否存在关键字 12。
经过 6 次扫描后,查找失败。
改良线性查找算法
可以对线性查找进行优化,例如引入“前哨站”机制。所谓“前哨站”,即在查找开始前,将待查找的关键字插入到数列的尾部。
def line_find_(nums, key):
    i = 0
    while nums[i] != key:
        i += 1
    return -1 if i == len(nums)-1 else i

'''
测试线性算法
'''
if __name__ == "__main__":
    nums = [4, 1, 8, 10, 3, 5]
    key = int(input("请输入要查找的关键字:"))
    # 查找之前,先把关键字存储到列到的尾部
    nums.append(key)
    pos = line_find_(nums, key)
    print("关键字 {0} 在数列的第 {1} 位置".format(key, pos))
使用“前哨站”优化后的线性查找算法,其时间复杂度并未改变,仍为 O(n)。从 2 版本的代码来看,改动也不大。
但从实际运行角度看,第 2 种方案减少了 if 判断指令的执行次数,从而减少了编译后的指令数量,进而降低了 CPU 执行指令的总次数。这种优化属于微优化,而非算法本质上的复杂度优化。
使用计算机编程语言编写的代码属于伪指令代码。
经过编译处理后生成的指令代码称为 CPU 指令集。
一种优化思路即在于减少编译后生成的指令集大小。
2. 二分查找
二分查找属于有序查找算法,意味着被查找的数列必须是有序的。例如,在数列=[4,1,8,10,3,5,12]中查找关键字 4,由于数列无序,无法直接使用二分查找;若需使用,必须先对数列进行排序。
二分查找运用了二分(折半)算法思想,其算法执行过程中需随时获取两个关键信息:
- 一是数列的中间位置 mid_pos。
- 二是数列中间位置对应的值 mid_val。
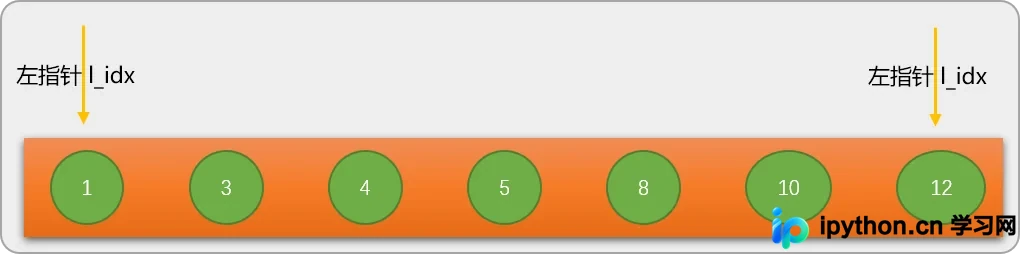
现在通过数列 nums=[1,3,4,5,8,10,12] 中查找关键字 8 来演示二分查找的流程。
在开始二分查找前,先定义两个位置(指针)变量:
- 左指针 l_idx 初始指向数列的最左侧元素。
- 右指针 r_idx 初始指向数列的最右侧元素。
第 1 步:通过左、右指针的当前位置计算出数列的中间位置 mid_pos=3,并根据 mid_pos 的值找出数列中间位置所对应的值 mid_val=nums[mid_pos],即 5。
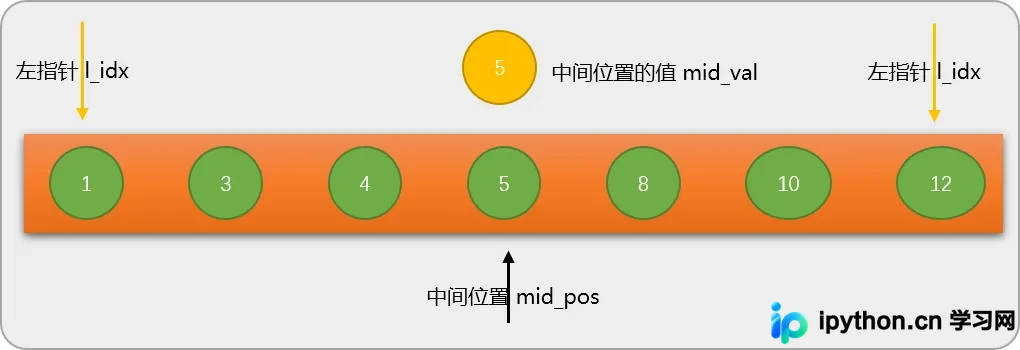
二分查找的核心在于确定数列中间位置的值。
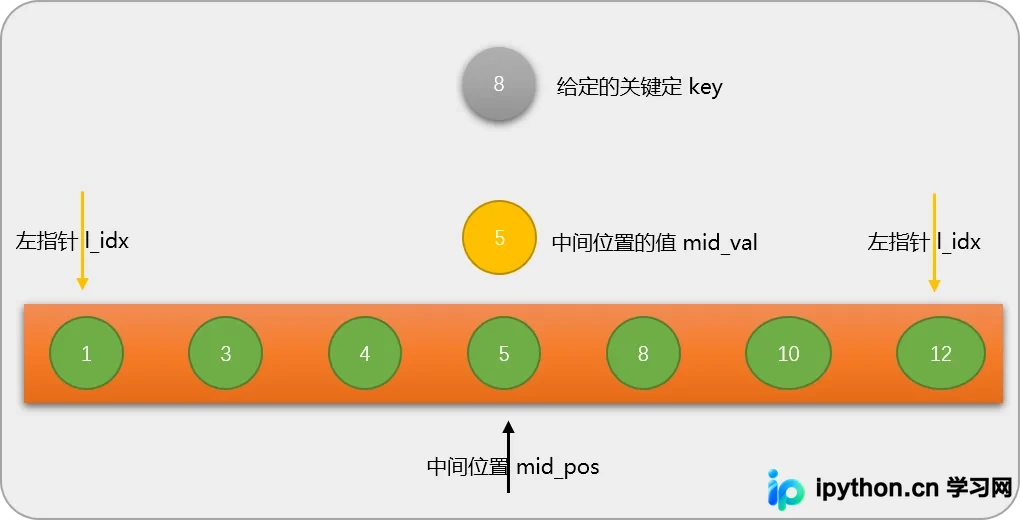
第 2 步:将数列中间位置的值与给定关键字进行比较。此处关键字为 8,中间位置值为 5。显然 8 大于 5,由于数列有序,无需再与数列中 5 之前的数字比较,只需专注于与 5 之后的数字比较。
经过一次比较后,待查找的数列范围缩小了一半,这也是二分算法名称的由来。
第 3 步:根据比较结果调整数列范围。这里的调整并非物理结构上的改变,而是逻辑上的调整,原数列保持不变。即通过修改左指针或右指针的位置,在逻辑上缩小数列范围。调整后的数列如图所示。
二分查找中,数列的范围由左指针到右指针的长度决定。
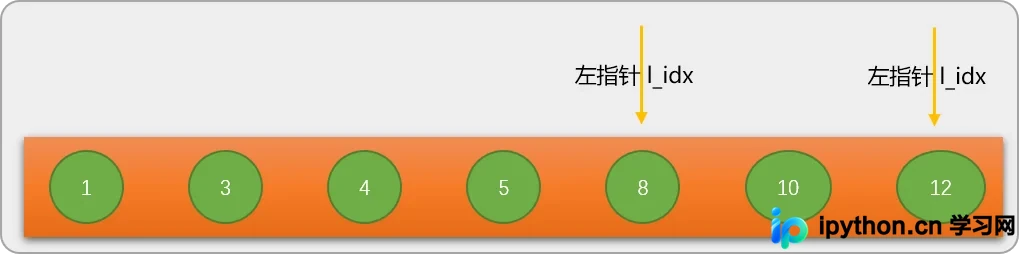
第 4 步:重复上述步骤,直到找到目标或确定不存在为止。
编码实现二分查找算法
'''
二分查找算法
'''
def binary_find(nums, key):
    # 初始左指针
    l_idx = 0
    # 初始在指针
    r_ldx = len(nums) - 1
    while l_idx <= r_ldx:
        # 计算出中间位置
        mid_pos = (r_ldx + l_idx) // 2
        # 计算中间位置的值
        mid_val = nums[mid_pos]
        # 与关键字比较
        if mid_val == key:
            # 出口一:比较相等,有此关键字,返回关键字所在位置
            return mid_pos
        elif mid_val > key:
            # 说明查找范围应该缩少在原数的左边
            r_ldx = mid_pos - 1
        else:
            l_idx = mid_pos + 1
    # 出口二:没有查找到给定关键字
    return -1

'''
测试二分查找
'''
if __name__ == "__main__":
    nums = [1, 3, 4, 5, 8, 10, 12]
    key = 3
    pos = binary_find(nums, key)
    print(pos)
基于前述二分算法流程分析,可知二分查找的子问题与原始问题逻辑一致,因此可以使用递归方式实现:
'''
递归实现二分查找
'''
def binary_find_dg(nums, key, l_idx, r_ldx):
    if l_idx > r_ldx:
        # 出口一:没有查找到给定关键字
        return -1
    # 计算出中间位置
    mid_pos = (r_ldx + l_idx) // 2
    # 计算中间位置的值
    mid_val = nums[mid_pos]
    # 与关键字比较
    if mid_val == key:
        # 出口二:比较相等,有此关键字,返回关键字所在位置
        return mid_pos
    elif mid_val > key:
        # 说明查找范围应该缩少在原数的左边
        r_ldx = mid_pos - 1
    else:
        l_idx = mid_pos + 1
    return binary_find_dg(nums, key, l_idx, r_ldx)
'''
测试二分查找
'''
if __name__ == "__main__":
    nums = [1, 3, 4, 5, 8, 10, 12]
    key = 8
    pos = binary_find_dg(nums, key,0,len(nums)-1)
    print(pos)
接下来分析二分查找的性能。
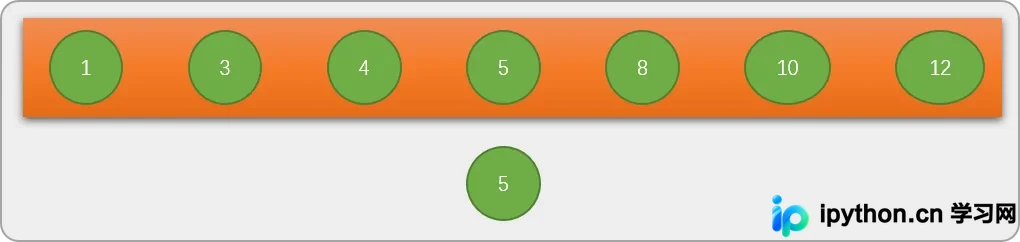
二分查找的过程用树形结构描述更为直观,搜索结束后绘制的树结构是一棵二叉树。
1. 如上述代码执行过程,先找到数列中的中间数字 5,随后以 5 为根节点构建唯一结点树。
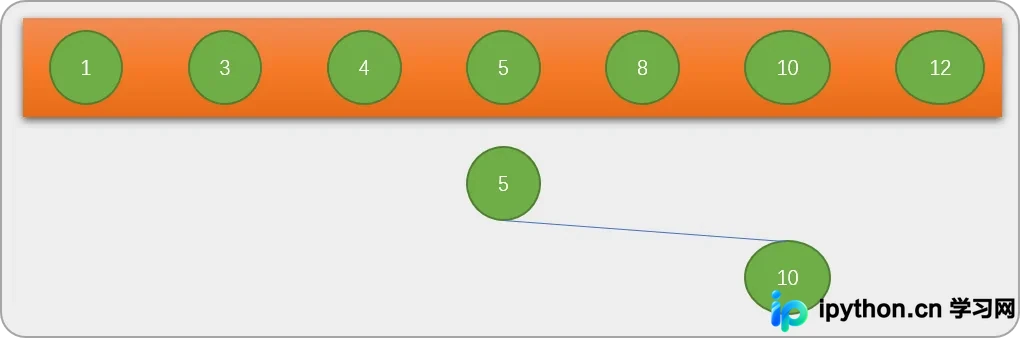
2. 5 与关键字 8 比较后,再在以数字 5 为分界线的右侧数列中找到中间数字 10,树形结构变为下图所示。
3. 10 与关键字 8 比较后,再在 10 的左侧继续查找。
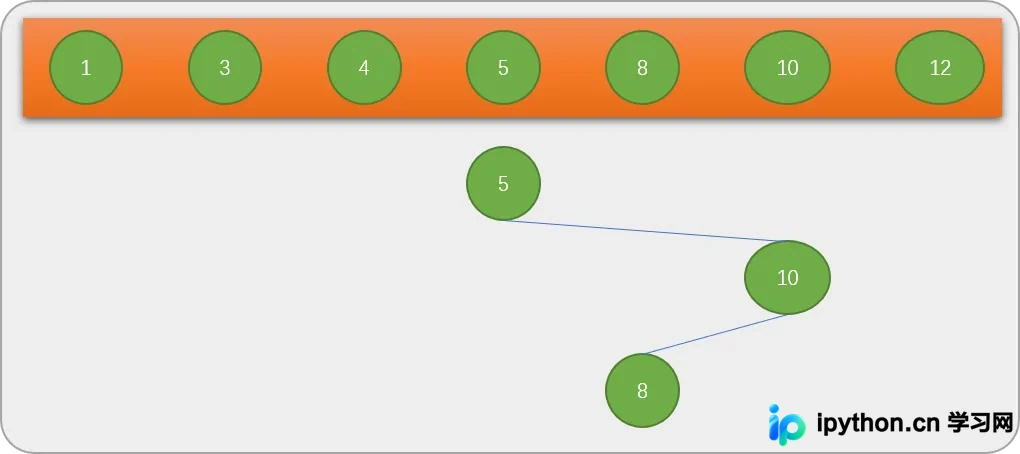
查找到 8 后,意味着二分查找已找到结果,仅需 3 次即可查找到最终结果。
从二叉树结构可直观得出结论:二分查找关键字的比较次数由关键字在二叉树结构中的深度决定。
4. 上述示例查找的是给定数字 8。为了能够查找数列中的任意数字,最终完整的树结构应如下图所示。
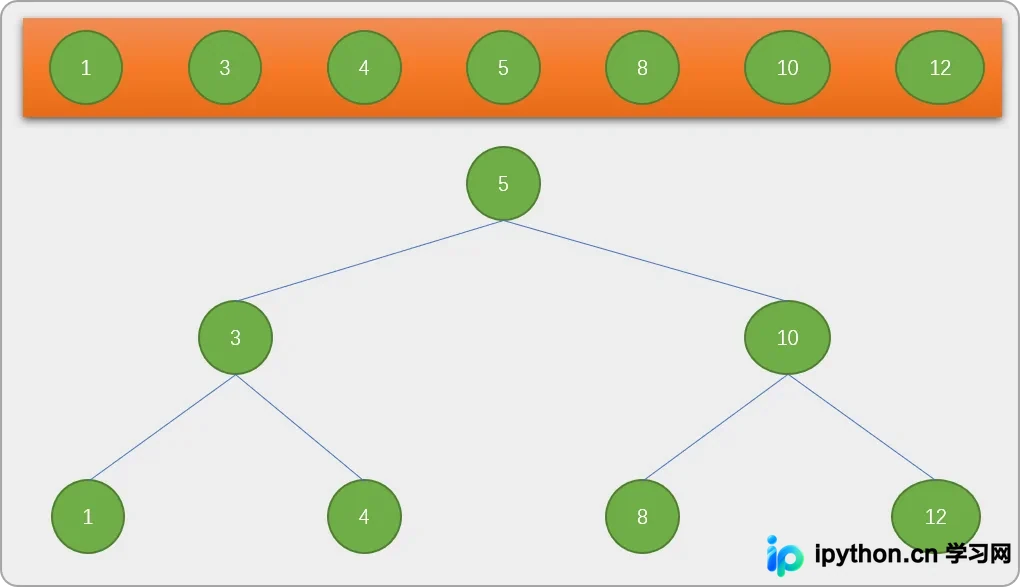
显然,该树结构是标准的二叉树。从树结构可以看出,无论查找任何数字,最少需要 1 次,如查找数字 5;最多也只需 3 次,这比线性查找快得多。
根据二叉树特性,结点数为 n 的树的深度为 h=log2(n+1),因此二分查找算法的大 O 表示时间复杂度为 O(logn),属于对数级别的时间复杂度。
当对长度为 1000 的数列进行二分查找时,所需次数最多只要 10 次,二分查找算法的效率显然高效。
然而,二分查找要求数列提前排序,前述时间复杂度未考虑排序时间。因此,二分查找通常适用于数据变化稳定的有序数列。
3. 插值查找
插值查找本质上是二分查找,其对二分查找算法中计算中间位置的逻辑进行了改进。
原生二分查找算法中计算中间位置的逻辑为:中间位置等于左指针位置加上右指针位置然后除以 2。
    # 计算中间位置
    mid_pos = (r_ldx + l_idx) // 2
插值算法计算中间位置的逻辑如下所示:
其中 key 代表要查找的关键字。
# 插值算法中计算中间位置
mid_pos = l_idx + (key - nums[l_idx]) // (nums[r_idx] - nums[l_idx]) * (r_idx - l_idx)
以下是插值查找的编码实现:
# 插值查找基于二分法,只是mid计算方法不同
def binary_search(nums, key):
    l_idx = 0
    r_idx = len(nums) - 1
    old_mid = -1
    mid_pos = None
    while l_idx < r_idx and nums[0] <= key and nums[r_idx] >= key and old_mid != mid_pos:
        # 中间位置计算
        mid_pos = l_idx + (key - nums[l_idx]) // (nums[r_idx] - nums[l_idx]) * (r_idx - l_idx)
        old_mid = mid_pos
        if nums[mid_pos] == key:
            return "index is {}, target value is {}".format(mid_pos, nums[mid_pos])
            # 此时目标值在中间值右边,更新左边界位置
        elif nums[mid_pos] < key:
            l_idx = mid_pos + 1
        # 此时目标值在中间值左边,更新右边界位置
        elif nums[mid_pos] > key:
            r_idx = mid_pos - 1
    return "Not find"

li =[1, 3, 4, 5, 8, 10, 12]
print(binary_search(li, 6))
在插值算法计算中间位置时,若多次计算结果相同,则可视为查找失败。
插值算法的性能介于线性查找和二分查找之间。
当数列中数字较多且分布较为均匀时,插值查找的平均性能比折半查找好得多。但如果数列中数据分布非常不均匀,此时插值算法并非最佳选择。
4. 分块查找
分块查找类似于数据库中的索引查询,因此也称为索引查找。其算法核心仍基于线性查找。
现有原始数列 nums=[5,1,9,11,23,16,12,18,24,32,29,25],需要查找关键字 11 是否存在。
第 1 步:使用分块查找前,需先将原始数列按区域分成多个块。分块数量可根据实际情况自行定义。分块时有一个要求:前一个块中的最大值必须小于后一个块的最小值。
块内部可以无序,但需保持整个数列按块有序。
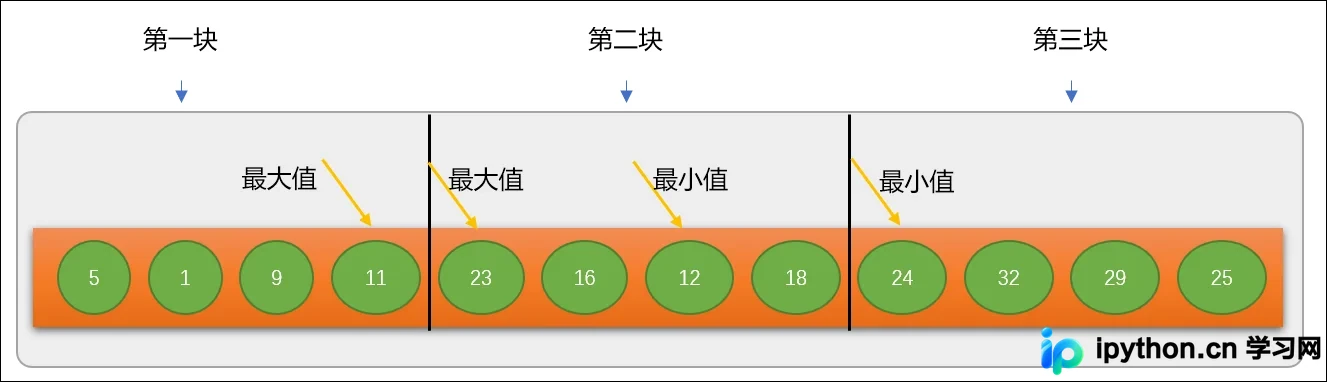
分块查找要求原始数列从整体上具有升序或降序趋势。如果数列分布不具有趋向性,仍想使用分块查找,则需进行分块有序调整。
第 2 步:根据分块信息建立索引表。索引表至少应包含 2 个字段,包括每一块中的最大值数字以及每一块的起始地址。显然,索引表中的数字是有序的。
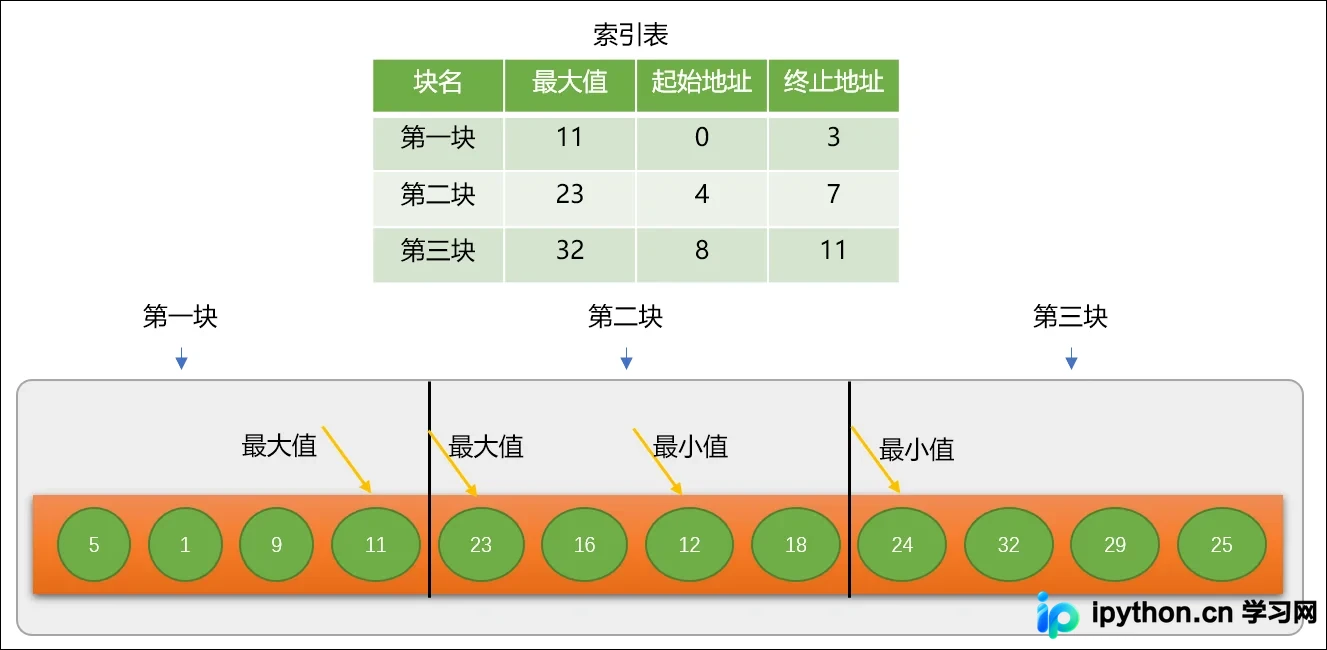
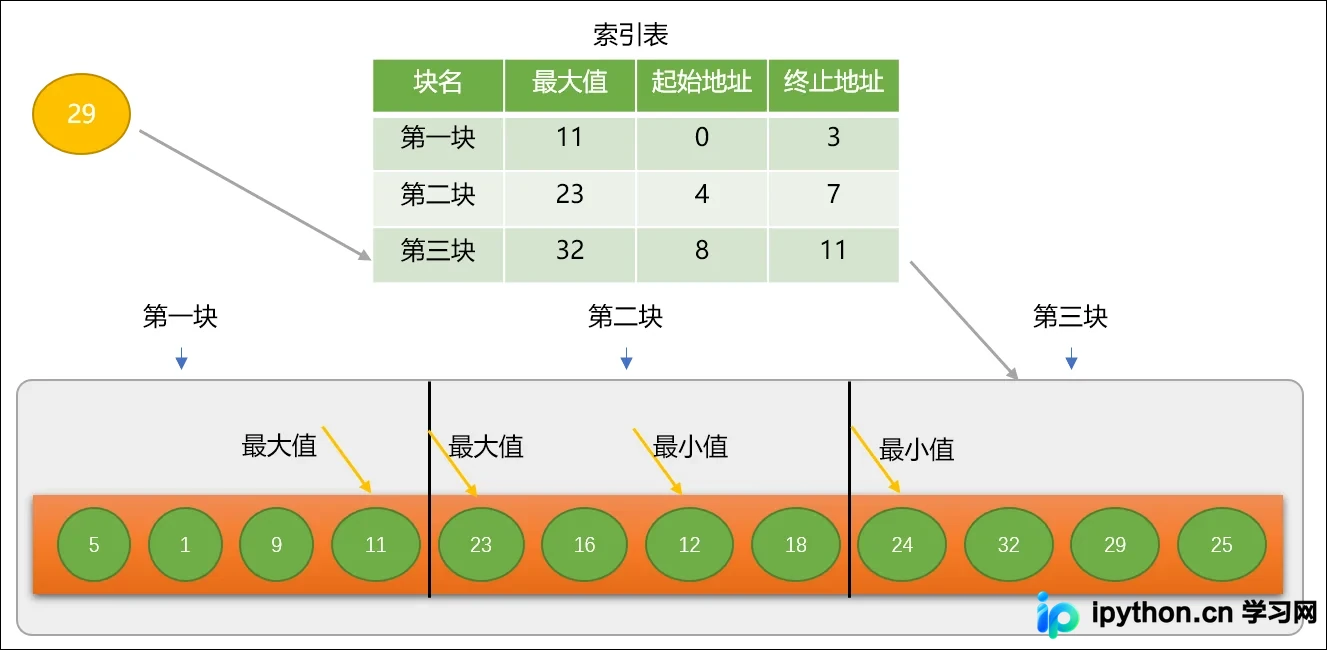
第 3 步:查找给定关键字时,先查询索引表,确定关键字可能位于哪个块。例如查询关键字 29,可知其应在第三块中。随后根据索引表提供的第三块地址信息,进入第三块数列,按线性匹配算法查找 29 的具体位置。
以下是分块查找的编码实现:
首先编码实现根据分块数量创建索引表,此处使用二维列表保存储索引表中的信息。
'''
分块:建立索引表
参数:
    nums 原始数列
    blocks 块大小
'''
def create_index_table(nums, blocks):
    # 索引表使用列表保存
    index_table = []
    # 每一块的数量
    n = len(nums) // blocks
    for i in range(0, len(nums), n):
        # 索引表中的每一行记录
        tmp_lst = []
        # 最大值
        tmp_lst.append(max(nums[i:i + n-1]))
        # 起始地址
        tmp_lst.append(i)
        # 终止地址
        tmp_lst.append(i + n - 1)
        # 添加到索引表中
        index_table.append(tmp_lst)
    return index_table
'''
测试分块
'''
nums = [5, 1, 9, 11, 23, 16, 12, 18, 24, 32, 29, 25]
it = create_index_table(nums, 3)
print(it)
'''
输出结果:
[[11, 0, 3], [23, 4, 7], [32, 8, 11]]
'''
代码执行后,输出结果与分析结果一致。
以上代码仅针对整体趋势有序的数列进行分块。如果整体并非趋向有序,则需提供相应的块排序方案,有兴趣者可自行完成。
如上代码仅用于说明分块查找算法原理。
分块查找的完整代码如下:
'''
分块:建立索引表
参数:
    nums 原始数列
    blocks 块大小
'''
def create_index_table(nums, blocks):
    # 索引表使用列表保存
    index_table = []
    # 每一块的数量
    n = len(nums) // blocks
    for i in range(0, len(nums), n):
        tmp_lst = []
        tmp_lst.append(max(nums[i:i + n - 1]))
        tmp_lst.append(i)
        tmp_lst.append(i + n - 1)
        index_table.append(tmp_lst)
    return index_table

'''
使用线性查找算法在对应的块中查找
'''
def lind_find(nums, start, end):
    for i in range(start, end):
        if key == nums[i]:
            return i
            break
    return -1

'''
测试分块
'''
nums = [5, 1, 9, 11, 23, 16, 12, 18, 24, 32, 29, 25]
key = 16
# 索引表
it = create_index_table(nums, 3)
# 索引表的记录编号
pos = -1
# 在索引表中查询
for n in range(len(it) - 1):
    # 是不是在第一块中
    if key <= it[0][0]:
        pos = 0
    # 其它块中
    if it[n][0] < key <= it[n + 1][0]:
        pos = n + 1
        break
if pos == -1:
    print("{0} 在 {1} 数列中不存在".format(key, nums))
else:
    idx = lind_find(nums, it[pos][1], it[pos][2] + 1)
    if idx != -1:
        print("{0} 在 {1} 数列的 {2} 位置".format(key, nums, idx))
    else:
        print("{0} 在 {1} 数列中不存在".format(key, nums))
'''
输出结果
16 在 [5, 1, 9, 11, 23, 16, 12, 18, 24, 32, 29, 25] 数列的第 5 位置
'''
分块查找对于整体趋向有序的数列,其查找性能较好。但如果原始数列整体无序,则需提供块排序算法,其时间复杂度不如二分查找算法。
分块查找需要建立索引表,这需要额外的存储空间,因此空间复杂度较高。其优于二分查找之处在于只需对原始数列进行部分排序。本质上,分块查找仍以线性查找为主。
5. 总结
本文讲解了线性、二分、插值、分块查找算法。此外,还有树表查找、哈希查找等其他算法。
分块算法可视为对线性查找算法的优化。
插值查找可视为在二分算法基础上的一个变化。
算法没有固定模式,如果学会了二分查找算法,相当于掌握了一招,需要学会领悟,然后在这一招上演变出更多变化。
以上就是详解Python查找算法的实现(线性,二分,分块,插值)的详细内容,更多关于Python查找算法的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















