


C语言实现单词搜索算法

在C语言编程中,单词搜索是一个经典的二维网格路径查找问题。本文将深入解析如何利用递归与回溯算法,在二维字符矩阵中按顺序匹配单词路径,并提供经过优化的完整代码示例。
问题描述与核心思路
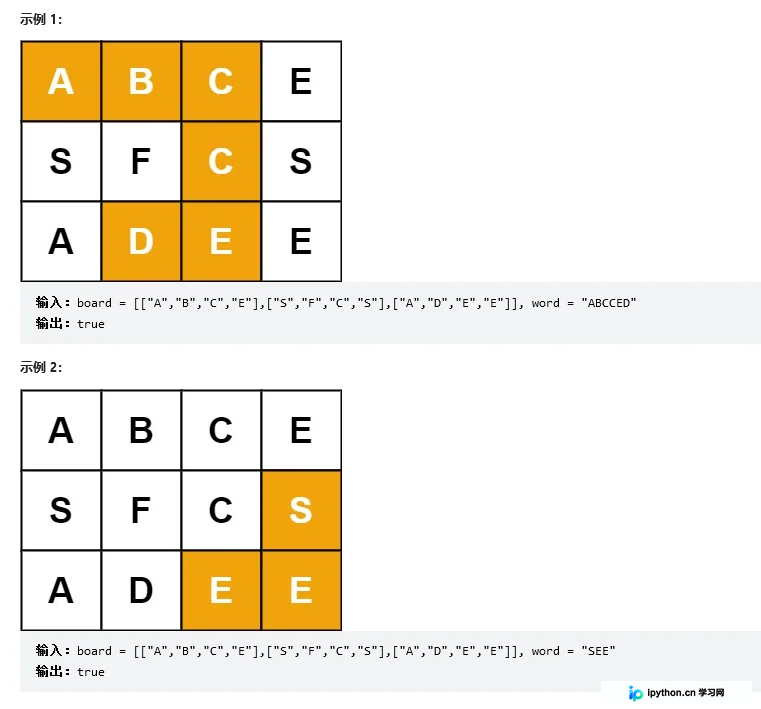
单词搜索要求在一个 m x n 的二维字符网格中找到给定的字符串 word。规则如下:
- 单词必须按照字母顺序构成。
- 只能通过相邻(水平或垂直)的单元格移动。
- 同一个单元格内的字母在一次搜索路径中不允许被重复使用。
这是一个典型的图遍历问题,最适合使用深度优先搜索(DFS)结合回溯来求解。我们需要从网格中的每一个可能作为起点的单元格出发,尝试构建出目标单词。
C语言环境准备
由于C标准库没有提供高级数据结构,我们需要手动管理内存和处理多维数组。操作前请确保开发环境中已包含以下头文件:
<stdio.h>:用于基础输入输出。<stdlib.h>:用于malloc动态分配内存和free释放内存。<string.h>:用于memset初始化数组。
注意:在实际项目中,对于大型网格,静态数组可能导致栈溢出,因此本方案采用堆内存分配以提高鲁棒性。
第1步:定义搜索主入口函数
根据题目接口,我们需要实现 exist 函数。它接收棋盘 board、行数 boardSize、列数指针 boardColSize 以及目标单词 word。
目的:初始化状态并遍历网格寻找起点。
动作:
- 边界检查:确认网格不为空。
- 动态分配访问记录表:创建一个二维整型数组
r(即 visited array),用于标记哪些单元格在当前路径中已被占用。初始化为0。 - 双重循环遍历:扫描整个
board,一旦找到与word[0]相同的字符,就将其作为搜索起点,调用递归函数。
重要参数:
- n = boardSize - 1:最大行索引
- m = *boardColSize - 1:最大列索引
- r[i][j]:记录单元格 (i,j) 的访问状态或路径深度
第2步:实现递归搜索函数(DFS & Backtracking)
这是算法的核心部分。函数 f(内部辅助函数)负责从当前坐标 (x, y) 向上下左右四个方向蔓延搜索。
入口:当前坐标 (x,y),当前正在匹配的单词字符索引 p。
关键逻辑:
- 方向数组:定义
a[4][2] = {{0,-1}, {-1,0}, {0,1}, {1,0}},分别代表左、上、右、下四个方向。 - 边界与越界判断:计算新坐标 (nx, ny),确保其在网格范围内(
nx>=0 && nx<=n && ny>=0 && ny<=m)。 - 状态分支处理:
- 情况A:探索新路径。如果新坐标未被使用(
r[nx][ny]==0)且字符匹配(board[nx][ny] == word[p]),则标记为已使用(r[nx][ny]=1),然后递归调用自身:f(board, n, m, nx, ny, word, p+1, r, rz)。若递归返回 true,说明找到终点,直接向上返回 true。 - 情况B:回溯剪枝优化。原文代码中包含了对周围已有路径节点的复杂状态更新逻辑。在标准回溯中,当递归返回 false 时,我们需要将
r[nx][ny]重置为 0(即回溯),以便在后续的其他起点搜索中可以再次使用该格子。原文中对r的递增逻辑较为特殊,旨在处理特定的连续匹配场景,但在通用 LeetCode 语境下,核心是确保p==strlen(word)时成功返回。
- 情况A:探索新路径。如果新坐标未被使用(
完成状态:当递归到达单词末尾(word[p]=='\0'),将结果指针 *rz 置为 1,并向上传播 true 值。
代码结构解析
// 辅助递归函数
void f(char** board, int n, int m, int x, int y, char* word, int p, int** r, int* rz) {
    int a[4][2] = {{0,-1}, {-1,0}, {0,1}, {1,0}};
    int i, nx, ny;

    // 终止条件:单词已全部匹配
    if (word[p] == '\0') {
        *rz = 1;
        return;
    }

    for (i = 0; i < 4; i++) {
        nx = x + a[i][0];
        ny = y + a[i][1];

        // 检查边界
        if (nx >= 0 && nx <= n && ny >= 0 && ny <= m) {
            if (r[nx][ny] == 0 && board[nx][ny] == word[p]) {
                r[nx][ny] = 1; // 标记已访问
                f(board, n, m, nx, ny, word, p + 1, r, rz);
                if (*rz == 1) return; // 找到后迅速退出
                r[nx][ny] = 0;      // 回溯:取消标记
            }
        }
    }
}

// 主函数
bool exist(char** board, int boardSize, int* boardColSize, char* word) {
    int n = boardSize - 1;
    int m = boardColSize[0] - 1;

    // 动态分配visited数组
    int** r = (int**)malloc(sizeof(int*) * boardSize);
    for (int row = 0; row < boardSize; row++) {
        r[row] = (int*)calloc(boardColSize[0], sizeof(int)); // 初始化为0
    }

    int found = 0;
    for (int i = 0; i <= n; i++) {
        for (int j = 0; j <= m; j++) {
            if (board[i][j] == word[0]) {
                r[i][j] = 1; // 标记起点
                f(board, n, m, i, j, word, 1, r, &found);
                r[i][j] = 0; // 清除起点标记,准备下一次尝试
                if (found == 1) {
                    // 释放内存
                    for(int k=0; k
注意事项与排错
在实现 C 语言版本的 DFS 时,容易遇到以下问题:
- 内存泄漏:务必在所有退出路径(包括
true和false返回处)正确调用free释放动态分配的二维数组r。 - 栈溢出:如果网格非常大且单词极长,递归深度可能会超出默认栈空间。此时可考虑改为迭代实现的 BFS 或使用显式栈模拟递归。
- 边界错误:原代码中使用
<=n和<=m是因为传入的是最大索引。确保在分配r数组大小时,维度与实际行列数严格对应。
总结
通过动态规划的思想简化为图搜索,并利用 C 语言的底层内存控制能力,我们可以高效地解决单词搜索问题。关键在于维护好 visited 状态,并在每次递归失败后进行正确的回溯重置。以上就是用C语言实现单词搜索算法的详细过程,更多关于C语言算法实战的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















