


解析Go语言CSP并发模型与MPG调度机制

Go语言之所以被誉为“为并发而生”,核心在于其独特的CSP模型与高效的MPG调度器。不同于传统多线程通过共享内存交互,Go提倡“通过通信来共享内存”。本文将拆解M、P、G三者的协同工作机制,揭示Goroutine如何在用户态与内核态之间高效流转。
并发与并行的本质区别
在深入Go的调度之前,需明确两个基础概念:
- 并发 (Concurrency):指多个任务在一段时间内交替执行,关注的是逻辑上的处理结构,未必是同时运行。
- 并行 (Parallelism):指多个任务在同一时刻被同时执行,强调物理层面的多核利用率。
Go语言既支持传统的“多线程共享内存”模式,也提供了推荐的CSP模式。后者由goroutine(轻量级协程)和channel(管道)组成,遵循谚语:“Do not communicate by sharing memory; instead, share memory by communicating.”
第1步:理解CSP的基本通信流程
CSP的核心在于channel的阻塞式传输。当 Goroutine A 向通道发送数据时,它会被阻塞;只有当另一个 Goroutine B 从该通道接收数据时,两者才会同步并完成交接。
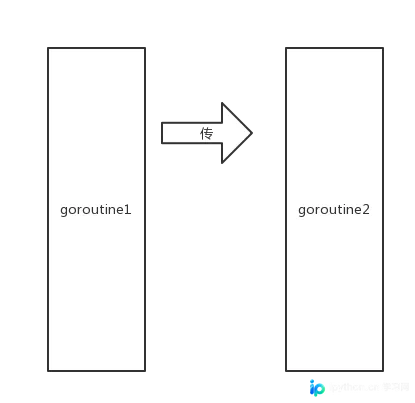
Goroutine A 发起传值操作后进入等待状态:
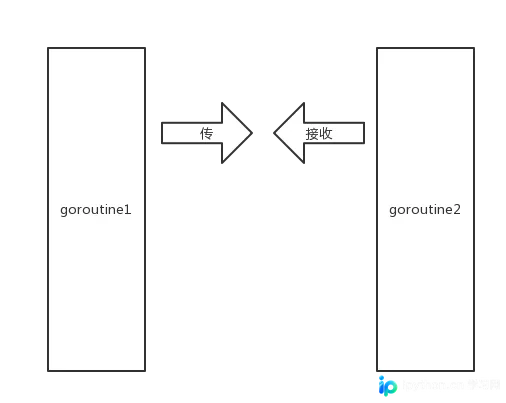
Goroutine B 发起接收操作后,双方完成匹配:
Go调度器:MPG模型架构
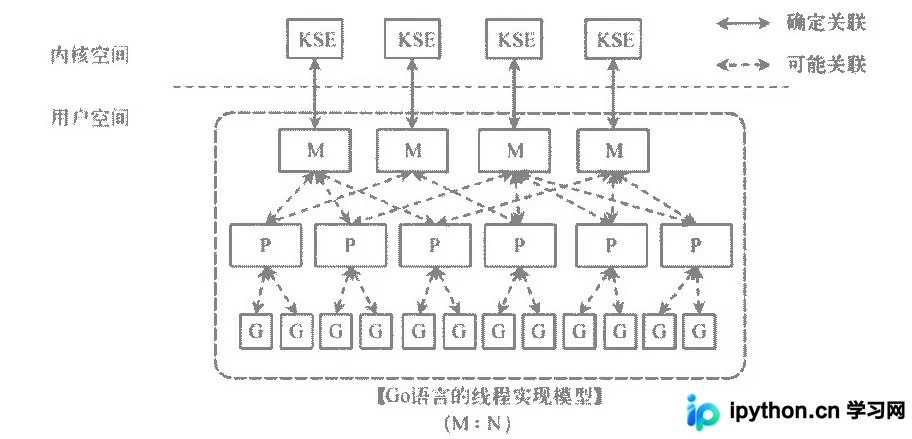
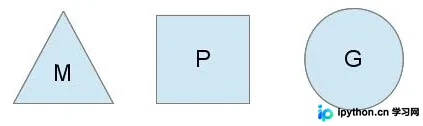
Go的调度器工作在用户态,采用一种特殊的两级线程模型,称为MPG模型。它由三个核心元素构成:
- M (Machine):代表操作系统内核线程,直接绑定CPU资源。
- P (Processor):代表执行上下文/处理器,包含本地可运行队列 (
runqueue)。P的数量由环境变量GOMAXPROCS或运行时函数runtime.GOMAXPROCS()决定。 - G (Goroutine):轻量级用户级线程,是实际执行代码的单位。
这三者的关系如下所示:
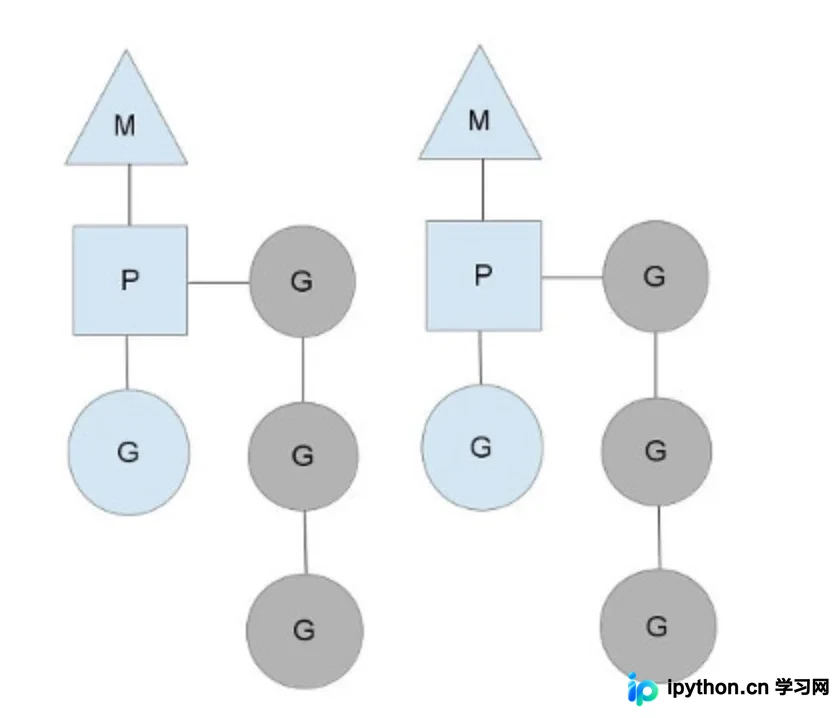
MPG的宏观视图
一个M对应一个内核线程,一个M通常会关联一个P。P负责管理其本地的G队列。图中正在执行的G标记为蓝色,待执行的灰色G形成队列:
为什么需要P上下文?
如果直接将G挂在M上,当M发生系统调用阻塞时,整个内核线程都会停滞,导致其他就绪的G无法运行。引入P的目的是为了解耦:当M阻塞时,可以将P转让给其他可用的M,从而保持其他G的执行。
MPG调度的真实操作场景
第1步:单核环境下的基本调度
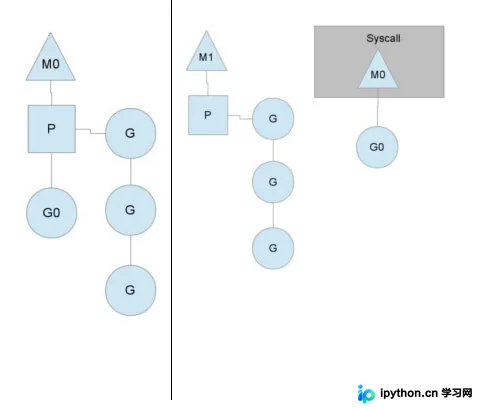
在单核CPU下,所有G共享同一个M(如M0)和一个P。每个时间片结束或遇到阻塞时,G会回到runqueue。
若当前运行的G0发生阻塞(如IO操作),调度器会创建新的线程M1,并将P转移过去:
第2步:系统调用导致的P置换
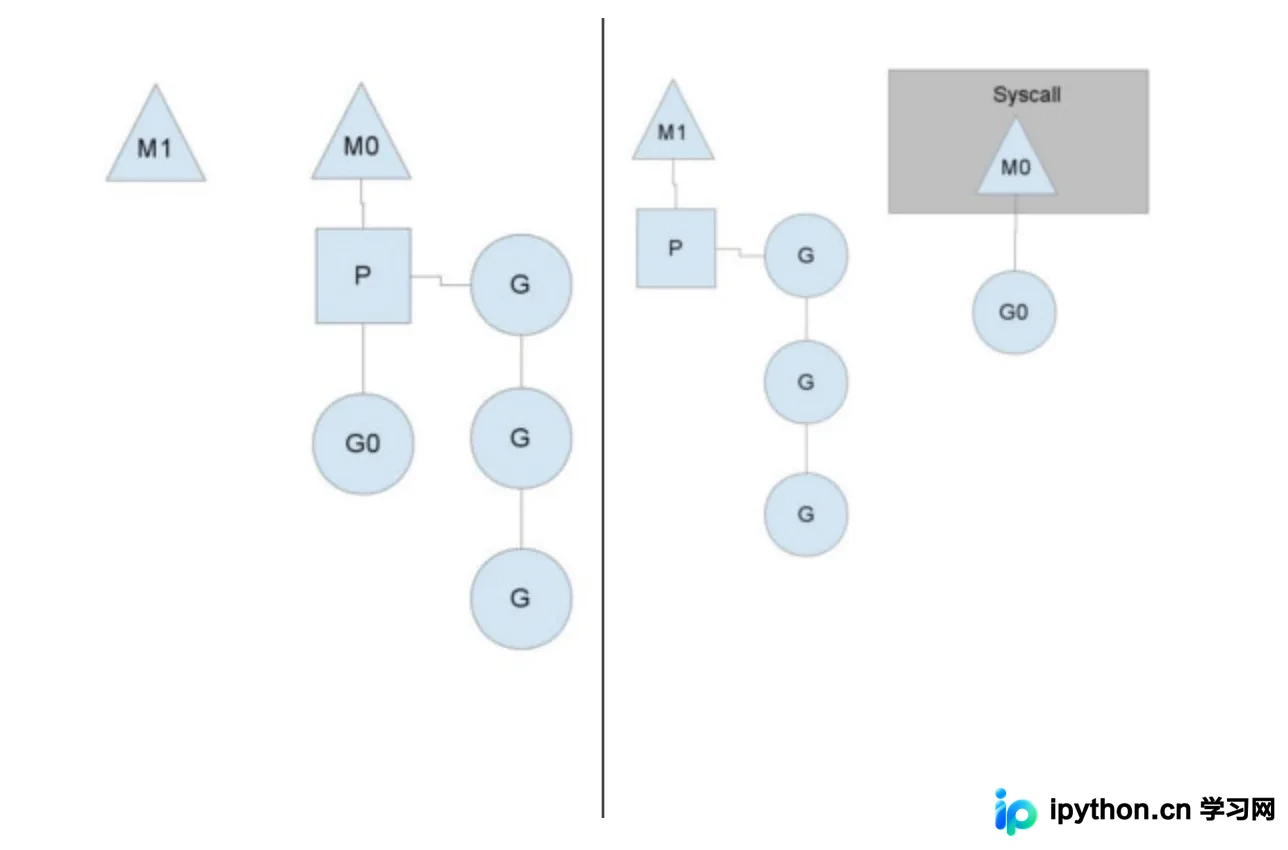
当某个M中的G发起系统调用(syscall)时,该M会被阻塞。此时:
- M0放弃当前的P。
- 创建或唤醒一个新的M1(若存在)。
- M1接管P,继续执行P本地队列中的其他G。
这种机制确保了系统调用不会阻塞整个程序的并发能力:
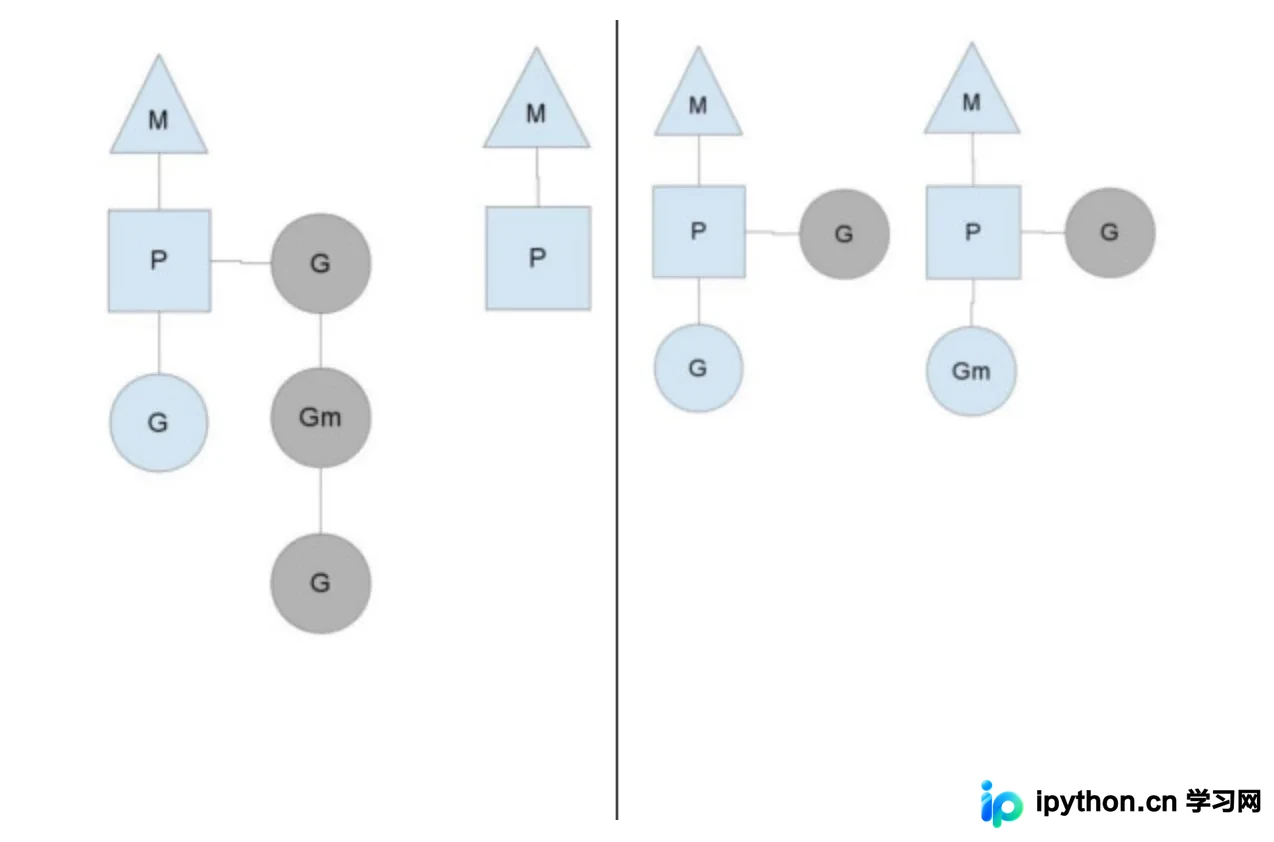
第3步:全局队列与工作窃取 (Work Stealing)
当被阻塞的M恢复后,它会尝试“偷取”其他P手中的上下文。如果偷不到,会将当前的G放入全局运行队列 (Global Runqueue),自身转入休眠或缓存。
为了负载均衡,空闲的P不仅检查全局队列,还会从其他繁忙的P那里窃取一半的工作量:
不同线程模型的对比
理解MPG的优势,需要将其与传统模型对比:
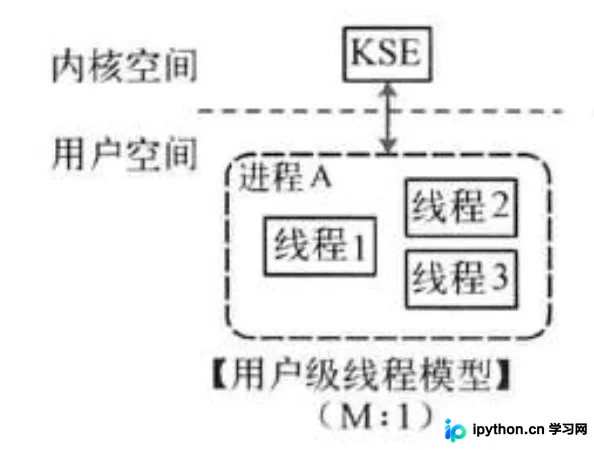
用户级线程模型
多个用户线程映射到一个内核线程,调度完全由用户程序负责。缺乏对多核系统的原生利用:
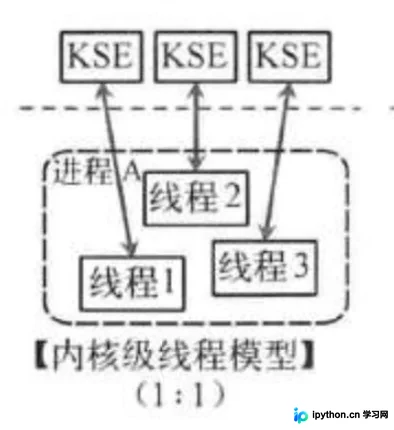
内核级线程模型
C++等语言常用,每个线程直接对应内核对象。切换开销大,且受限于内核资源:
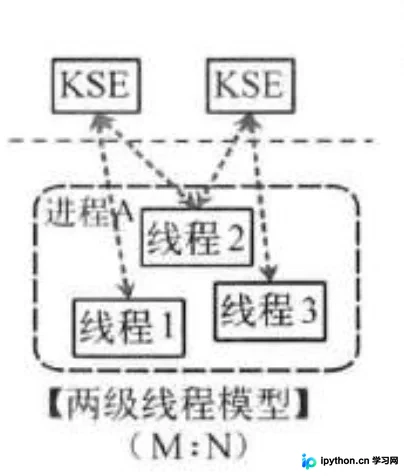
两级线程模型 (Go的方案)
介于两者之间。由Go runtime负责将大量G映射到有限数量的M上。M由OS内核调度,而G由Go调度器调度。这种设计实现了极高的并发密度和低开销:
总结
Go语言的CSP模型通过goroutine和channel简化了并发逻辑,而其底层的MPG调度器则通过在用户态模拟复杂的线程映射,实现了高效的资源复用。P的存在解决了系统调用阻塞问题,而工作窃取算法保证了多核环境下的负载均衡。
以上就是Go语言CSP并发模型实现MPG的详细内容,更多关于Go CSP并发模型MPG的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















