


Python 统计元素与单词出现频率及排序的方法详解

本文详解在 Python 中统计序列元素或文本单词出现频率的核心技巧,涵盖手动构建字典计数并提取最高频元素的传统方法,以及如何借助标准库 collections.Counter 快速完成统计、排序与分词处理。通过正则清洗与多场景代码示例,帮助开发者高效实现频次分析。
手动构建字典统计元素频次
在处理列表等序列数据时,统计每个元素的出现次数是常见的数据处理需求。其核心逻辑是将序列转换为键值对为“元素及其出现次数”的字典。初始状态下所有元素的计数可设为 0,随后通过遍历序列逐个累加。
from random import randint

# 生成包含重复元素的随机序列(范围 0-10,共 20 个)
nums = [randint(0, 10) for _ in range(20)]

# 初始化计数器字典,Key 为序列唯一值,Value 为 0
count = dict.fromkeys(nums, 0)

# 遍历序列更新频次
for num in nums:
    count[num] += 1

# 提取所有频次值并排序,获取最大频次
_sorted_counts = sorted(count.values())
max_count = _sorted_counts.pop()

# 查找达到最大频次的元素
result_keys = [k for k, v in count.items() if v == max_count]

print("随机序列:", nums)
print("统计字典:", count)
print("最高频次:", max_count)
print("最高频元素:", result_keys)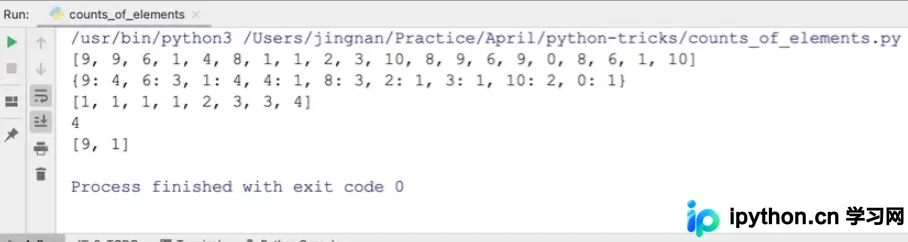
上述代码通过基础的数据结构完成了频次统计。执行后,系统会打印出随机生成的序列、对应的计数字典以及经过排序筛选出的最大次数与对应元素。例如在本例的运行结果中,最高频次为 4,满足该条件的元素分别是 1 和 9。
利用 Counter 实现高效排序与取值
虽然手动遍历能够完成任务,但在实际开发中,Python 标准库提供了更为专业的工具——collections.Counter 类。它能够直接对任何可迭代对象进行哈希计数,并提供便捷的排序接口,大幅减少样板代码。
from collections import Counter

# 直接将已统计的字典传入 Counter(也可直接传入原始序列 nums)
counter_obj = Counter(count)

# most_common() 方法默认返回所有元素按频次降序排列的元组列表
print("全量排序结果:", counter_obj.most_common())

# most_common(n) 仅返回出现频次最高的 n 个元素及其计数
top_3 = counter_obj.most_common(3)
print("前三高频元素:", top_3)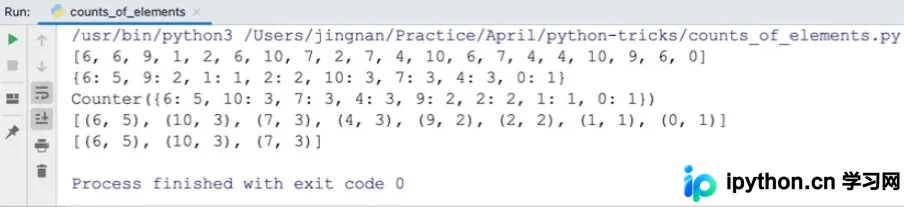
使用 Counter 后,代码逻辑显著简化。most_common() 方法内部已经实现了基于值的降序排序。调用时无需手动编写比较函数或复杂的推导式,直接获取结构化的高频数据列表即可。
结合正则表达式清洗文本与统计词频
在实际的自然语言处理或日志分析场景中,往往需要统计一段文本内特定词汇(如英文单词)的出现频率。此时需先利用正则表达式清理标点符号与空白字符,再进行词频统计。
import re
from collections import Counter

# 读取目标文本文件
with open('zen.txt', 'r', encoding='utf-8') as f:
    text_data = f.read()

# 使用正则表达式 \W+ 分割非字母数字字符,过滤掉标点和多余空格
words_list = re.split(r'\W+', text_data)

# 实例化 Counter 进行分词统计
word_counter = Counter(words_list)

# 输出全部统计结果
print("完整词频字典:", word_counter)

# 获取出现次数最多的前三个单词
top_3_words = word_counter.most_common(3)
print("最常使用的三个词:", top_3_words)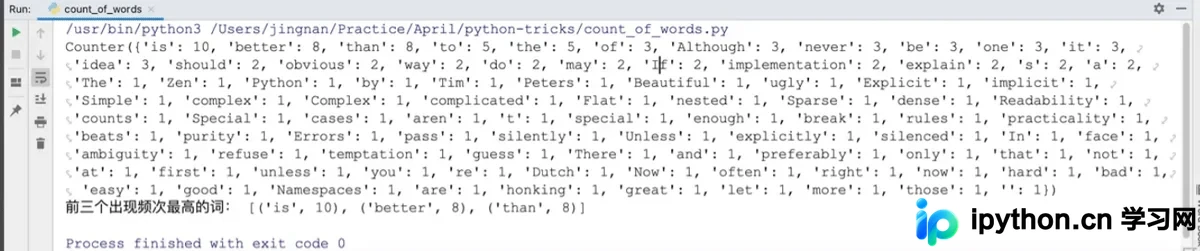
在上述流程中,re.split('\W+', text) 能够有效拆分混合了标点的长字符串,确保统计单元仅为有效的单词。随后将其交由 Counter 处理,即可无缝衔接前文所述的高效排序与取值逻辑。这种方法广泛适用于日志解析、文章字数统计及简单的词云数据预处理。
以上就是 Python 统计序列元素频次与单词计数的详细内容,更多关于 Python 数据处理与内置模块高效编程的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















