


Python实现一阶马尔科夫链生成随机DNA序列的完整方法

本文详细讲解如何利用一阶马尔科夫链在Python中生成随机DNA序列。通过定义碱基转移概率,模拟序列的随机演化过程,并展示如何统计和可视化生成的序列长度分布,适用于序列建模与分析场景。
一阶马尔科夫链原理
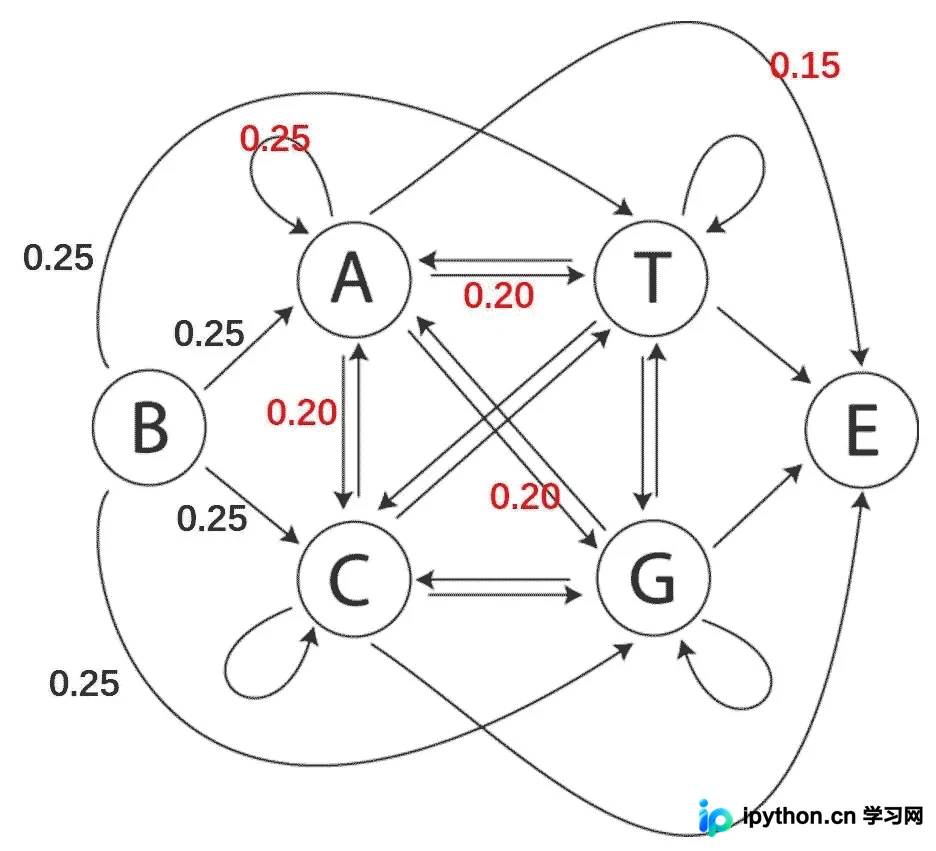
在DNA序列生成中,一阶马尔科夫链假设当前碱基类型仅依赖于前一位碱基。状态空间包含四种碱基"A","G","C","T"及终止状态"E",转移概率定义了下一位碱基的可能性与结束条件。例如,若当前为A,则下一位为A、T、G、C的概率分别为0.25、0.20、0.20、0.20,结束概率为0.15。
代码实现步骤
第1步:配置运行环境
确保系统已安装Python、numpy、random和matplotlib模块。建议在Jupyter Notebook环境中运行,以支持交互式绘图。若需单独执行脚本,可移除%matplotlib notebook魔法命令。
第2步:定义状态与转移矩阵
创建状态空间列表和转移事件名称表,并初始化4x5概率矩阵,每行代表当前碱基,各列对应下一状态(A/G/C/T/E)。矩阵值需保证每行和为1.0以符合概率分布。
第3步:编写生成函数与逻辑
实现RandomDNAs(Num)函数,接收生成数量参数。函数内循环生成每条序列:随机选择起始碱基,根据转移矩阵逐位采样,直到到达终止状态"E"。记录序列长度至列表,用于后续统计分析。
import numpy
import random
import seaborn as sns
import matplotlib.pyplot as plt

states = ["A","G","C","T","E"]
transitionName = [["AA","AG","AC","AT","AE"],
                  ["GA","GG","GC","GT","GE"],
                  ["CA","CG","CC","CT","CE"],
                  ["TA","TG","TC","TT","TE"],]
transitionMatrix = [[0.25,0.20,0.20,0.20,0.15],
                    [0.20,0.25,0.20,0.20,0.15],
                    [0.20,0.20,0.25,0.20,0.15],
                    [0.20,0.20,0.20,0.25,0.15]]

def RandomDNAs(Num):
    max_len = 0
    i = 0
    Seq = []
    Len = []
    while i != Num:
        Base = ["A","G","C","T"]
        START = random.choice(Base)
        Seq.append(START)
        while START != "E":
            if START == "A":
                change = numpy.random.choice(transitionName[0],p=transitionMatrix[0])
                if change == "AA": START = "A"
                elif change == "AG": START = "G"
                elif change == "AC": START = "C"
                elif change == "AT": START = "T"
                elif change == "AE": START = "E"
            elif START == "G":
                change = numpy.random.choice(transitionName[1],p=transitionMatrix[1])
                if change == "GA": START = "A"
                elif change == "GG": START = "G"
                elif change == "GC": START = "C"
                elif change == "GT": START = "T"
                elif change == "GE": START = "E"
            elif START == "C":
                change = numpy.random.choice(transitionName[2],p=transitionMatrix[2])
                if change == "CA": START = "A"
                elif change == "CG": START = "G"
                elif change == "CC": START = "C"
                elif change == "CT": START = "T"
                elif change == "CE": START = "E"
            elif START == "T":
                change = numpy.random.choice(transitionName[3],p=transitionMatrix[3])
                if change == "TA": START = "A"
                elif change == "TG": START = "G"
                elif change == "TC": START = "C"
                elif change == "TT": START = "T"
                elif change == "TE": START = "E"
            if START != "E":
                Seq.append(START)
        i += 1
        Len.append(len(Seq))
        if len(Seq) > max_len:
            max_len = len(Seq)
        Seq.clear()
    plt.hist(numpy.array(Len), bins=max_len, edgecolor="white")
    plt.xlabel("DNA Sequence Length")
    plt.ylabel("Frequency")
    plt.title("Histogram of frequency distribution of DNA sequence length")
    plt.show()
    print("DNA序列的最大长度为:",max_len)
    print("DNA序列长度的众数为:",max(Len, key=Len.count))
第4步:执行生成与结果查看
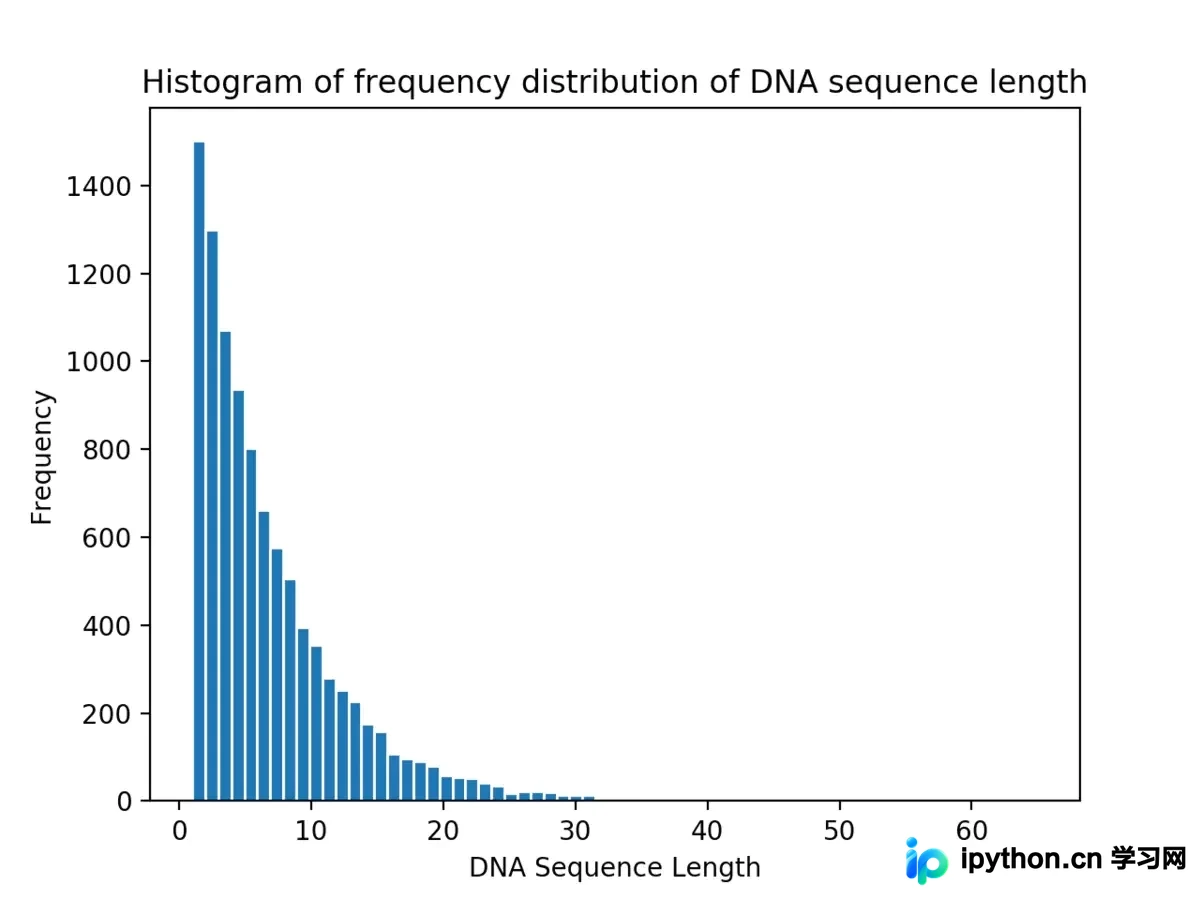
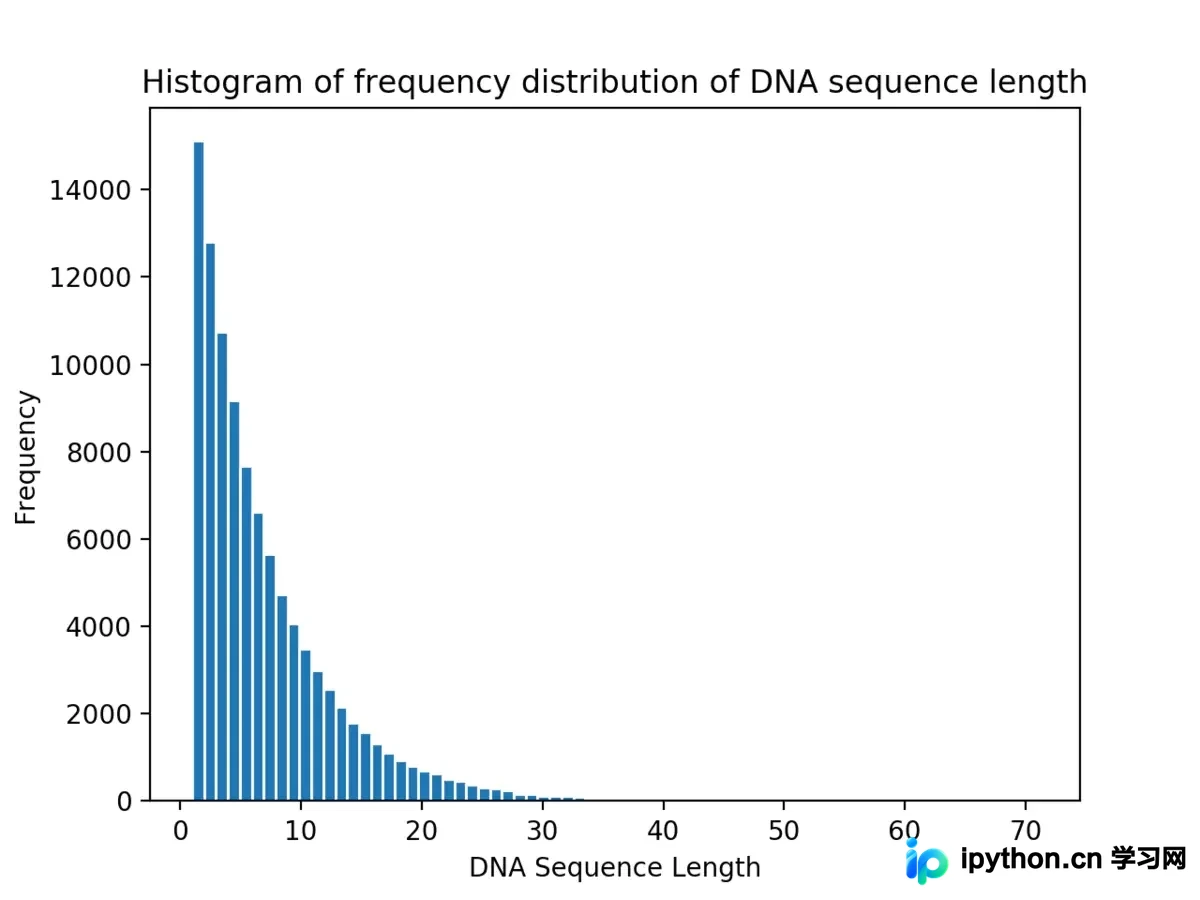
调用RandomDNAs(1000)参数启动生成。程序输出序列最大长度和众数,并弹出直方图窗口。若需查看单个序列内容,可取消# print(''.join(Seq))前的注释符号。
结果分析与扩展建议
实验结果表明,增加生成序列数量可使长度分布趋于稳定,且多数序列较短(众数1),这与高终止概率设置一致。该方法可灵活调整概率矩阵,以模拟不同碱基偏好或引入高阶依赖。对于生产环境,建议添加日志记录和异常处理以提升鲁棒性。
总结
通过一阶马尔科夫链和Python科学计算栈,开发者能高效生成具有可控概率特征的DNA序列。此方案为序列建模提供了一种直观且可扩展的途径,适用于教学演示或初步数据分析。如需深入复杂模型,可考虑集成机器学习库进行训练优化。
以上就是Python实现一阶马尔科夫链生成随机DNA序列的详细内容,更多关于Python生物信息学计算的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















