


Python求已知DNA模板的互补序列:避开字符覆盖陷阱的正确写法

本文详细解析如何在Python中准确计算已知DNA模板的互补序列。针对初学者常见的replace()方法导致的数据覆盖问题,提供一种利用大小写特性与临时占位符的安全替换方案,并附完整可运行代码及结果验证,帮助快速掌握字符串处理技巧。
DNA互补序列的计算规则
在生物信息学中,DNA双链遵循严格的碱基互补配对原则:腺嘌呤(A)与胸腺嘧啶(T)配对,胞嘧啶(C)与鸟嘌呤(G)配对。若给定一条单链模板,求其互补序列的本质就是执行一对一映射:将原序列中的A替换为T、T替换为A、C替换为G、G替换为C。
模板示例:ACTGATCGATTACGTATAGTATTTGCTATCATACATATATATCGATGCGTTCAT
目标互补:TGACTAGCTAATGCATATCATAAACGATAGTATGTATATATAGCTACGCAAGTA
常见误区:为何连续调用replace会失效
许多初学者会直接串联多次.replace()进行转换,例如先A.replace('A', 'T'),紧接着.replace('T', 'A')。这种写法看似直观,实则存在严重的数据覆盖风险。
原因在于replace()是即时生效的。第一次替换后,原本存在的T以及新生成的T都会参与第二次替换。这会导致原始数据被反复覆盖,最终输出的序列完全错乱。此外,若对原字符串并行创建多个变量分别替换而不合并,也无法得到单一的目标互补链。
安全方案:利用大小写差值完成无冲突替换
要彻底避开字符覆盖陷阱,核心思路是引入不重叠的中间状态。利用Python字符串支持大小写独立且统一转大写(.upper())的特性,可以设计一套“小写暂存→全量还原”的操作流:
- 目的与入口:避免原字母与新字母互相干扰,需保证替换过程中的临时字符与原碱基集合(A/T/C/G)完全隔离。
- 具体操作:将原模板中的A依次替换为小写
t,T替换为小写a,C替换为小写g,G替换为小写c。由于原字符串不含小写字母,后续替换只会命中各自对应的目标字母,绝不会发生连锁误判。 - 参数与状态:每次
.replace()仅作用于上一步的结果。全部替换完毕后,调用.upper()将所有小写占位符统一升维为大写,恢复标准生物学格式。
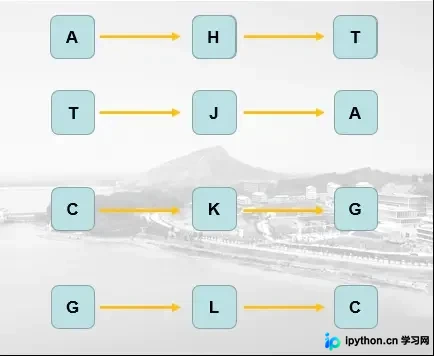
完整可运行的Python代码如下:
my_dna = "ACTGATCGATTACGTATAGTATTTGCTATCATACATATATATCGATGCGTTCAT"

# 第一步:利用小写字母作为唯一临时占位符,按顺序隔离替换
sequence = my_dna.replace('A', 't')
sequence = sequence.replace('T', 'a')
sequence = sequence.replace('C', 'g')
sequence = sequence.replace('G', 'c')

# 第二步:统一转为大写,输出标准互补序列
complementary_seq = sequence.upper()

print(complementary_seq)
运行结果与优化建议
执行上述脚本后,控制台将精准输出目标互补链:
TGACTAGCTAATGCATATCATAAACGATAGTATGTATATATAGCTACGCAAGTA
该方案不仅逻辑严密、代码精简,且避免了引入冗余项的繁琐步骤。对于更复杂的基因序列比对任务,建议在正式数据处理前始终做好原始数据的备份,防止覆盖操作不可逆。配合str.maketrans()与translate()还可进一步扩展至批量文件处理场景。
以上就是Python求已知DNA模板互补序列的详细内容,更多关于DNA序列转换与字符串处理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















