


使用Scrapy框架爬取虎扑网页数据并存储至MySQL实战

本文详解使用Scrapy框架抓取虎扑体育NBA球员统计数据的完整流程。从工程创建、XPath元素定位、Item数据模型定义,到配置MySQL连接管道与建表操作,逐步给出可运行代码与参数说明,帮助开发者快速实现网页数据的高效采集与本地持久化存储。
实现目标与运行环境
本文将以抓取虎扑体育NBA球员实时数据为例,演示如何通过Scrapy框架编写爬虫程序,并将解析后的结构化数据自动写入本地MySQL数据库。操作前请确保已安装Python环境、scrapy与pymysql库,且MySQL服务正常运行。
第1步:分析目标网页结构
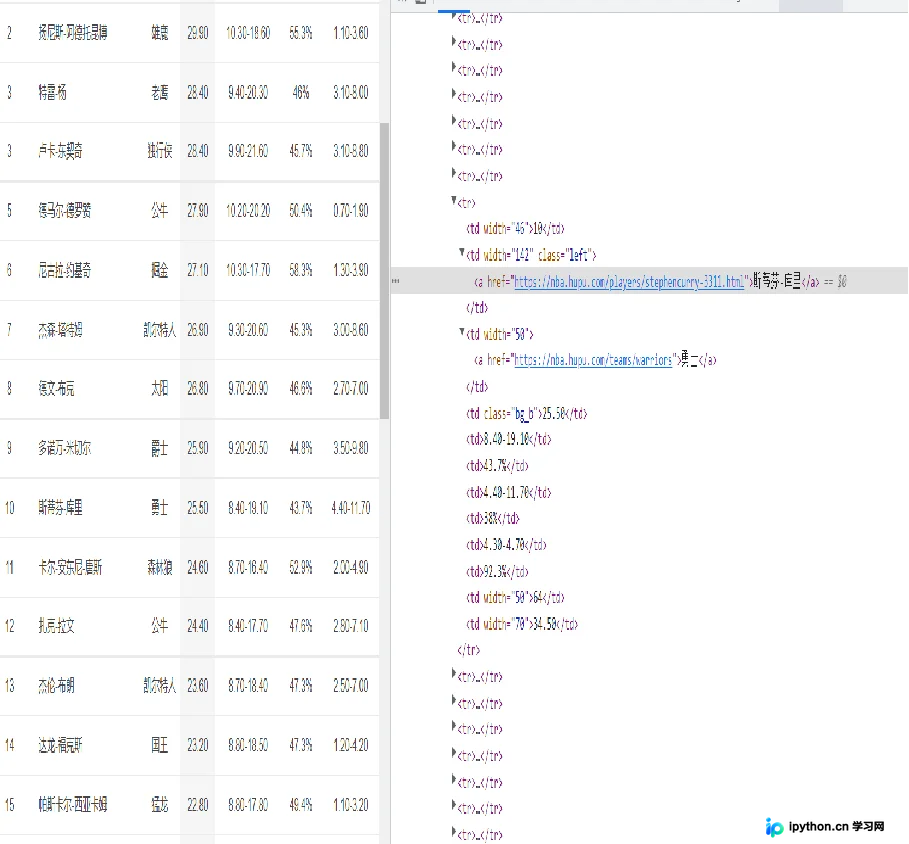
首先打开虎扑体育NBA数据统计页面,通过浏览器开发者工具(F12)查看页面源码。该页面表格结构清晰,数据集中在<tbody>内的<tr>行中,列依次为排名、球员名称、球队、场均得分、命中率、三分命中率与罚球命中率。确定层级关系后,即可使用XPath语法精确定位所需字段。
第2步:创建工程并定义数据模型
在终端执行以下命令初始化Scrapy工程:
scrapy startproject hpty执行成功后将生成标准工程目录。进入hpty/hpty/spiders路径创建爬虫文件:
scrapy genspider sww hupu.com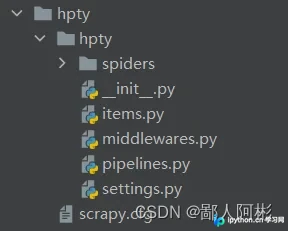
在items.py中定义数据接收容器,声明需采集的字段类型:
import scrapy

class HptyItem(scrapy.Item):
    排名 = scrapy.Field()
    球员 = scrapy.Field()
    球队 = scrapy.Field()
    场均得分 = scrapy.Field()
    命中率 = scrapy.Field()
    三分命中率 = scrapy.Field()
    罚球命中率 = scrapy.Field()
第3步:配置爬虫规则与设置
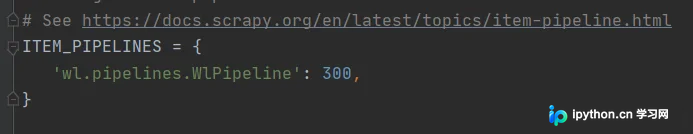
打开settings.py进行两项关键修改:
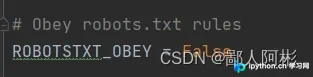
- 关闭遵守Robots协议:
ROBOTSTXT_OBEY = False - 启用自定义Pipeline(取消注释并指向项目路径):
ITEM_PIPELINES = {'hpty.pipelines.HptyPipeline': 300}
随后编辑爬虫主逻辑spiders/sww.py,修正允许的域名范围,并通过XPath提取表格单元格文本:
import scrapy
from ..items import HptyItem

class SwwSpider(scrapy.Spider):
    name = 'sww'
    allowed_domains = ['nba.hupu.com']
    start_urls = ['https://nba.hupu.com/stats/players']

    def parse(self, response):
        rows = response.xpath('//tbody/tr[not(@class)]')
        for row in rows:
            yield HptyItem(
                排名=row.xpath('./td[1]/text()').get(),
                球员=row.xpath('./td[2]/a/text()').get(),
                球队=row.xpath('./td[3]/a/text()').get(),
                场均得分=row.xpath('./td[4]/text()').get(),
                命中率=row.xpath('./td[6]/text()').get(),
                三分命中率=row.xpath('./td[8]/text()').get(),
                罚球命中率=row.xpath('./td[10]/text()').get()
            )
⚠️ 注意:生产环境中建议在start_urls后添加翻页逻辑或限速配置,避免高频请求触发反爬机制。
第4步:编写MySQL数据存储管道
在pipelines.py中实现数据库连接与写入逻辑。为保证资源安全释放,建议采用open_spider与close_spider钩子管理连接生命周期:
import pymysql

class HptyPipeline:
    def open_spider(self, spider):
        self.conn = pymysql.connect(
            host="localhost", user="root", passwd="你的密码",
            db="sww", charset="utf8mb4"
        )

    def process_item(self, item, spider):
        cur = self.conn.cursor()
        sql = "INSERT INTO nba(球员,球队,排名,场均得分,命中率,三分命中率,罚球命中率) VALUES(%s,%s,%s,%s,%s,%s,%s)"
        values = (
            item.get("球员"), item.get("球队"), item.get("排名"),
            item.get("场均得分"), item.get("命中率"),
            item.get("三分命中率"), item.get("罚球命中率")
        )
        cur.execute(sql, values)
        self.conn.commit()
        cur.close()
        return item

    def close_spider(self, spider):
        self.conn.close()
🔒 风险提醒:首次运行前请务必核实数据库账号密码正确性,错误凭证可能导致管道阻塞或连接拒绝。建议先在测试库验证写入逻辑。
第5步:准备MySQL数据库表
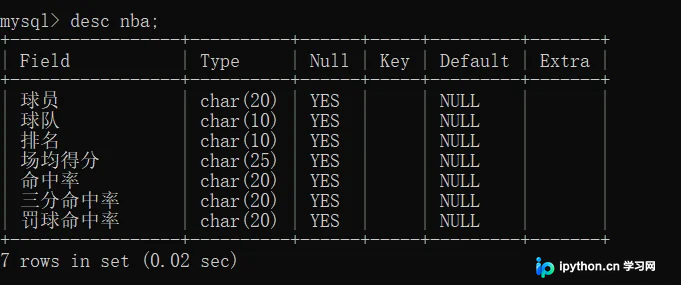
登录MySQL客户端,创建对应数据库与数据表。字符集推荐使用utf8mb4以兼容特殊符号:
CREATE DATABASE sww DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
USE sww;
CREATE TABLE nba (
    球员 CHAR(20),
    球队 CHAR(10),
    排名 CHAR(10),
    场均得分 CHAR(25),
    命中率 CHAR(20),
    三分命中率 CHAR(20),
    罚球命中率 CHAR(20)
);
第6步:执行爬虫与结果验证
切换至工程根目录hpty,在终端运行采集指令:
scrapy crawl sww控制台输出日志显示成功匹配行数即为抓取完成状态。返回MySQL客户端执行SELECT COUNT(*) FROM nba;核对记录数,或查询任意字段确认数据完整性。若返回空值,请检查settings.py中Pipeline路由是否正确指向当前文件名。
总结
通过以上步骤,我们完成了从页面结构分析、Scrapy工程搭建、字段映射到MySQL自动化入库的全链路配置。掌握XPath定位与Pipeline事务提交机制后,该模板可快速复用于其他列表型网页的数据抓取任务。以上就是使用Scrapy框架爬取网页并保存到MySQL的详细流程,更多关于Python爬虫开发与数据库对接的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















