


Python并发编程多进程多线程与GIL机制解析

本文系统梳理Python并发编程的核心概念,厘清并发与并行的实际差异。通过标准库实操对比,验证多线程在IO密集型任务与多进程在CPU密集型任务中的性能优势,并结合GIL机制分析Python并行限制的根本原因,为项目架构选型提供量化参考。
并发与并行的核心差异
并发(Concurrency)与并行(Parallelism)常被混淆,但二者在调度逻辑上存在本质区别。并行强调多个独立任务在同一时刻同时执行,彼此互不干扰,主要依赖多核硬件资源。而并发则是多个任务在同一时间段内交替执行,操作系统通过时间片轮转或上下文切换实现协作,同一时刻通常只有一个任务处于运行状态。
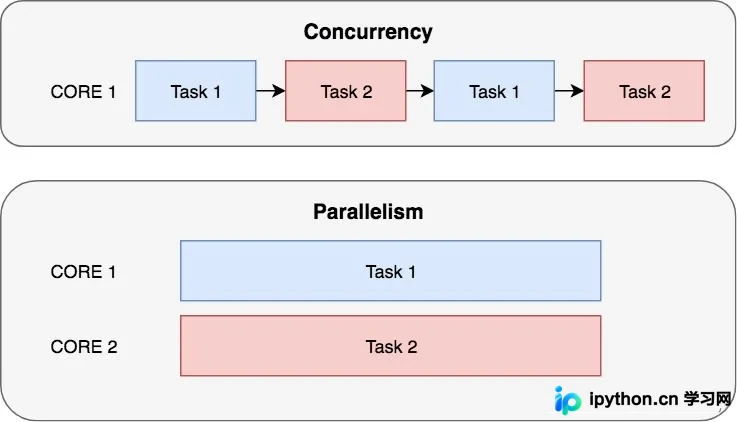
在等待I/O操作完成时,并发调度会利用这段空闲期启动其他独立代码块,从而隐藏延迟。需要注意的是,受限于CPython解释器的设计,Python目前的"并行"更多是一种宏观上的并发假象,底层仍受全局解释器锁制约。
进程与线程的适用场景
进程(Process)是操作系统分配内存资源的独立单位,各进程间数据隔离,通信成本较高。线程(Thread)是CPU调度的最小单元,隶属于特定进程,共享进程的堆内存与文件描述符,创建与切换开销极小。
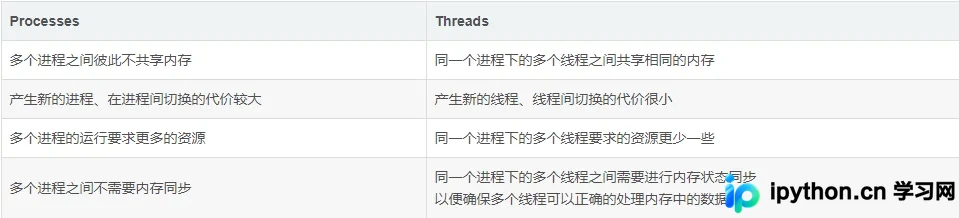
基于上述特性,开发实践中遵循一条明确准则:I/O密集型任务(如网络请求、文件读写)优先选用多线程,以快速释放阻塞等待期的资源;CPU密集型任务(如大量数学运算、图像处理)优先选用多进程,以绕过解释器锁的限制,充分榨取多核算力。
第1步:掌握核心并发编程模块
Python标准库与主流生态提供了丰富的并发工具,可按需引入:
threading:高级多线程封装,API直观,适合轻量级并发与I/O阻塞处理。multiprocessing:多进程专用模块,接口设计与threading高度一致,自动管理子进程生命周期。concurrent.futures:面向未来的异步抽象层,支持线程池与进程池,可通过统一接口管理异步任务队列。queue:内置线程安全队列,用于生产者-消费者模型中的数据交换,天然规避竞态条件。celery:分布式任务队列框架,底层依赖多进程或协程,适用于跨节点的大型异步计算场景。
第2步:编写基准测试对比执行效率
为验证不同方案的真实表现,可定义模拟I/O阻塞的only_sleep()函数与模拟CPU计算的crunch_numbers()函数,分别以串行、多线程、多进程三种模式执行4次迭代,记录耗时差异。
import time
import datetime
import logging
import threading
import multiprocessing

FORMAT = "%(asctime)s [%(processName)s %(process)d] %(threadName)s %(thread)d <=%(message)s=>"
logging.basicConfig(format=FORMAT, level=logging.INFO, datefmt='%H:%M:%S')

def only_sleep():
    logging.info('in only_sleep function')
    time.sleep(1)

def crunch_numbers():
    logging.info('in crunch_numbers function')
    x = 0
    while x < 1000000:
        x += 1

if __name__ == '__main__':
    work_repeat = 4

    for func in (only_sleep, crunch_numbers):
        task_name = 'only_sleep' if func.__name__ == 'only_sleep' else 'crunch_numbers'
        print(f'==>> {task_name} function test')

        # 串行执行
        start1 = datetime.datetime.now()
        for _ in range(work_repeat):
            func()
        stop1 = datetime.datetime.now()
        delta1 = (stop1 - start1).total_seconds()
        print(f'Serial Execution takes {delta1:.4f} seconds~')

        # 多线程执行
        start2 = datetime.datetime.now()
        thread_lst = [threading.Thread(target=func, name=f'thread-worker{i}') for i in range(work_repeat)]
        [thd.start() for thd in thread_lst]
        [thd.join() for thd in thread_lst]
        stop2 = datetime.datetime.now()
        delta2 = (stop2 - start2).total_seconds()
        print(f'Multi-Threads takes {delta2:.4f} seconds~')

        # 多进程执行
        start3 = datetime.datetime.now()
        proc_lst = [multiprocessing.Process(target=func, name=f'process-worker{i}') for i in range(work_repeat)]
        [p.start() for p in proc_lst]
        [p.join() for p in proc_lst]
        stop3 = datetime.datetime.now()
        delta3 = (stop3 - start3).total_seconds()
        print(f'Multi-Processing takes {delta3:.4f} seconds~')
        print('-' * 40)
在标准环境下的典型运行日志如下:
==> only_sleep function test
Serial Execution takes 4.0228 seconds~
Multi-Threads takes 1.0142 seconds~
Multi-Processing takes 1.1147 seconds~
----------------------------------------
==> crunch_numbers function test
Serial Execution takes 0.1786 seconds~
Multi-Threads takes 0.1951 seconds~
Multi-Processing takes 0.1552 seconds~执行结果直接印证了选型原则:I/O任务多线程耗时骤降至单线程的1/4左右,而多进程因创建开销略高,仅微弱优于线程;CPU任务多线程受GIL限制反而比串行更慢,多进程则凭借独立内存空间完美发挥多核优势,耗时最短。
GIL机制的运行逻辑与突破路径
GIL(Global Interpreter Lock,全局解释器锁)是CPython解释器的基石之一。其核心设计初衷是保障线程安全,简化内存管理与垃圾回收的同步逻辑。由于持有了这把互斥锁,CPython在同一时刻只能允许一个线程执行字节码,导致同一进程内的多个Python线程无法真正并行。
这种设计牺牲了原生多核并行能力,换来了极高的基础稳定性与外部C扩展集成的便利性。对于纯Python编写的CPU密集型代码,GIL确实是性能瓶颈。但需注意,许多底层数值计算库(如numpy、pandas)在执行核心算法时会主动释放GIL,转而调用C语言编译的机器指令,因此它们在处理大规模矩阵运算时仍能实现真正的硬件级并行。
若业务强依赖多核并行且无法借助C扩展优化,开发者应果断将架构升级为多进程模型,或转向Jython、IronPython等无GIL限制的解释器环境,亦可直接将核心循环剥离至独立服务中调用。
以上就是Python并发编程中多进程、多线程与GIL机制的详细解析,更多关于Python并发优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















