


Python用pdfplumber提取PDF表格数据并保存至Excel

本文介绍如何使用Python第三方库pdfplumber读取PDF文件,通过内置方法定位并提取表格内容,结合openpyxl模块清洗异常字符后,自动将多页表格数据导出为标准Excel文件。涵盖环境配置、API差异对比及完整可运行脚本,满足日常文档批量转换需求。
准备条件与依赖安装
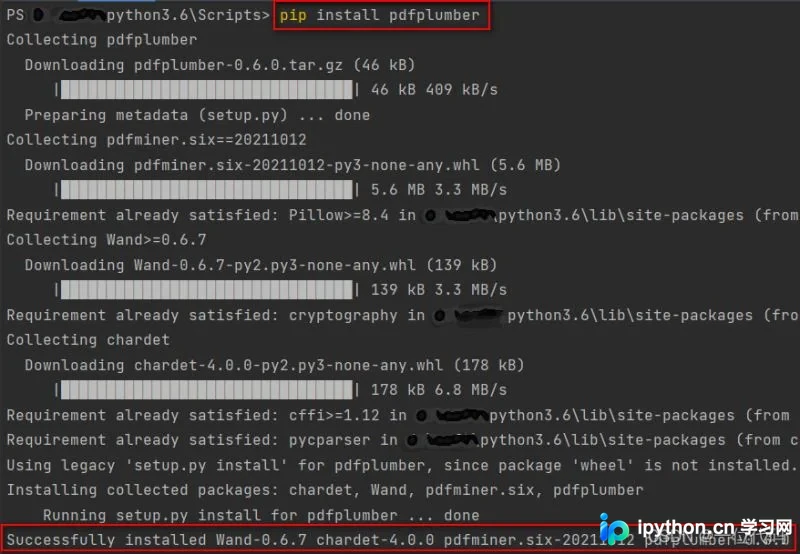
完成PDF到Excel的转换需要两个核心Python包:pdfplumber负责解析PDF结构与提取文本/表格,openpyxl负责生成和写入Excel工作簿。在命令行或终端中执行以下安装指令:
pip install pdfplumber openpyxl
安装成功后,验证环境可用性:
确认无误后,在Python脚本顶部导入模块:
import pdfplumber
from openpyxl import Workbook
第1步:初始化PDF对象并核对文件信息
使用pdfplumber.open()加载目标文件,该方法返回包含全文档信息的实例。若文件受密码保护,需传入password参数。
pdf_info = pdfplumber.open(r'test.pdf')
meta_data = pdf_info.metadata
page_con = len(pdf_info.pages)
print('pdf文件的基础信息:\n', meta_data)
print('pdf共%s页' % page_con)

此时可观察终端输出,若返回字典格式的基本信息与准确页数,说明文件已成功挂载。
第2步:选择正确的表格提取策略
演示所用PDF样本结构如下:
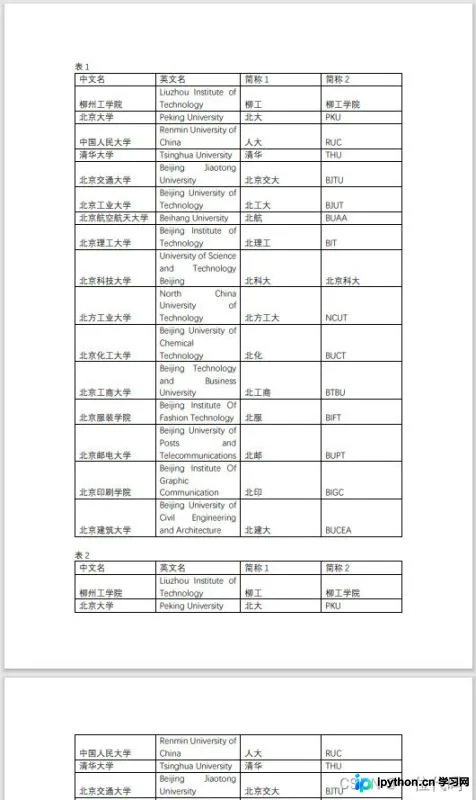
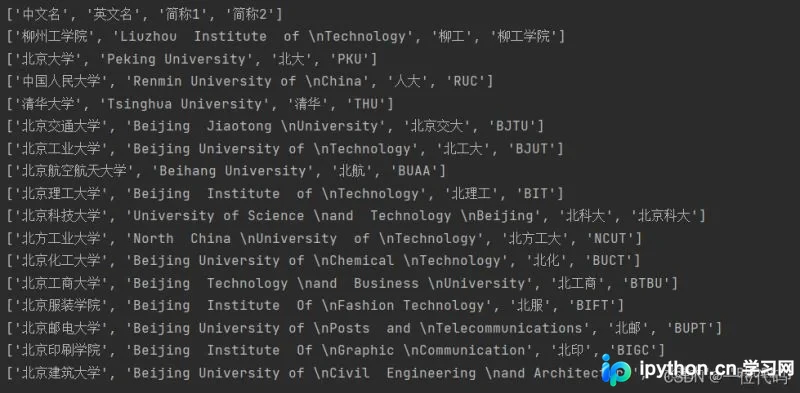
(1)extract_tables() 方法:适用于单页存在多个独立表格的场景。它遍历当前页所有符合网格条件的区域,返回嵌套列表,层级结构严格遵循 [table][row][cell]。
with pdfplumber.open(r'test.pdf') as pdf_info:
    page_one = pdf_info.pages[0]
    page_one_table = page_one.extract_tables()
    for row in page_one_table:
       print('第一页的表格数据:', row)

(2)extract_table() 方法:当页面仅含一个主表格或只需提取最大区块时使用。它忽略边缘小字或非标准网格,返回 [row][cell] 结构。若存在多个同尺寸表格,默认返回位于顶部的区块。
with pdfplumber.open(r'test.pdf') as pdf_info:
    page_one = pdf_info.pages[0]
    page_one_table = page_one.extract_table()
    for row in page_one_table:
        print(row)
第3步:封装完整转换逻辑
将上述流程整合为类结构,可实现自动遍历所有页面、过滤换行符并导出Excel。操作前请确保目标目录无重名文件,以免覆盖原有数据。
class PDF(object):
    def __init__(self, file_path):
        self.pdf_path = file_path
        try:
            self.pdf_info = pdfplumber.open(self.pdf_path)
            print('读取文件完成!')
        except Exception as e:
            print('读取文件失败:', e)

    def get_table(self):
        wb = Workbook()
        ws = wb.active
        con = 0
        try:
            # 遍历每一页并提取表格
            for page in self.pdf_info.pages:
                for table in page.extract_tables():
                    for row in table:
                        # 清洗单元格内的回车符,替换为空格以保持表格排版整洁
                        row_list = [cell.replace('\n', ' ') if cell else '' for cell in row]
                        ws.append(row_list)
                con += 1
                print('---------------分割线,第%s页---------------' % con)
        except Exception as e:
            print('报错:', e)
        finally:
            # 自动将Excel保存至与原PDF同级目录
            save_dir = '\\'.join(self.pdf_path.split('\\')[:-1])
            save_path = save_dir + '\\pdf_excel.xlsx'
            wb.save(save_path)
            print('写入完成!')
            self.close_pdf()

    def close_pdf(self):
        self.pdf_info.close()

if __name__ == "__main__":
    file_path = input('请输入pdf文件路径:')
    pdf_app = PDF(file_path)
    pdf_app.get_table()
脚本运行后输入完整路径,系统会自动执行页面遍历、数据清洗与文件落盘。
完成判断与排错建议
执行完毕后,检查终端是否提示“写入完成!”。打开生成的 pdf_excel.xlsx,核对行数、列数是否与源文档一致,重点确认跨页断行的数据是否被正确拼接而非截断。若提取结果为空或结构错位,通常由PDF本身为扫描版图片导致(非文字层PDF),此时需配合OCR工具预处理后再调用本脚本。此外,加密PDF需在初始化时补充密码参数,否则抛出权限异常。
简要总结
通过合理选型 extract_tables 与 extract_table,辅以 openpyxl 的路径控制,可高效搭建本地文档转换流水线。避免硬编码路径与未清理的特殊字符是保证输出质量的关键。
以上就是使用Python结合pdfplumber提取PDF表格并保存至Excel的详细内容,更多关于Python办公自动化处理文档的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















