


图文详解梯度下降算法的原理及Python实现

本文深入解析梯度下降算法原理,对比传统数值解法的局限性,如局部最优和收敛效率问题。通过泰勒展开推导学习率公式,并展示Python代码在Logistic回归中的应用,帮助读者掌握算法核心逻辑与工程实现细节。
1.引例
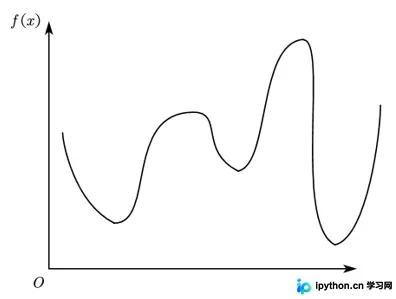
假设存在一个如图所示的函数,如何利用计算机算法编程求解其最小值f(x)min?
2.数值解法
传统的解决思路是数值解法,具体过程如图所示。
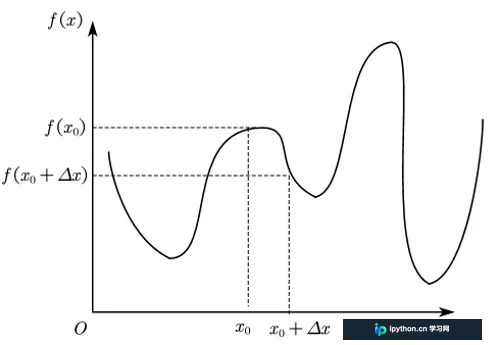
该过程遵循以下步骤进行迭代循环,直至找到最优解:
① 首先任意给定一个初始值x0;
② 随机生成增量方向,并结合设定的步长生成增量Δx;
③ 计算并比较f(x0)与f(x0+Δx)的大小,若f(x0+Δx)<f(x0)则更新当前位置,否则重新生成增量Δx;
④ 重复执行步骤②和③,直到算法收敛至最优解f(x)min。
数值解法的主要优势在于编程逻辑简明,但其缺陷同样显著:
① 初始值的选择对结果收敛的速度有巨大影响;
② 由于增量方向是随机生成的,导致搜索效率较低;
③ 算法容易陷入局部最优解而无法跳出;
④ 该方法无法有效处理具有“高原”特征的函数。
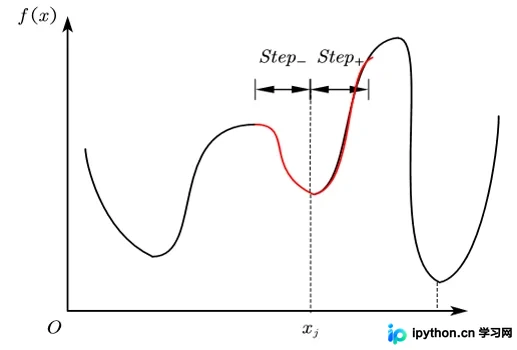
所谓陷入局部最优解,是指当迭代过程进入某个极小值或其邻域时,由于步长选择不当,无论向正方向还是负方向移动,函数值的变化都不如当前状态,从而导致无法继续向全局最优解迭代。就本问题而言,如图所示,当迭代陷入x=xj时,受限于学习步长step,无法使f(xj±Step)<f(xj),因此迭代被锁定在图中的红色区段。可以看出x=xj并非期望的全局最优解。
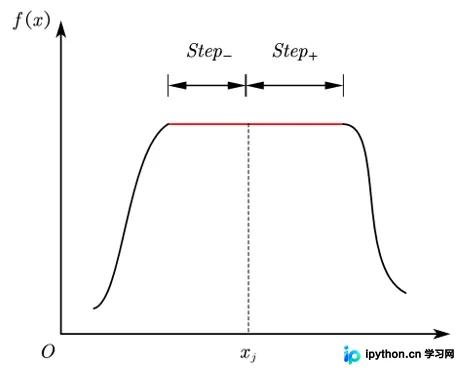
若遇到下图所示的“高原”函数区域,迭代过程也可能因无法获得更优解而停止更新。
3.梯度下降算法
梯度下降算法可视为对传统数值解法的一种改进,具体阐述如下:
记第k轮迭代后,自变量更新为x=xk,令目标函数f(x)在x=xk处进行泰勒展开:
f(x)=f(xk)+f′(xk)(x−xk)+o(x)
考察f(x)min,我们期望f(xk+1)<f(xk),从而得出:
f(xk+1)−f(xk)=f′(xk)(xk+1−xk)<0
若f′(xk)>0则xk+1<xk,即迭代方向为负;反之则为正。不妨设xk+1−xk=−f′(xk),从而保证f(xk+1)−f(xk)<0。必须指出,泰勒公式成立的前提条件是x→x0,因此|f′(xk)|不能过大,否则xk+1与xk距离过远会产生余项误差。为此引入学习率γ∈(0,1)来减小偏移度,即xk+1-xk=−γf′(xk)
在工程实践中,学习率γ需要结合实际应用场景合理选择。若γ过大,迭代过程会在极小值两侧发生振荡,导致算法无法收敛;若γ过小,则会降低学习效率,使算法收敛速度变慢。
对于向量情况,将上述迭代公式推广为:
xk+1=xk−γ∇xk
其中
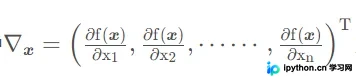
为多元函数的梯度,因此该迭代算法也被称为梯度下降算法。
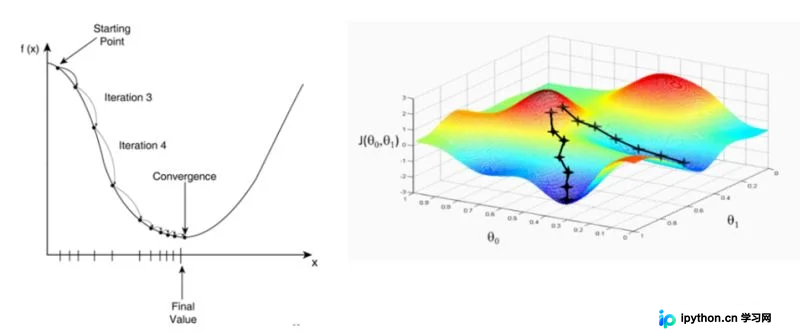
梯度下降算法通过函数梯度确定了每一次迭代的方向和步长,从而提高了算法效率。但从原理层面分析,该算法并不能从根本上解决数值解法中初值设定敏感、易陷局部最优以及部分函数锁死等问题。
4.代码实战:Logistic回归
import pandas as pd
import numpy as np
import os
import matplotlib.pyplot as plt
import matplotlib as mpl
from Logit import Logit

'''
* @breif: 从CSV中加载指定数据
* @param[in]: file -> 文件名
* @param[in]: colName -> 要加载的列名
* @param[in]: mode -> 加载模式, set: 列名与该列数据组成的字典, df: df类型
* @retval: mode模式下的返回值
'''
def loadCsvData(file, colName, mode='df'):
    assert mode in ('set', 'df')
    df = pd.read_csv(file, encoding='utf-8-sig', usecols=colName)
    if mode == 'df':
        return df
    if mode == 'set':
        res = {}
        for col in colName:
            res[col] = df[col].values
        return res

if __name__ == '__main__':
    # ============================
    # 读取CSV数据
    # ============================
    csvPath = os.path.abspath(os.path.join(__file__, "../../data/dataset3.0alpha.csv"))
    dataX = loadCsvData(csvPath, ["含糖率", "密度"], 'df')
    dataY = loadCsvData(csvPath, ["好瓜"], 'df')
    label = np.array([
        1 if i == "是" else 0
        for i in list(map(lambda s: s.strip(), list(dataY['好瓜'])))
    ])

    # ============================
    # 绘制样本点
    # ============================
    line_x = np.array([np.min(dataX['密度']), np.max(dataX['密度'])])
    mpl.rcParams['font.sans-serif'] = [u'SimHei']
    plt.title('对数几率回归模拟\nLogistic Regression Simulation')
    plt.xlabel('density')
    plt.ylabel('sugarRate')
    plt.scatter(dataX['密度'][label==0],
                dataX['含糖率'][label==0],
                marker='^',
                color='k',
                s=100,
                label='坏瓜')
    plt.scatter(dataX['密度'][label==1],
                dataX['含糖率'][label==1],
                marker='^',
                color='r',
                s=100,
                label='好瓜')

    # ============================
    # 实例化对数几率回归模型
    # ============================
    logit = Logit(dataX, label)

    # 采用梯度下降法
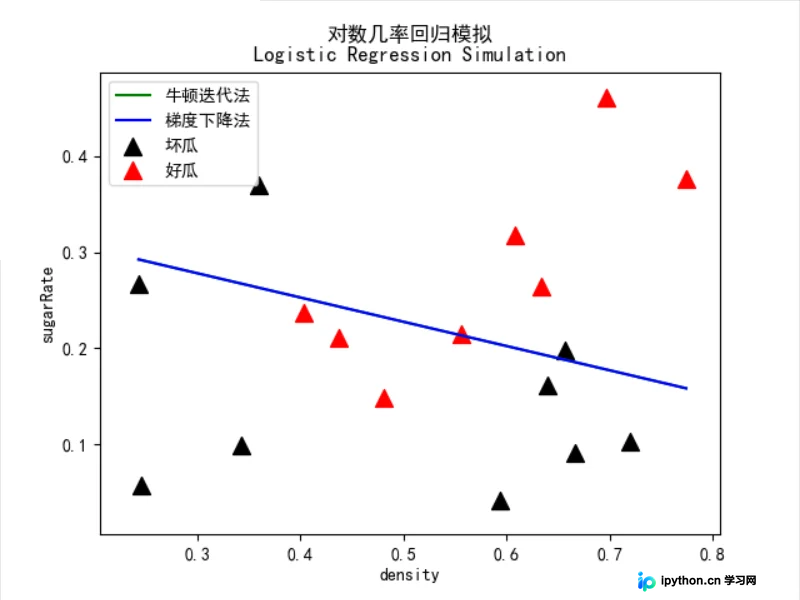
    logit.logitRegression(logit.gradientDescent)
    line_y = -logit.w[0, 0] / logit.w[1, 0] * line_x - logit.w[2, 0] / logit.w[1, 0]
    plt.plot(line_x, line_y, 'b-', label="梯度下降法")

    # 绘图
    plt.legend(loc='upper left')
    plt.show()
到此这篇关于图文详解梯度下降算法的原理及Python实现的文章就介绍到这了,更多相关Python梯度下降算法内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















