


Java利用哈夫曼编码实现字符串压缩完整指南

哈夫曼编码是一种经典的变长无损压缩算法,广泛用于提升数据存储效率。在Java开发中,掌握其核心逻辑有助于理解底层数据处理。本文将通过实例演示,从字符频率统计到哈夫曼树的构建,再到最终的编码转换,提供一套完整且可直接运行的代码方案,解决Java字符串高效压缩的技术需求。
1. 哈夫曼编码原理概述
哈夫曼编码(Huffman Coding),又称霍夫曼编码,由大卫·哈夫曼于1952年提出,属于可变字长编码(VLC)。其核心优势在于对出现频率高的字符分配较短的编码,频率低的分配较长的编码,从而实现整体数据的最大程度压缩,压缩率通常在20%~90%之间。
三种编码方式的对比:
- 定长编码:无论字符出现频率如何,均使用固定位数(如8位ASCII码),空间利用率低。
- 变长编码:根据频率调整长度,但可能出现解码歧义。
- 哈夫曼编码:基于二叉树路径生成前缀编码,既实现变长又确保唯一可解码性。
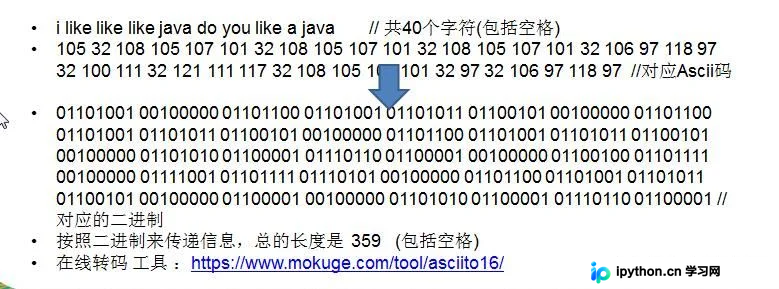
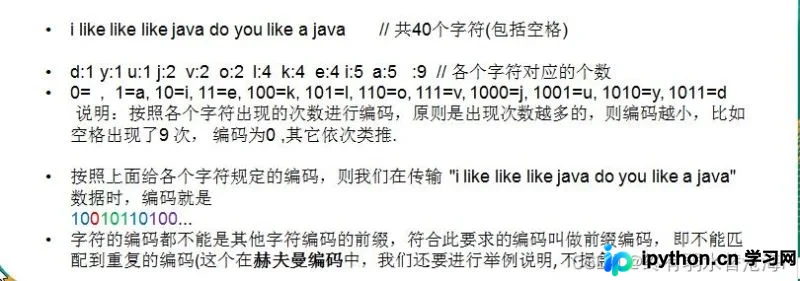
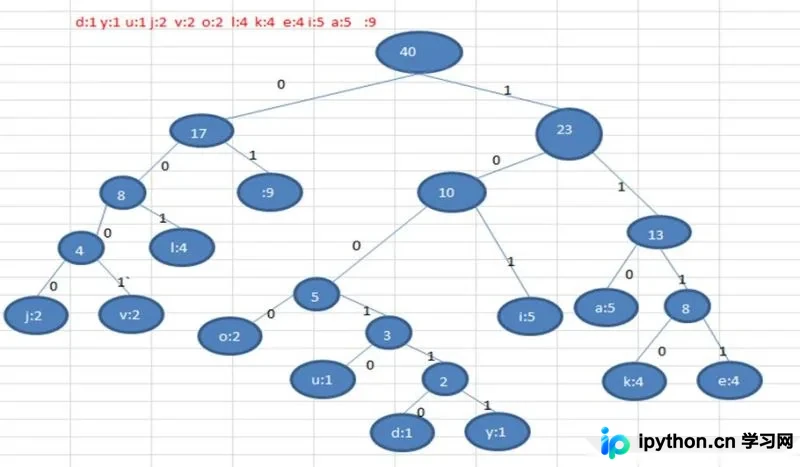
以下列为例分析:i like like like java do you like a java
- 统计字符权重:空格(:)出现9次,'i'出现5次,'a'出现5次,以此类推。
- 构建哈夫曼树:将所有字符及其频率作为叶子节点,通过反复选取权值最小的两个节点合并,直到形成一棵包含所有字符的二叉树。
- 生成编码:规定左子树分支为 '0',右子树分支为 '1',从根节点到叶子节点的路径即为该字符的编码。
2. 核心数据结构:节点类定义
构建哈夫曼树的基础是节点类。我们需要一个实现 Comparable<Node> 接口的类,以便后续能对节点集合按权重(frequency)进行排序。
public class Node implements Comparable<Node> {
    Byte data; // 存储字符的ASCII码
    int weight; // 字符出现的次数(权重)
    Node left;
    Node right;

    public Node(Byte data, int weight) {
        this.data = data;
        this.weight = weight;
    }

    @Override
    public String toString() {
        return "Node{" + "data=" + data + ", weight=" + weight + '}';
    }

    @Override
    public int compareTo(Node o) {
        // 升序排列,权值小的排在前面
        return this.weight - o.weight;
    }

    // 前序遍历辅助方法
    public void prefixOrder(){
        System.out.println(this);
        if (this.left != null) this.left.prefixOrder();
        if (this.right != null) this.right.prefixOrder();
    }
}
3. 第一步:统计字符频率并初始化列表
首先将输入字符串转换为字节数组,统计每个字符的出现次数,并将其封装为 Node 对象存入列表。注意,此处使用 Map<Character, Integer> 暂存统计结果,随后转为有序列表。
public static List<Node> totalCharCounts(String str) {
    Map<Character, Integer> map = new HashMap<>();
    for (int i = 0; i < str.length(); i++) {
        char ch = str.charAt(i);
        Integer count = map.get(ch);
        if (count == null) { count = 0; }
        map.put(ch, count + 1);
    }

    Set<Map.Entry<Character, Integer>> mapSet = map.entrySet();
    List<Node> nodeList = new ArrayList<>();
    for (Map.Entry<Character, Integer> set : mapSet) {
        // 将字符转为Byte,因为哈夫曼树处理的是原始字节
        Node node = new Node((byte) set.getKey().charValue(), set.getValue());
        nodeList.add(node);
    }
    // 关键点:必须排序,保证每次取出的都是权值最小的两个节点
    Collections.sort(nodeList);
    return nodeList;
}
4. 第二步:构建哈夫曼树
构建过程是一个贪心算法循环:
1. 从列表中取出权值最小的两个节点(头部的两个)。
2. 创建一个新的父节点,其权值为两子节点之和,数据为空。
3. 将这两个子节点从列表中移除,并添加新创建的父节点。
4. 重新对列表排序,重复上述步骤,直到列表中只剩一个节点,即为根节点。
public static Node createHuffmanTree(List<Node> nodeList) {
    while (nodeList.size() > 1) {
        Node left = nodeList.get(0);
        Node right = nodeList.get(1);
        // 创建父节点,权值相加
        Node parent = new Node(null, left.weight + right.weight);
        parent.left = left;
        parent.right = right;

        // 移除已处理的子节点
        nodeList.remove(left);
        nodeList.remove(right);
        // 加入新的父节点
        nodeList.add(parent);
        // 重新排序
        Collections.sort(nodeList);
    }
    return nodeList.get(0); // 返回根节点
}
5. 第三步:生成哈夫曼编码表
生成编码需要遍历整棵树。通常采用递归方式,左分支拼接 "0",右分支拼接 "1"。当到达叶子节点时,路径即为该字符的哈夫曼编码。
// 全局缓存编码表
public static Map<Byte, String> huffmanCodes = new HashMap<>();
public static StringBuffer stringBuffer = new StringBuffer();

private static void getHuffmanCompressionCode(Node node, String code, StringBuffer stringBuffer) {
    StringBuffer stringBuffer1 = new StringBuffer(stringBuffer);
    stringBuffer1.append(code);

    if (node != null) {
        if (node.data == null) {
            // 非叶子节点:继续向左(0)和向右(1)递归
            getHuffmanCompressionCode(node.left, "0", stringBuffer1);
            getHuffmanCompressionCode(node.right, "1", stringBuffer1);
        } else {
            // 叶子节点:保存路径编码
            huffmanCodes.put(node.data, stringBuffer1.toString());
        }
    }
}
6. 第四步:执行压缩与字节转换
得到编码表后,即可将原始字符串的每一个字节替换为其对应的哈夫曼编码字符串。由于网络传输或存储通常以字节(8位)为单位,需要将长的二进制字符串切割成8位一组,转换为 byte。
public static byte[] zip(byte[] bytes, Map<Byte, String> huffmanCodes) {
    // 1. 拼接所有字符的哈夫曼编码
    StringBuffer sb = new StringBuffer();
    for (byte b : bytes) {
        sb.append(huffmanCodes.get(b));
    }

    // 2. 计算压缩后的byte数组长度(向上取整)
    int len = (int) Math.ceil(sb.length() * 1.0 / 8);
    byte[] huffmanBytes = new byte[len];
    int index = 0;

    // 3. 按8位截取并转换
    for (int i = 0; i < sb.length(); i += 8) {
        String strByte;
        if (i + 8 > sb.length()) {
            strByte = sb.substring(i);
        } else {
            strByte = sb.substring(i, i + 8);
        }
        // 将二进制字符串转为十进制数,强转byte
        huffmanBytes[index] = (byte) Integer.parseInt(strByte, 2);
        index++;
    }
    return huffmanBytes;
}
7. 验证与测试
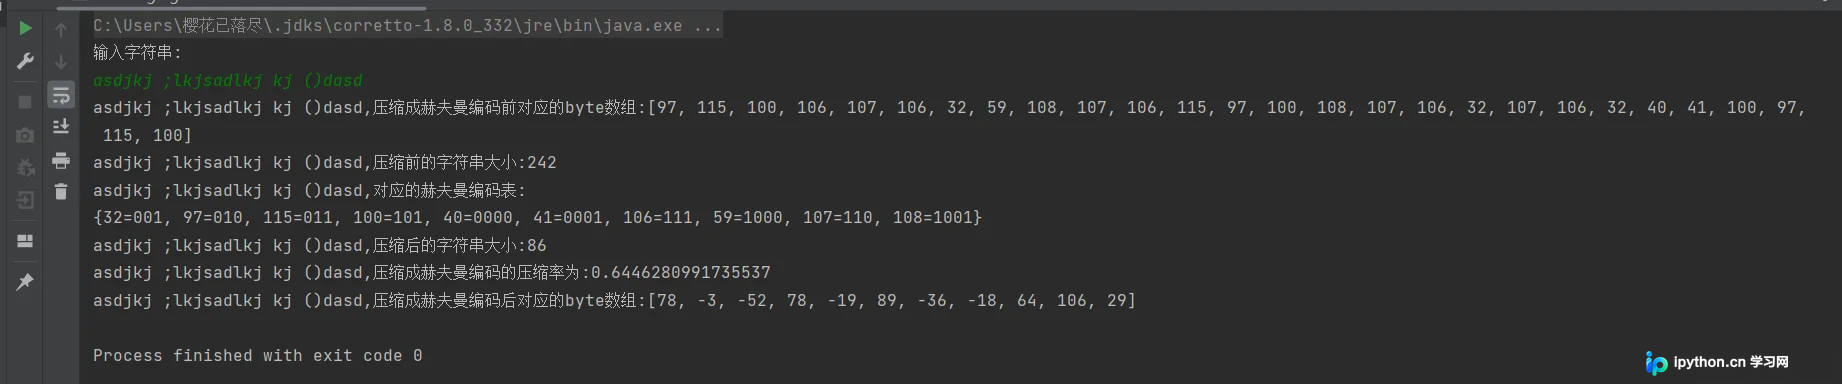
在主函数中输入示例字符串,程序将输出压缩前后的编码大小以及最终的压缩字节数组。这展示了哈夫曼编码在处理重复率高文本时的显著优势。
测试用例 1:
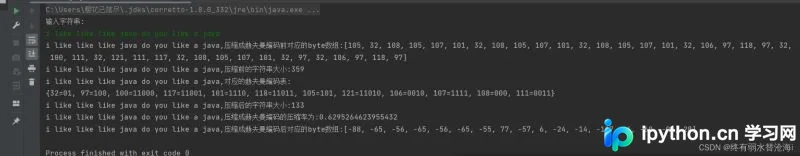
输入: i like like like java do you like a java
结果显示:原始字符串未压缩前占用的二进制位数远大于哈夫曼编码后的位数,实现了有效压缩。
测试用例 2:
输入: asdjkj ;lkjsadlkj kj ()dasd
总结
本教程涵盖了从理论到Java实现的完整链路。重点在于理解“贪心策略”构建二叉树以及“二进制转字节”的细节处理。以上就是Java利用哈夫曼编码实现字符串压缩的详细内容,更多关于Java基础算法与数据结构的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















