


Java数据结构之图:概念、存储结构与代码实现

发布时间:2026-10-15 |
2人浏览过
图数据结构广泛应用于地图导航、社交网络等场景。本文在讲解图的基本定义与术语后,深入分析邻接矩阵与邻接表的存储差异,并重点展示如何使用Java集合框架中的Queue实现高效的无向图,为后续路径搜索算法奠定基础。
图的实际应用场景
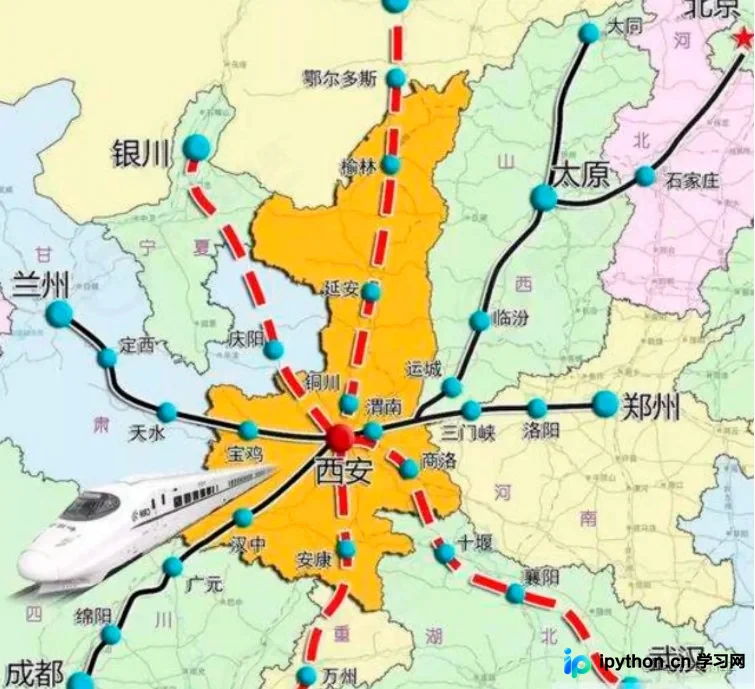
在现实世界中,许多问题涉及大量的点以及它们之间的连接关系。例如,城市交通网络由城市和道路组成:将城市抽象为“顶点”,道路抽象为“边”,即可将其建模为图结构。
图的定义与分类
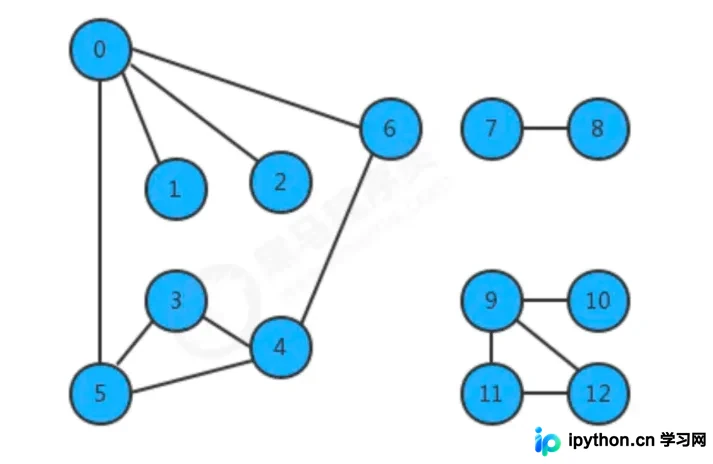
定义: 图(Graph)是由一组顶点(Vertices)和一组连接两个顶点的边(Edges)组成的集合。
特殊结构:
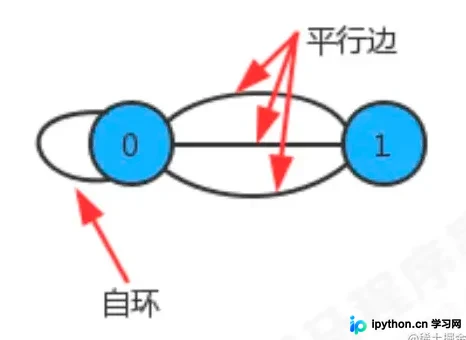
- 自环(Self-loop): 一条连接顶点与其自身的边。
- 平行边(Parallel edges): 连接同一对顶点的多条边。
分类:
- 无向图: 边没有方向,仅表示两个顶点相连。
- 有向图: 边具有方向性,表示从一个顶点指向另一个顶点。
核心术语解析
理解图算法前,需掌握以下关键术语:
- 相邻顶点: 若两顶点通过一条边相连,则互为相邻顶点,该边依附于这两个顶点。
- 度(Degree): 依附于某顶点的边的总数。在无向图中即为相邻顶点的数量。
- 子图: 包含原图部分顶点及其对应边的图。
- 路径: 由边顺序连接的一系列顶点。
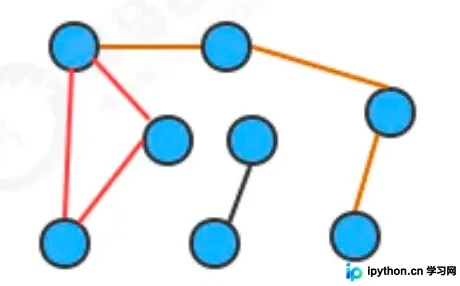
- 环(Cycle): 起点与终点相同,且至少含有一条边的路径。
- 连通性: 若任意两顶点间存在路径,则为连通图;非连通图的每个连通部分称为连通子图。
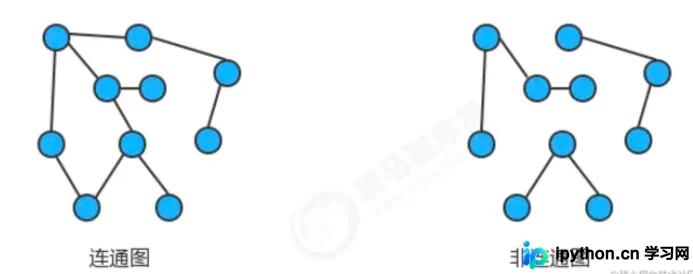
图的存储结构
表示一幅图需要明确两部分内容:顶点列表与边列表。常见的存储方式有两种:邻接矩阵和邻接表。
邻接矩阵
使用一个 V * V 的二维数组 int[V][V] 表示。若顶点 v 和 w 相连,则 adj[v][w] 设为1(否则为0)。对于无向图,矩阵关于主对角线对称。
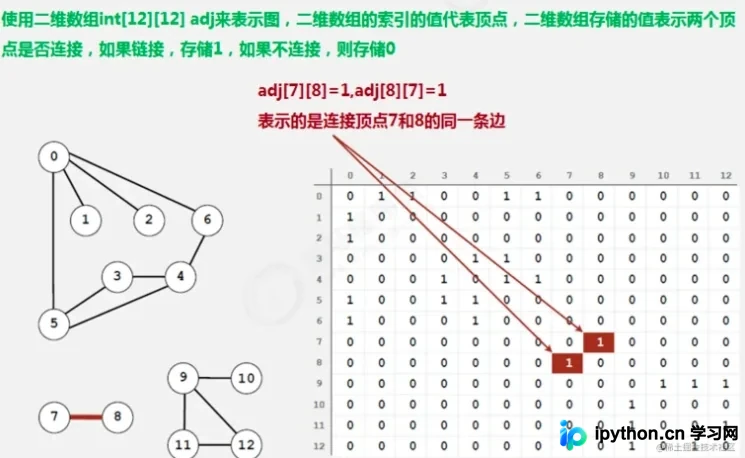
缺点: 空间复杂度为 $O(V^2)$。当顶点数量庞大但边数稀疏时,会浪费大量内存。
邻接表
使用大小为 V 的数组 Queue[V] adj。每个索引 adj[v] 存储一个队列,保存所有与顶点 v 相邻的其他顶点。
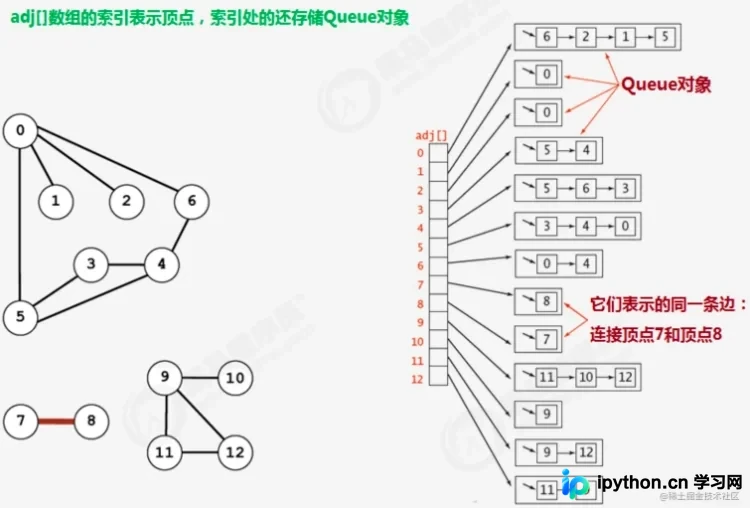
优势: 空间复杂度为 $O(V+E)$,呈线性级别,更适合处理大规模稀疏图。后续实现将采用此方法。
Java代码实现
下面通过代码构建一个支持添加边和查询邻接点的无向图类。
API设计
| 类名 | Graph |
|---|---|
| 成员变量 |
|
| 构造方法 | Graph(int V): 初始化包含V个顶点但不含边的图 |
| 成员方法 |
|
完整实现
/**
 * 无向图的表示
 */
import java.util.Queue;
import java.util.ArrayDeque;

public class Graph {
    // 顶点数目
    private final int V;
    // 边的数目
    private int E;
    // 邻接表,使用ArrayDeque作为队列实现
    private Queue<Integer>[] adj;

    /**
     * 创建一个包含V个顶点但不包含边的图
     * @param V 顶点数量
     */
    public Graph(int V) {
        this.V = V;
        this.E = 0;
        // 创建泛型数组需进行强制转换
        this.adj = new Queue[V];
        // 初始化每个顶点对应的邻接队列
        for (int i = 0; i < adj.length; i++) {
            adj[i] = new ArrayDeque<>();
        }
    }

    /**
     * 向图中添加一条边 v-w
     * 无向图需在v和w之间双向添加
     * @param v 顶点v
     * @param w 顶点w
     */
    public void addEdge(int v, int w) {
        // 把w添加到v的链表中
        adj[v].add(w);
        // 把v添加到w的链表中
        adj[w].add(v);
        // 边的总数加1
        E++;
    }

    /**
     * 获取图中顶点的数量
     * @return 顶点数
     */
    public int V() {
        return V;
    }

    /**
     * 获取图中边的数量
     * @return 边数
     */
    public int E() {
        return E;
    }

    /**
     * 返回与顶点v相邻的所有顶点
     * @param v 目标顶点
     * @return 邻接点队列
     */
    public Queue<Integer> adj(int v) {
        return adj[v];
    }
}
在上述实现中,数组 adj 的索引直接代表顶点编号。这种基于队列的邻接表结构不仅节省空间,还便于遍历与访问邻居节点。
以上就是Java数据结构之图的基础概念和数据模型详解的详细内容,更多关于Java数据结构图的文章资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















