


MySQL批量插入数据时如何处理重复记录

在大数据量导入或高频写入场景下,避免重复插入是保障数据一致性的关键。MySQL 提供了三种基于主键或唯一键冲突的处理语句:忽略冲突、删除后重新插入、冲突时更新字段。本文将深入解析这三种语法的行为差异、适用边界以及在主从架构下的潜在陷阱,指导技术选型。
前置条件与测试环境
使用上述去重语句的前提是目标表中必须存在 PRIMARY KEY 主键约束或 UNIQUE 唯一索引。若无此类约束,这些语句将退化为普通的 INSERT INTO,无法产生去重效果。
第1步:确认表结构
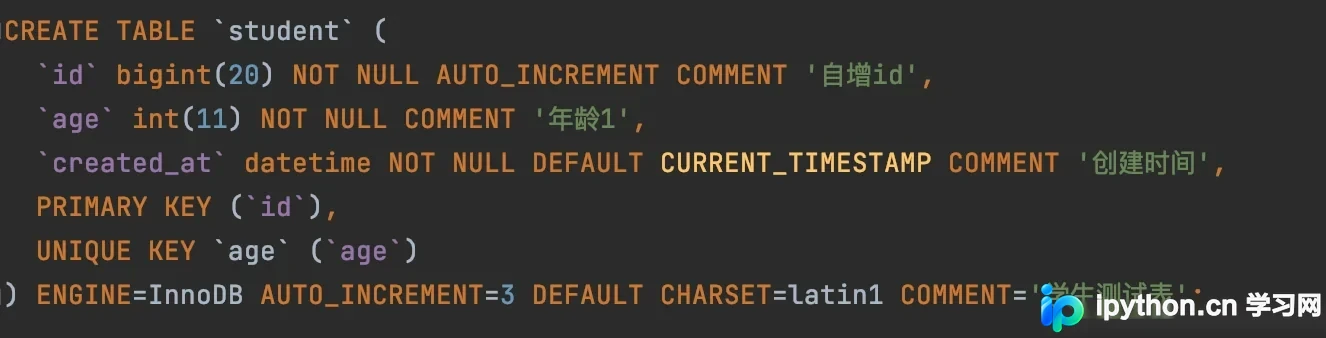
测试需依赖包含主键或唯一键的表。假设我们有一张学生表,结构如下:
第2步:初始化测试数据
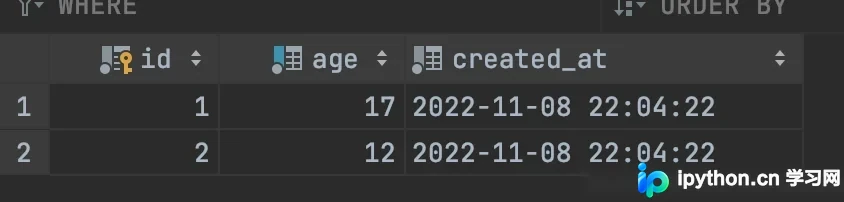
为了验证后续操作的效果,预先向表中插入若干基础数据作为参照:
三种核心去重策略详解
当发生主键或唯一键冲突时,根据业务需求不同,通常采用以下三种处理方式。
第1步:静默忽略冲突 —— INSERT IGNORE INTO
目的: 保留旧数据,丢弃新插入的记录,追求高吞吐量且不关心失败数据。
入口与动作: 在标准插入语句前添加 IGNORE 关键字。若依据主键/唯一键判断数据已存在,则 MySQL 直接跳过该条记录,不报错也不更新;若不存在,则正常执行插入。
代码示例:
INSERT IGNORE INTO student(age) VALUES (12),(13);
可观察结果:
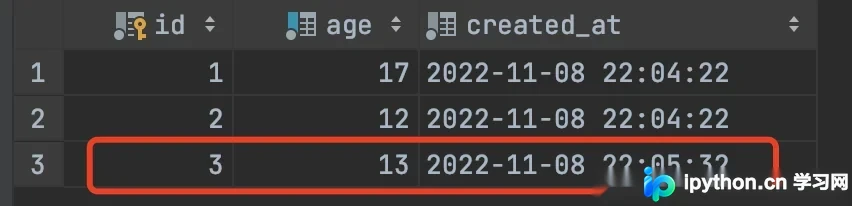
如上例所示,age=12 因已存在被忽略(时间戳未变);age=13 不存在,成功插入。此方法简单粗暴,适合“尽力而为”的日志类或非强一致性数据写入。
第2步:冲突时更新字段 —— INSERT ... ON DUPLICATE KEY UPDATE
目的: 实现“有则更新,无则插入”(Upsert),保持数据最新状态。
入口与动作: 在语句末尾指定 ON DUPLICATE KEY UPDATE 子句。若发生键冲突,MySQL 不会执行 DELETE+INSERT,而是直接执行指定的 UPDATE 操作;若无冲突,则执行 INSERT。
代码示例:
INSERT INTO student(age) VALUES (12),(13)
ON DUPLICATE KEY UPDATE student.created_at = '2022-01-01 00:00:00';
可观察结果:
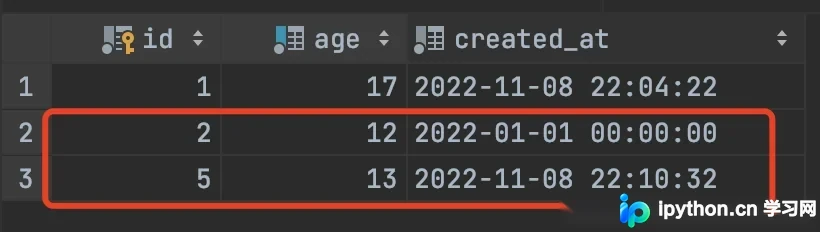
age=12 的记录已存在,因此命中更新逻辑,其 created_at 字段被刷新为指定时间;age=13 无冲突,正常插入。注意,此方法仅影响指定字段,非指定字段保持不变。
第3步:先删后插 —— REPLACE INTO
目的: 彻底替换旧记录,常用于需要根据新数据重构整行信息的场景。
入口与动作: 使用 REPLACE INTO。当检测到主键/唯一键冲突时,MySQL 会执行两步操作:
1. 执行 DELETE 删除原有行;
2. 执行 INSERT 插入新行。
代码示例:
REPLACE INTO student(age) VALUES (12),(13);
可观察结果:
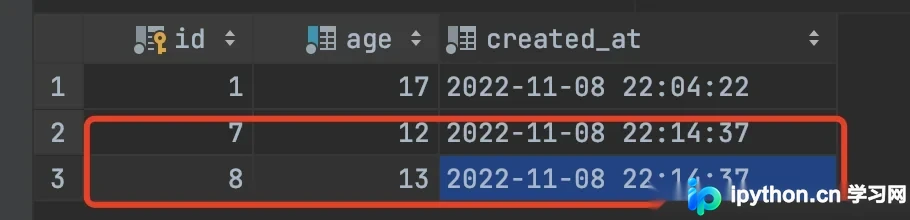
age=12 的记录被物理删除后重新插入,创建时间戳发生显著变化;age=13 正常插入。
关键风险提示与排错
虽然三者都能解决去重问题,但在实际生产环境中,尤其是涉及自增主键和主从同步时,必须警惕以下隐患。
1. 自增主键(AUTO_INCREMENT)的不连续与主从同步风险
当表中存在自增主键且发生冲突时,三种方法均会导致主库的自增 ID 增长但不回退:
- 现象: 即使插入失败或被忽略,被占用的自增 ID 也不会释放。这导致主库自增序列不连续。
- 主从一致性: 这种不连续性通常不会同步到从库的 AUTO_INCREMENT 变量中(取决于具体的 binlog 格式版本)。若在极端容灾切换场景下,从库晋升为主库,可能引发新的主键冲突。
2. Binlog 格式的影响
主从数据的一致性高度依赖于二进制日志(binlog)的模式:
- Statement 格式: 记录的是原始 SQL 语句。若事务中包含复杂逻辑或非确定性函数,可能导致主从行为不一致。
- Row 格式: 记录每一行数据变化前后的具体值。在 ROW 模式下,即便使用 REPLACE 导致的 DELETE+INSERT,从库也会精确模拟这两步操作,数据层面保持一致。
- Mixed 格式: 默认 Statement,仅在必要时切换到 Row。
3. REPLACE INTO 的数据丢失风险
由于 REPLACE INTO 的本质是删除后重建,若表中存在触发器(Trigger)、外键关联或非自增的其他字段未被显式传递,可能会导致:
- 关联数据意外断开。
- 触发器被额外触发两次(Delete 和 Insert),造成业务逻辑混乱。
- 部分列因新插入行未赋值而变为默认值或 NULL,被视为数据丢失。
总结
- INSERT IGNORE: 适用于允许少量数据静默丢弃的场景,性能最好,无副作用。
- INSERT ... ON DUPLICATE KEY UPDATE: 适用于需要合并新旧数据的场景,原子性好,推荐用于计数、统计类字段更新。
- REPLACE INTO: 慎用。除非确信需要全字段覆盖且无需保留历史行关联,否则优先考虑上一种方式,以防数据意外覆写。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















