


MySQL查询变慢的底层原因与优化策略

数据库查询慢往往不是因为硬件不够强,而是执行路径不合理。本文从MySQL查询执行流程出发,解析耗时环节,介绍如何通过减少扫描行数、利用索引覆盖及分析执行计划来诊断和解决性能瓶颈。
理解MySQL查询的执行过程
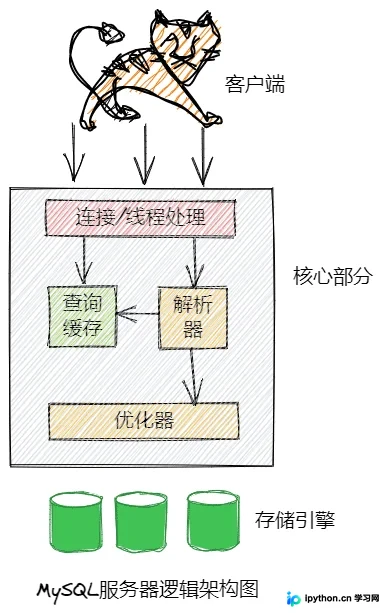
MySQL查询并非单一动作,而是由多个子任务串联而成的流程。要优化查询速度,必须明确哪些环节在消耗时间,目标是消除不必要的子任务或加速现有操作。
一个标准的查询流程包括:客户端请求 → 服务端解析 → 生成执行计划 → 执行查询 → 返回结果。其中,"执行"阶段最为关键,涉及调用存储引擎检索数据、对数据进行排序、分组及聚合等CPU密集型操作。
查询过程中的耗时主要分布在以下几个方面:
- 网络传输:数据在网络中的往返延迟。
- CPU计算:解析SQL、生成统计信息、排序及过滤数据。
- I/O等待:当内存不足导致频繁读写磁盘时,I/O成为最大瓶颈。
- 锁等待与上下文切换:并发高时,线程可能在等待行锁或系统调用中挂起。
优化核心在于:减少不必要的数据读取、降低CPU运算负荷以及避免I/O震荡。
是否提取了不需要的数据
最常见的初级错误是查询了程序根本不使用的字段,甚至在应用层用代码(如Java)进行数据过滤,而非让数据库完成过滤。
最佳实践:永远不要使用SELECT *。
只查询必要的列具有多重好处: 1. 减少内存占用:MySQL服务器和处理结果集所需的内存更少。 2. 提高缓存命中率:更小的数据块更容易被存储在内存缓冲池中。
3. 降低网络开销:传输到客户端的数据量更小,减少了网络带宽消耗。 4. 支持索引覆盖:仅查索引中包含的字段,可实现“覆盖扫描”。衡量查询效率的关键指标
在优化前,需了解如何量化查询的开销。主要有以下几个维度的评估标准:
1、响应时间的构成
响应时间主要由两部分组成:
- 服务时间(Service Time):数据库真正处理该查询所花费的计算与I/O时间。
- 排队时间(Queue Time):查询因资源受限(如等待IO锁、等待行锁)而处于等待状态的时间。
如果排队时间长,说明并发压力大或锁竞争激烈;如果服务时间长,说明SQL逻辑或索引存在问题。
2、扫描行数 vs 返回行数
理想情况下,查询返回的行数应等于扫描的行数。但在实际场景中,尤其是多表关联(Join)时,为了找到匹配的行,服务器必须扫描更多的中间行。
原则:越多的关联表,潜在的性能损耗越大。优化的目标是尽可能缩小扫描范围,使扫描行数逼近返回行数。
3、访问类型(Access Type)
MySQL获取数据的速度从快到慢依次为:
- const:通过主键或唯一索引查到一行,极快。
- eq_ref:唯一索引扫描,用于连接查询。
- ref:非唯一索引扫描,可能返回多行。
- range:索引范围扫描,常见于BETWEEN、>、<条件。
- index:全索引树扫描,比全表扫描稍好。
- ALL:全表扫描,最慢,应极力避免。
通过EXPLAIN定位性能瓶颈
EXPLAIN是MySQL提供的用来观察SQL执行计划的重要工具。重点关注type(访问类型)和Extra列。
理解Extra列的含义
Extra列揭示了MySQL如何处理WHERE条件和获取数据。从优到劣的典型情况如下:
- Using index(覆盖索引):最优状态。MySQL只需通过索引树就能获取所需全部数据,无需回表读行记录。
- Using where(服务器层过滤):MySQL先从数据表读取完整行记录,然后在服务器层应用WHERE条件过滤。这是次优方案,意味着发生了回表操作,增加了I/O成本。
优化Using where的策略
当发现EXPLAIN结果中出现Using where且没有Using index时,可以通过以下方式优化:
- 建立复合索引:将查询条件中的所有列加入索引,尝试实现覆盖扫描,消除回表。
- 改变表结构:对于复杂报表或高频查询,考虑使用汇总表以空间换时间。
- 重写SQL语句:调整JOIN顺序或改写子查询,辅助优化器选择更优的执行路径。
总结
解决MySQL查询慢的问题,本质上是对数据存取路径的精简。遵循“按需取数”的原则,避免SELECT *;在业务允许的情况下,尽量设计能触发“覆盖索引”的查询;利用EXPLAIN定期审查慢查询日志,确保查询尽可能停留在索引层面完成过滤。以上就是为什么MySQL查询速度会慢的详细内容,更多关于MySQL性能优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















