


Java实现AC自动机算法:原理、代码与多模式匹配实战

当需要同时匹配多个关键词(如敏感词过滤)时,KMP或Trie等单模式算法效率受限。AC自动机结合Trie树结构与KMP思想,通过构建fail失配指针实现高效的多模式匹配。本文将详细介绍如何使用Java实现AC自动机的核心组件与匹配流程。
AC自动机原理与优势
AC自动机是一种用于多模式字符串匹配的有限状态自动机,广泛应用于违禁词过滤、搜索引擎关键字高亮等场景。其核心思想是将多个模式串构建成一棵Trie前缀树,并为每个节点计算一个指向“最长真后缀”节点的失效指针(Failure Pointer),从而在匹配失败时快速回溯,避免重复遍历。
第1步:理解核心构成
AC自动机可视为 Trie树 + KMP的Next数组:
- Trie树构建:将所有关键词插入Trie树,利用公共前缀优化存储空间并加速前缀查找。
- 失效指针(Fail)构建:利用BFS层序遍历为每个节点设置fail指针。若当前节点失配,跳转至该节点代表字符串的最长真后缀对应的节点继续匹配。
Java节点与数据结构定义
首先需要定义AC自动机的节点类 AcNode,包含子节点映射、深度标识以及失效指针引用。
class AcNode {
    /**
     * 经过该节点的模式串的下层节点,即Trie树的子节点映射
     */
    Map<Character, AcNode> next = new HashMap<>();

    /**
     * 以当前节点结尾的模式串长度(深度),若非0则代表此处为某个关键词的结束点
     */
    int depth;

    /**
     * 失效指针,指向当前字符串最长真后缀的位置节点
     */
    AcNode failure;

    public boolean hasNext(char nextKey) {
        return next.containsKey(nextKey);
    }

    public AcNode getNext(char nextKey) {
        return next.get(nextKey);
    }
}
构建Trie前缀树
与普通Trie树构建类似,将一组模式串依次插入到根节点下。插入完成后,需在模式串结束的最后一个节点上标记其深度。
/** Trie根节点 */
private AcNode root;

/** 加入模式串,构建Trie */
public void insert(String word) {
    AcNode cur = root;
    for (char c : word.toCharArray()) {
        if (!cur.next.containsKey(c)) {
            cur.next.put(c, new AcNode());
        }
        cur = cur.next.get(c);
    }
    // 标记该路径的长度
    cur.depth = word.length();
}
构建Fail失配指针
这是AC自动机构建的核心步骤。采用广度优先搜索(BFS)逐层遍历,确保父节点的失效指针已确定后,再推导子节点的失效指针。
- 初始化:根节点的直接子节点失效指针指向根节点,加入队列。
- BFS遍历:取出队列中的父节点,遍历其所有子节点。
- 推导逻辑:对于子节点,检查父节点失效指针(pf)是否存在相同字符的子节点。若存在,子节点失效指针指向pf该子节点;否则递归查找pf的失效指针,直到找到或回到根节点。
/**
 * 为所有节点构建失配指针,一个bfs层序遍历
 */
public void buildFailurePointer() {
    ArrayDeque<AcNode> queue = new ArrayDeque<>();
    // 1. 将所有root的直接子节点的failure设置为root,并且加入queue
    for (AcNode acNode : root.next.values()) {
        acNode.failure = root;
        queue.addLast(acNode);
    }

    // 2. BFS构建剩余节点的失配指针
    while (!queue.isEmpty()) {
        AcNode parent = queue.pollFirst();

        for (Map.Entry<Character, AcNode> entry : parent.next.entrySet()) {
            AcNode pf = parent.failure;
            AcNode child = entry.getValue();
            Character nextKey = entry.getKey();

            // 寻找最长真后缀节点
            while (pf != null && !pf.hasNext(nextKey)) {
                pf = pf.failure;
            }

            // 设置子节点的失效指针
            if (pf == null) {
                child.failure = root;
            } else {
                child.failure = pf.getNext(nextKey);
            }
            queue.addLast(child);
        }
    }
}
执行文本匹配
使用构建好的AC自动机遍历目标文本。每当读取到一个字符,判断当前节点是否有对应的边;若无,则沿失效指针回溯直到根节点或找到匹配边。
/**
 * 匹配文本结果封装
 */
class ParseResult {
    int startIndex, endIndex;
    String key;
    public ParseResult(int s, int e, String k) { this.startIndex=s; this.endIndex=e; this.key=k; }
    @Override
    public String toString() {
        return "{startIndex="+startIndex+",endIndex="+endIndex+",key='"+key+'\''+'}';
    }
}

/** 匹配文本 */
public List<ParseResult> parseText(String text) {
    List<ParseResult> results = new ArrayList<>();
    char[] chars = text.toCharArray();
    AcNode cur = root;

    for (int i = 0; i < chars.length; i++) {
        char nextKey = chars[i];
        // 处理不匹配情况,沿失败指针回溯
        while (cur != null && !cur.hasNext(nextKey)) {
            cur = cur.failure;
        }

        if (cur == null) {
            cur = root;
        } else {
            cur = cur.getNext(nextKey);
            // 检查当前节点及其失效链上的所有关键词
            AcNode temp = cur;
            while (temp != null) {
                if (temp.depth != 0) {
                    int start = i - temp.depth + 1;
                    results.add(new ParseResult(start, i,
                        new String(chars, start, temp.depth)));
                }
                temp = temp.failure;
            }
        }
    }
    return results;
}
多模式匹配案例演示
假设关键词集合为:he, shes, shers, hes, h, e。构建出的AC自动机结构如下,其中红色端点表示关键词结束:
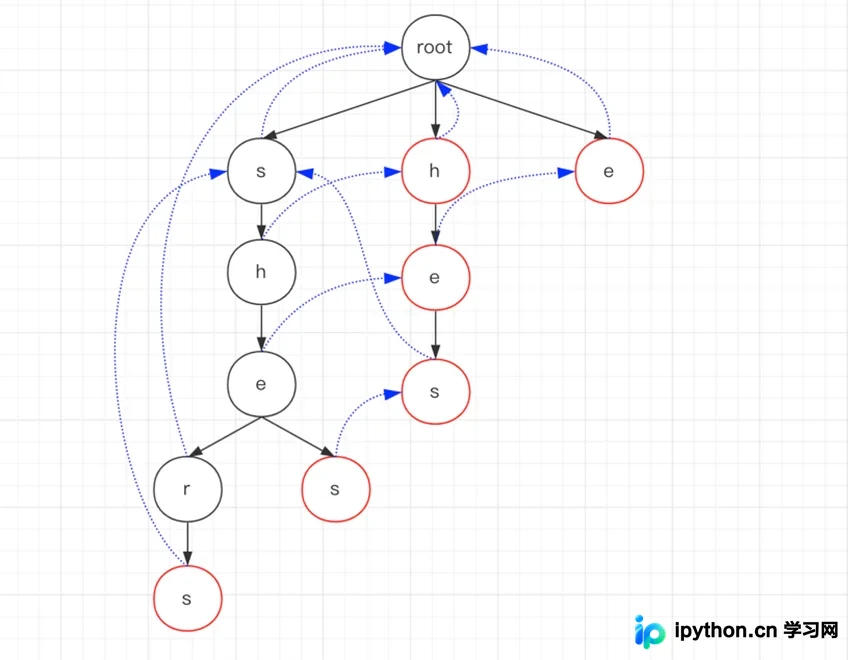
现在对文本 sheshe 进行匹配过程追踪:
- 输入 's':从根到节点's',无关键词命中。
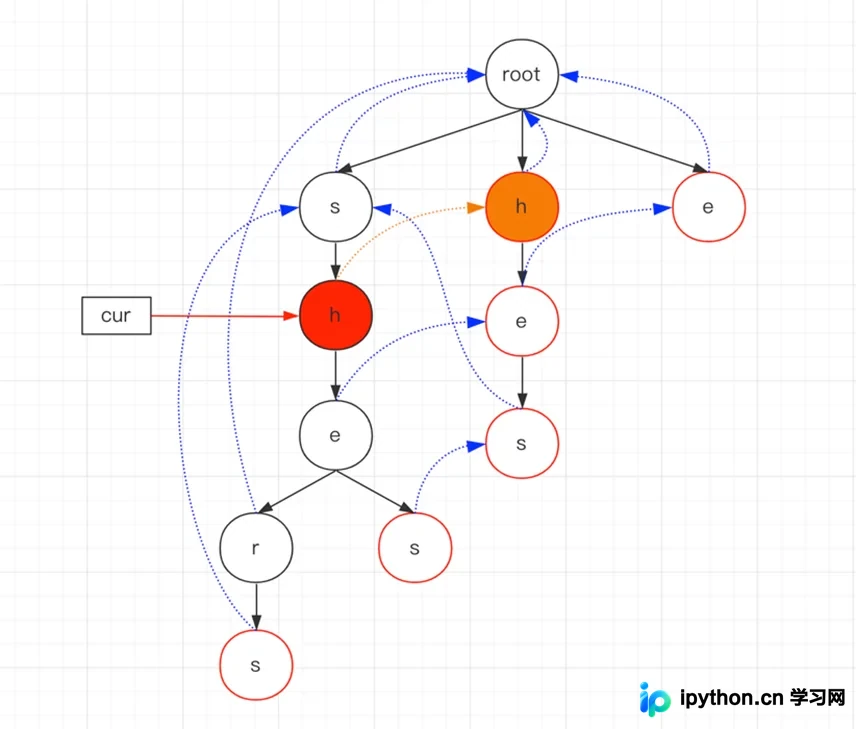
- 输入 'h':匹配到节点'h'。节点本身非结束,但其fail节点包含关键词
h,记录一次匹配。
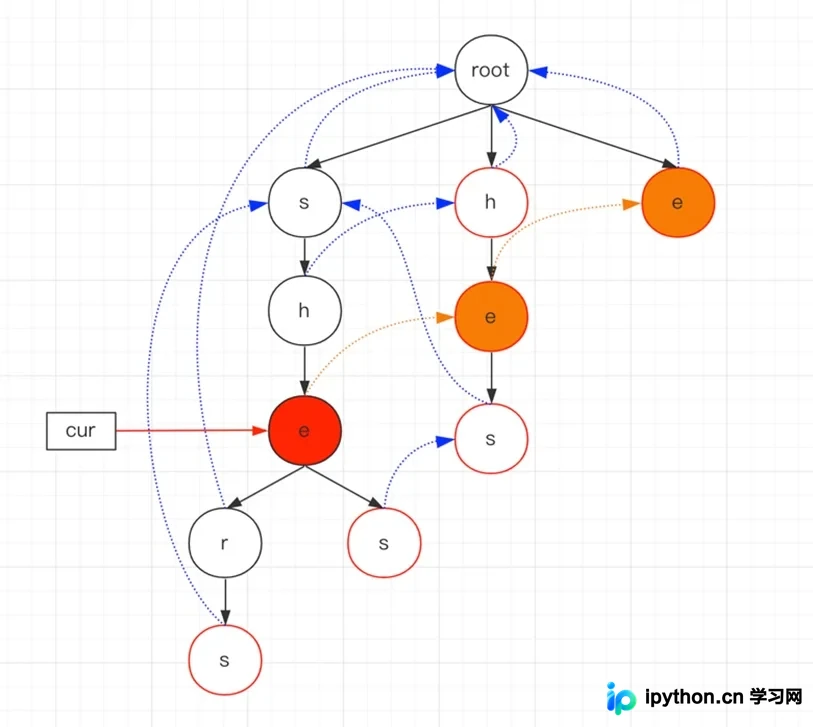
- 输入 'e':匹配到节点'e'。节点'e'的fail节点是'dash h'(表示
he的结束),再次查fail又发现e。因此本轮匹配到he和e。
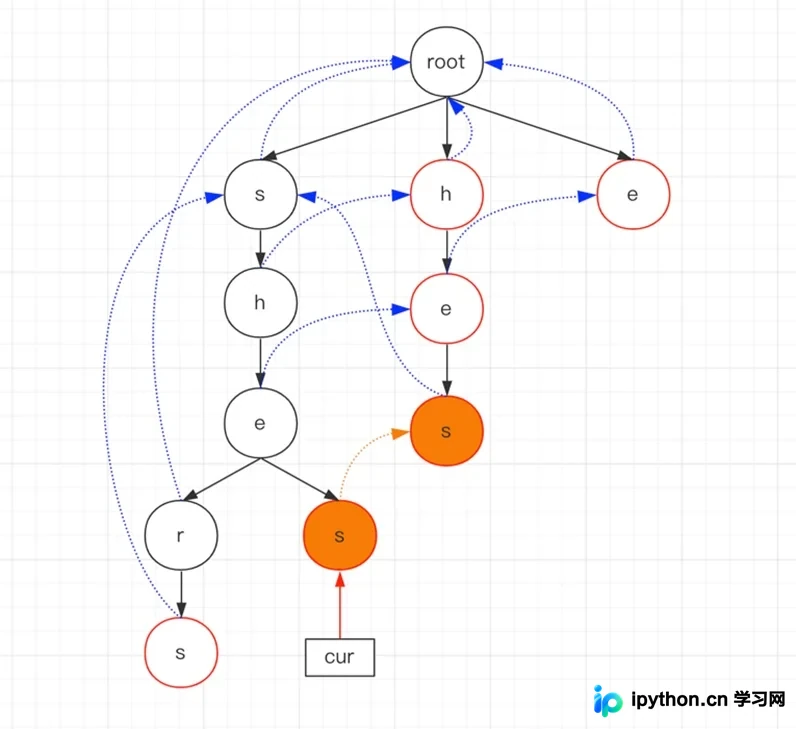
- 输入 's':匹配到节点's'。该节点代表
shes结束,命中;继续查其fail节点,命中hes。
- 输入 'h':当前路径无'h',回溯fail,最终成功跳转到另一分支的节点'h'。该节点非结束,但自身即为关键词
h,命中。
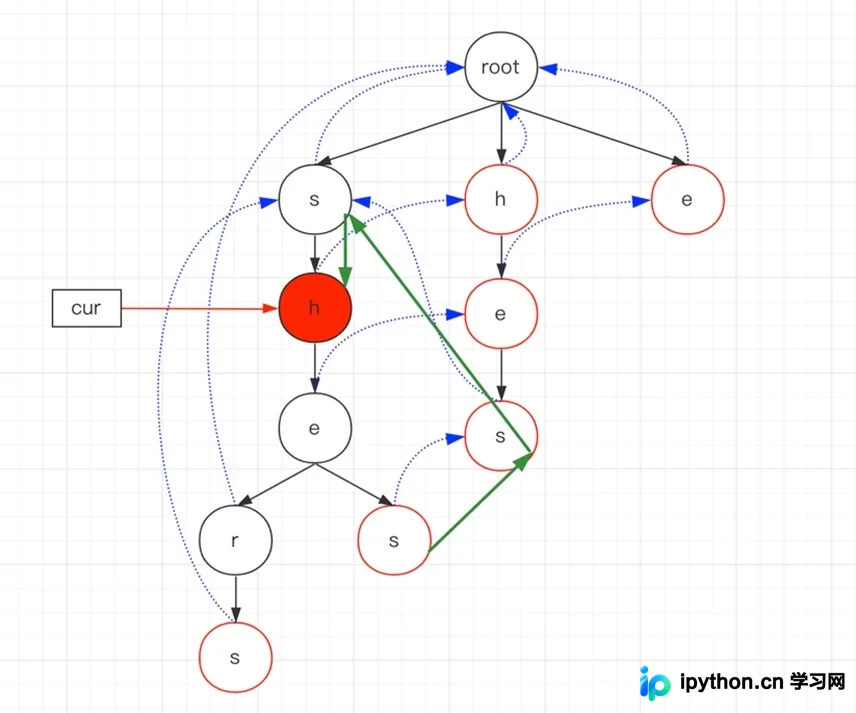
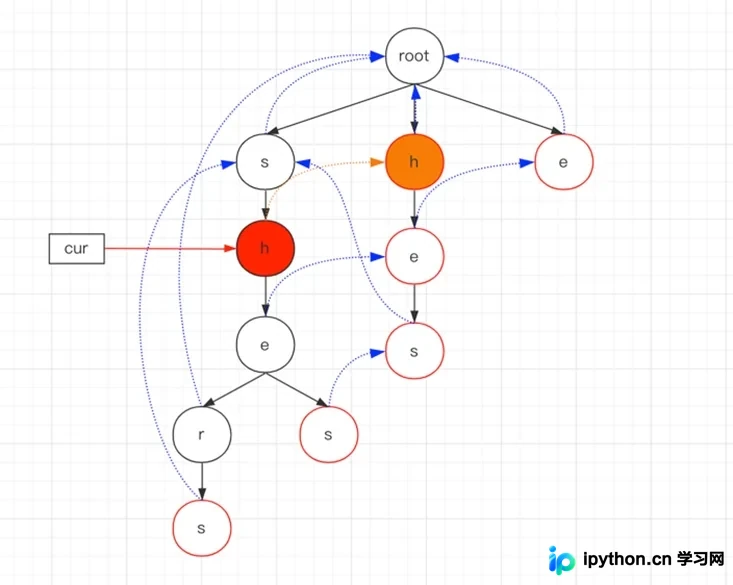
- 输入 'e':同上,匹配到节点'e'。fail链上依次命中
he和e。
最终匹配到的所有子串片段如下:
总结
AC自动机在匹配文本 text(长度为m)时,时间复杂度主要取决于字符扫描次数与向上回溯的次数。虽然最坏情况下会进行多次fail跳转,但实际应用中匹配时间复杂度近似为 O(m),与模式串的数量无关。这使其在处理大量关键词并发匹配的场景下极具优势。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















