


C语言实现读取CSV文件:从结构定义到代码解析

在嵌入式开发或资源受限环境中,C语言处理CSV文件通常没有现成的高层库可用。本文将深入剖析如何利用C语言的指针和结构体机制,手动构建一个轻量级的CSV解析器。该方法不仅展示了如何解析标准逗号分隔格式,还演示了如何将连续内存块动态映射为二维数组,从而实现对数据的灵活索引与转换。
CSV解析的核心挑战与设计思路
C语言原生并不直接支持类似Python pandas这样的高级数据结构。要实现高效的CSV读取,需要解决以下几个关键问题:
- 类型统一:CSV文件中的数据通常是字符串形式,但我们需要将其转换为特定的数值类型(如浮点数、整数等)以便后续计算。
- 内存布局:为了提高缓存命中率并简化释放过程,将读取的数据存储在连续的内存空间中,而非分散的链表节点。
- 动态映射:虽然底层存储是线性的,但上层访问逻辑通常需要行列式的二维结构,这需要一套映射机制来实现。
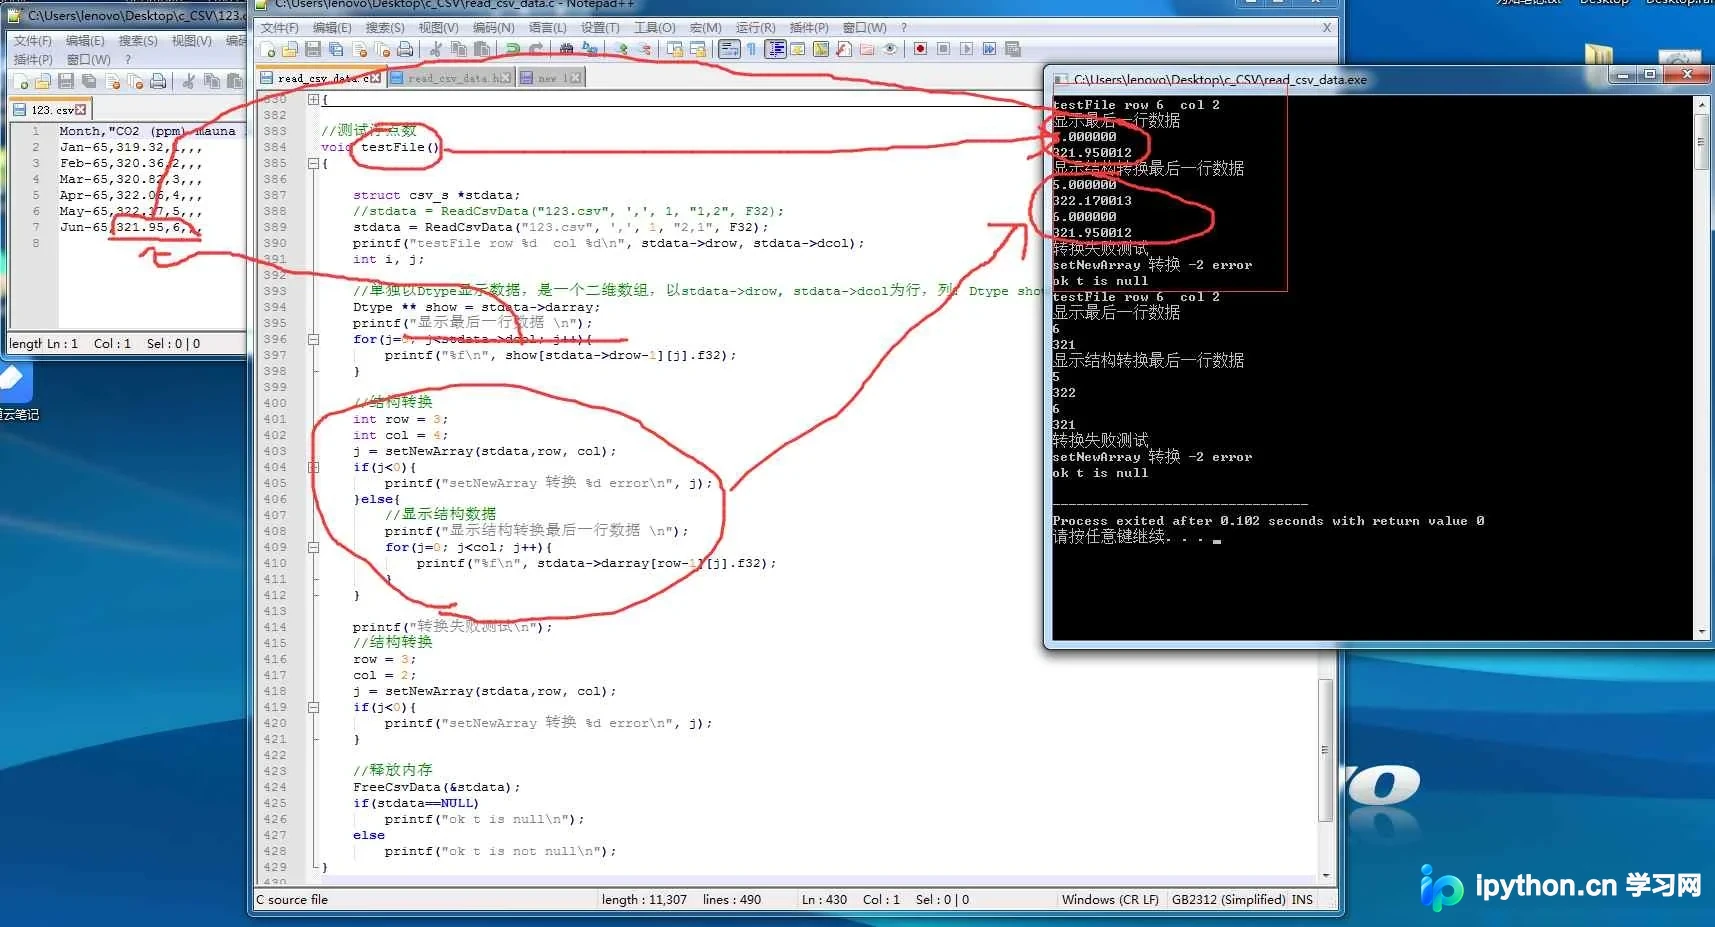
上述逻辑的实现依赖于对文件流的精确控制和指针的算术运算。下面将通过具体的代码模块来拆解这一过程。
核心结构体定义
为了实现统一管理和高效访问,我们需要定义几个关键的结构体和联合体。首先是用于容纳不同数据类型的联合体 Dtype,其次是封装文件元数据和数据指针的 csv_s 结构体。
//可变数据类型联合体,通过共用内存节省空间
typedef union dtype_u{
    long int s32;
    char s8;
    short int s16;
    unsigned char u8;
    unsigned short int u16;
    unsigned long int  u32;
    float f32;
    double f64;
} Dtype;

//CSV文件主结构体
typedef struct csv_s{
    Dtype **darray; // 二维数组指针,指向行的起始位置
    int drow;       // 有效行数
    int dcol;       // 有效列数
    int dnum;       // 总数据元素个数
    Dtype data[];   // 柔性数组,实际数据的连续存储区
} struct csv_s;
这种设计的关键在于 data[] 柔性数组的使用。它在内存中与结构体头部紧邻分配,使得所有解析后的数值都存放在一块连续内存中,而 darray 只是指向这些连续块的“视图”。
第1步:实现字符串分割与基础解析
读取CSV的第一步是将一行文本按照指定的分隔符(如逗号)拆分为多个字段。这里不直接使用全局状态的 strtok,而是实现一个线程安全的自定义分割函数 str_split_func。
int str_split_func(struct str_split *split, char * src, char delimiter)
{
    int count = 0;
    char *pchar, **ptr;

    if ( NULL != split ) {
        memset(split, 0, sizeof(struct str_split));
    }

    if(NULL == split || NULL == src || src[0] == '\0')
    {
        return 0;
    }

    // 首先复制源字符串,因为我们需要修改它来插入结束符
    split->str = strdup(src);
    if(NULL == split->str)
    {
        return 0;
    }

    // 遍历统计分隔符数量以确定子串数量
    count = 1;
    pchar = src;
    while('\0' != *pchar)
    {
        if (delimiter == *pchar)
        {
            count++;
        }
        pchar++;
    }

    // 分配指针数组以存储各子串的起始地址
    split->str_array = (char **)malloc(count*sizeof(char*));
    if(NULL == split->str_array)
    {
        return 0;
    }
    split->count = count;

    // 执行分割:遇到分隔符时替换为'\0',并记录下一个子串地址
    ptr = split->str_array;
    *ptr = split->str;
    pchar = split->str;
    while('\0' != *pchar && count > 1)
    {
        if (delimiter == *pchar)
        {
            ptr++;
            *ptr = pchar+1;
            *pchar = '\0';
            count--;
        }
        pchar++;
    }
    return 0;
}
该函数同时返回了分割出的字符串总数和对应的指针数组,为后续的类型转换做准备。解析完成后,需调用 str_split_free 释放内部申请的内存,防止泄露。
第2步:构建主读取流程
主函数 ReadCsvData 负责整个文件的读取流程。它接受文件路径、分隔符、跳过的行数以及目标列列表作为参数,体现了极高的灵活性。
struct csv_s *ReadCsvData(char* csvFilePath, char delimiter, int skiprows, char *ColumnList, int dclass)
{
    FILE* fCsv=NULL;
    int rowTotal=0;
    int colTotal=0;

    // ... (初始化变量) ...

    if(access(csvFilePath, 0)<0){
        printf("%s 文件不存在\n", csvFilePath);
        goto label_error;
    }

    // 打开文件
    fCsv = fopen( csvFilePath, "r" );
    if( fCsv==NULL )
    {
        printf("open file %s failed",csvFilePath);
        goto label_error;
    }

    // 预扫描文件以确定总行数和列数
    rowTotal = GetTotalLineCount(fCsv);
    colTotal = GetTotalColCount(fCsv, delimiter);

    // ... (处理列选择逻辑 ColumnList) ...

    // 根据有效行数和列数分配内存
    rowTotal = rowTotal - skiprows;
    temp_csv = (struct csv_s *)malloc(sizeof(struct csv_s) + (rowTotal * t_column_list)*sizeof(Dtype));

    if(!temp_csv){
        printf("分配内存失败 \n");
        goto label_error;
    }

    // 跳过指定行数
    i = skiprows;
    fseek(fCsv, 0, SEEK_SET);
    while(i>0 && fgets(strLine,MAX_LINE_SIZE,fCsv) )i--;

    // 逐行读取并转换数据类型
    i = rowTotal;
    while( i>=0 && fgets(strLine,MAX_LINE_SIZE,fCsv)){
        i--;
        str_split_func(&tss, strLine, delimiter);

        // 遍历选定的列进行类型转换
        for(j=0; j<t_column_list; j++){
            // 获取指定列的索引
            int col_idx = t_column_list_ptr[j];
            // 将字符串转换为对应的数值并存入连续内存
            strToData(temp_csv->data+cur_ptr, tss.str_array[col_idx], dclass);
            cur_ptr++;
        }
        str_split_free(&tss);
    }

    // ... (关闭文件及错误处理) ...
}
在此过程中,GetTotalLineCount 和 GetTotalColCount 函数会先对文件进行一次遍历统计,以确保能一次性分配足够且准确的内存空间。这种方式虽然多读了一次文件头,但避免了动态扩容带来的复杂性和性能损耗。
第3步:实现二维数组的动态映射
数据已存入连续内存,现在需要建立二维视图。setNewArray 函数负责这项工作,它能允许用户在不改变物理数据的前提下,重新解释数据的行列关系,前提是总元素数量不变。
int setNewArray( struct csv_s *tt, int row, int col)
{
    int i;
    if(tt == NULL)return -1;
    // 验证新维度是否兼容现有数据总量
    if(row * col != tt->dnum)return -2;

    Dtype **darray=(Dtype **)malloc( sizeof(Dtype *[row]) );
    if(!darray)return -3;

    if(tt->darray)free(tt->darray);
    tt->drow = row;
    tt->dcol = col;
    tt->dnum = row * col;
    tt->darray = darray;

    // 关键步骤:让每一行的指针指向连续内存中的对应偏移量
    for(i=0; i<row; i++){
        tt->darray[i]=(Dtype *)(tt->data+i*col);
    }
    return 0;
}
这使得使用者可以像访问普通二维数组一样访问 tt->darray[i][j],例如 stdata->darray[row-1][j].f32。这种技巧极大地简化了后续算法的逻辑复杂度。
测试用例与应用场景
为了验证功能的稳定性,源码中包含了针对不同类型(浮点型和整型)的测试用例 testFile 和 testFile2。在实际使用中,开发者可以通过调整 ColumnList 参数来提取CSV中的特定感兴趣列,这对于处理含有大量噪声字段的大型数据集非常有用。
需要注意的是,该实现基于行缓冲模式读取,对于超大文件(GB级别),可能需要结合断点续传或分块处理的优化策略。此外,在进行任何内存释放操作前,务必确保所有引用该结构的指针已被妥善处理,以防悬空指针问题。
总结
通过手动实现C语言的CSV读取器,我们不仅掌握了一种在不依赖外部库情况下的数据处理方案,更深刻理解了内存管理、指针算术以及在低级语言中进行抽象设计的艺术。这种方法适用于对性能敏感、内存受限或有严格合规要求的系统环境。
以上就是C语言实现读取CSV文件的详细内容,更多关于C语言读取CSV的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















