


MyBatis注解开发:自定义映射与关联查询详解

在 MyBatis 的注解驱动开发中,常需处理 POJO 属性与数据库列名不一致的场景,以及复杂的单双向关联查询。通过 @Results、@One 和 @Many 等核心注解,开发者可以灵活定义映射关系并控制数据加载方式(如 EAGER/LAZY)。本文将详细讲解如何配置自定义映射规则,并通过 Student 与 Classes 的实例演示一对一及一对多查询的具体实现步骤。
一、使用注解实现自定义映射关系
当实体类中的属性命名规范(如 camelCase)与数据库表字段(如下划线风格或完全重命名)存在差异时,默认的自动映射机制将失效。此时必须通过 @Results 显式定义字段映射,或使用 @ResultMap 引用已定义的映射 ID,以确保数据能正确注入对象属性。
第1步:准备实体类代码
首先创建一个名为 User 的实体类,其属性命名为 username1、sex1 等,以便与常见的 username、sex 区分,验证自定义映射的有效性。
package com.example.pojo;
import java.io.Serializable;

public class User implements Serializable {
    private int id;
    private String username1;
    private String sex1;
    private String address1;

    // 无参构造器
    public User() {}

    // Getter and Setter methods...
    // toString method...
}
第2步:定义 Mapper 接口方法
在 Mapper 接口中,使用 @Select 结合 @Results 来指定列名与属性的对应关系。对于重复使用的映射规则,可以在 @Results(id="...") 中分配唯一 ID,后续查询直接通过 @ResultMap("id") 引用,避免代码冗余。
// 查询所有用户
@Results(id = "userDiyMapper", value = {
    @Result(id = true, property = "id", column = "id"),
    @Result(property = "username1", column = "username"),
    @Result(property = "sex1", column = "sex"),
    @Result(property = "address1", column = "address")
})
@Select("select * from user")
List<User> findAll1();

// 根据ID查询,复用上方定义的映射
@ResultMap("userDiyMapper")
@Select("select * from user where id = #{id}")
User findById(int id);
第3步:执行测试并观察结果
运行单元测试,确保系统能够正确识别不同命名的字段。检查日志输出或断点调试,确认 User 对象的属性已被赋予对应的数据库值。
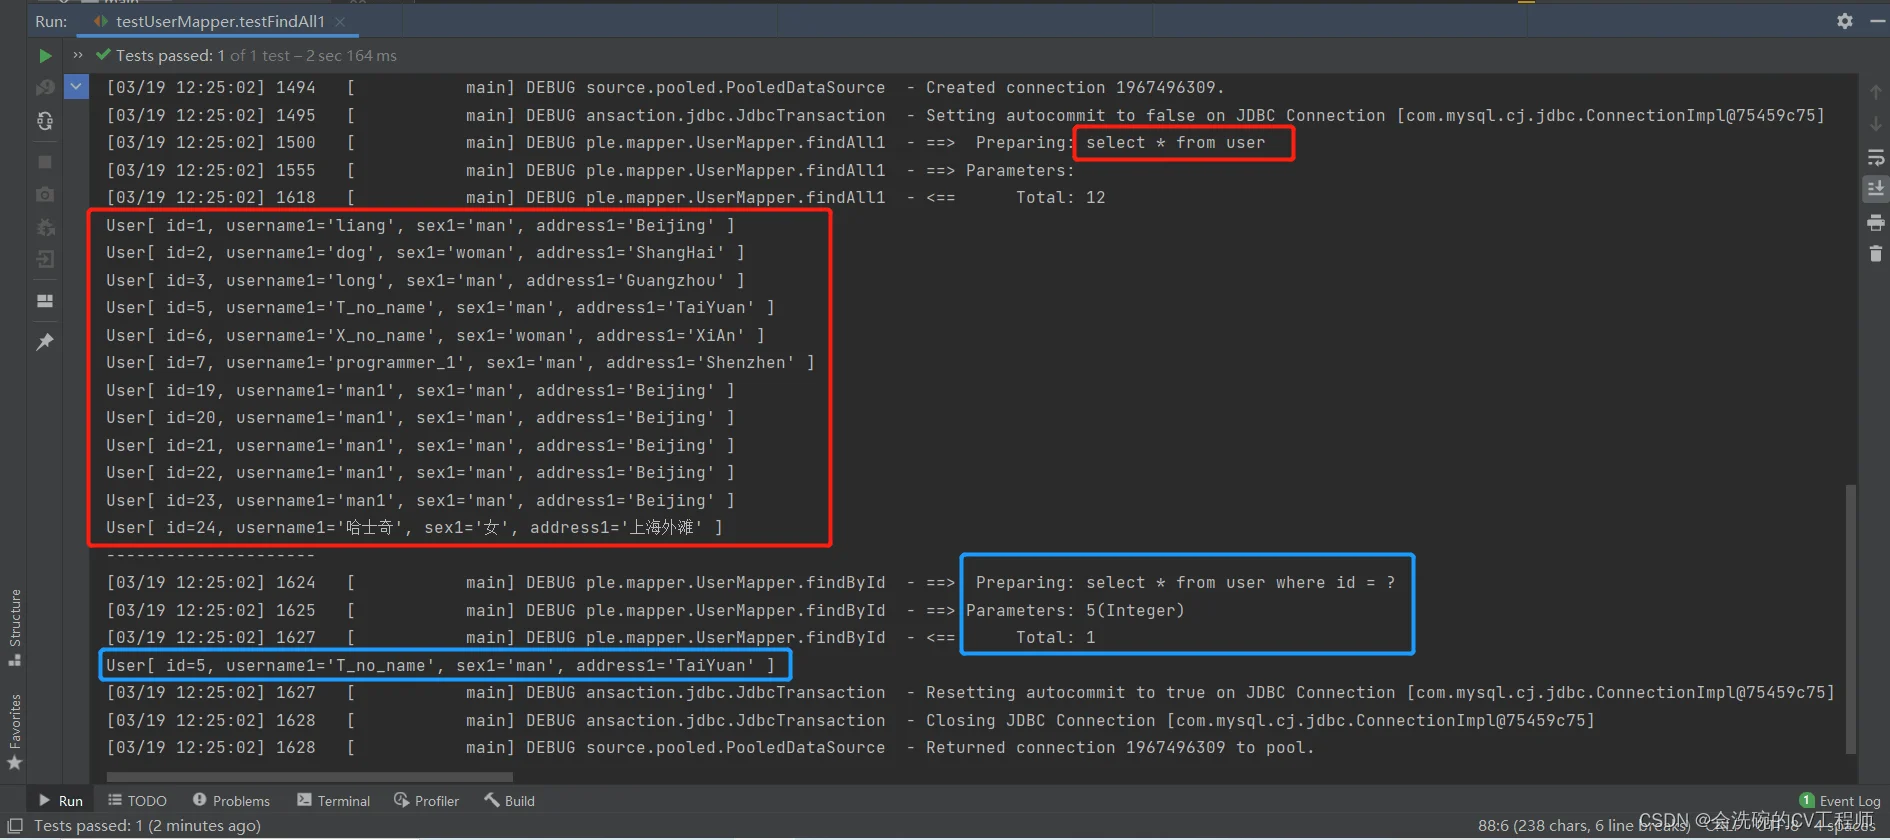
从输出结果可见,尽管使用了不同的变量名,MyBatis 仍按预期完成了映射,证明自定义映射配置生效。
二、使用注解实现一对一关联查询
MyBatis 注解开发通常不支持直接的 SQL JOIN,而是采用分解查询(Sub-select)的方式。例如,在学生表中存储班级 ID,通过该 ID 去查询班级详情,从而实现学生到班级的“一对一”关联。
第1步:构建关联实体
创建 Classes(班级)和 Student(学生)实体类。Student 中包含一个 Classes 类型的属性,用于持有班级对象。
public class Student {
    private int sid;
    private String name;
    private int age;
    private String sex;
    private Classes classes; // 关联的对象属性
    // getters/setters...
}

public class Classes {
    private int cid;
    private String className;
    // getters/setters...
}
第2步:编写主表查询逻辑
在 StudentMapper 中,使用 @Result(one = @One(...)) 指定子查询逻辑。其中:property:Student 中需要填充关联对象的属性名。column:传递给学生子查询的参数列名。one.select:引用的子查询方法全限定名。fetchType:决定是立即加载(EAGER)还是延迟加载(LAZY)。
public interface StudentMapper {
    @Select("select * from student")
    @Results(id = "studentMapper", value = {
        @Result(id = true, property = "sid", column = "sid"),
        @Result(property = "name", column = "name"),
        @Result(property = "age", column = "age"),
        @Result(property = "sex", column = "sex"),
        @Result(property = "classes", column = "classId",
            one = @One(
                select = "com.example.mapper.ClassesMapper.findByCid",
                fetchType = FetchType.EAGER
            )
        )
    })
    List<Student> findAll();
}
第3步:编写子表查询逻辑
在 ClassesMapper 中定义被调用的查询方法:
public interface ClassesMapper {
    @Select("select * from classes where cid = #{cid}")
    Classes findByCid(Integer cid);
}
第4步:测试验证
调用 findAll() 获取学生列表。控制台输出应显示每个 Student 对象内部的 classes 属性已被正确填充。
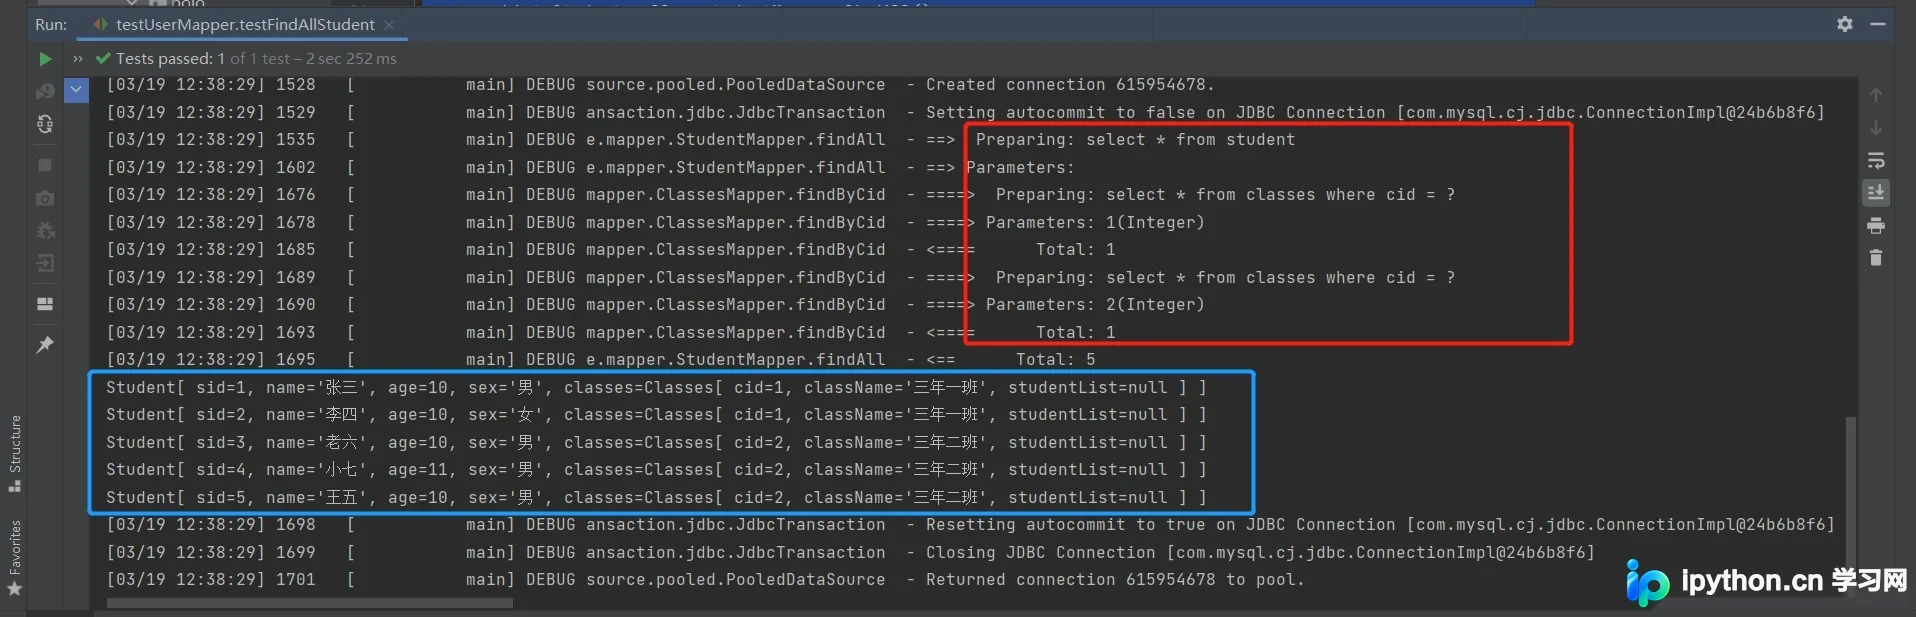
测试结果证实,学生对象成功携带了所属班级的详细信息。
三、使用注解实现一对多关联查询
与一对一相反,这里的目标是查询班级时,同时列出该班级下的所有学生。这需要使用 @Many 注解来处理集合类型属性。
第1步:定义反向查询条件
首先在 StudentMapper 中添加一个通过班级 ID 查找学生的辅助方法:
@Select("select * from student where ClassId = #{classId}")
List<Student> findByClassId(int classId);
第2步:在 ClassesMapper 中配置集合映射
使用 @Result(many = @Many(...)) 绑定集合属性。此处推荐使用 FetchType.LAZY(延迟加载),仅在实际访问 studentList 时才发起额外 SQL 请求,优化性能。
public interface ClassesMapper {
    @Select("select * from classes")
    @Results(id = "classMapper", value = {
        @Result(id = true, property = "cid", column = "cid"),
        @Result(property = "className", column = "className"),
        @Result(property = "studentList", column = "cid",
            many = @Many(
                select = "com.example.mapper.StudentMapper.findByClassId",
                fetchType = FetchType.LAZY
            )
        )
    })
    List<Classes> findAll();
}
第3步:运行与观察
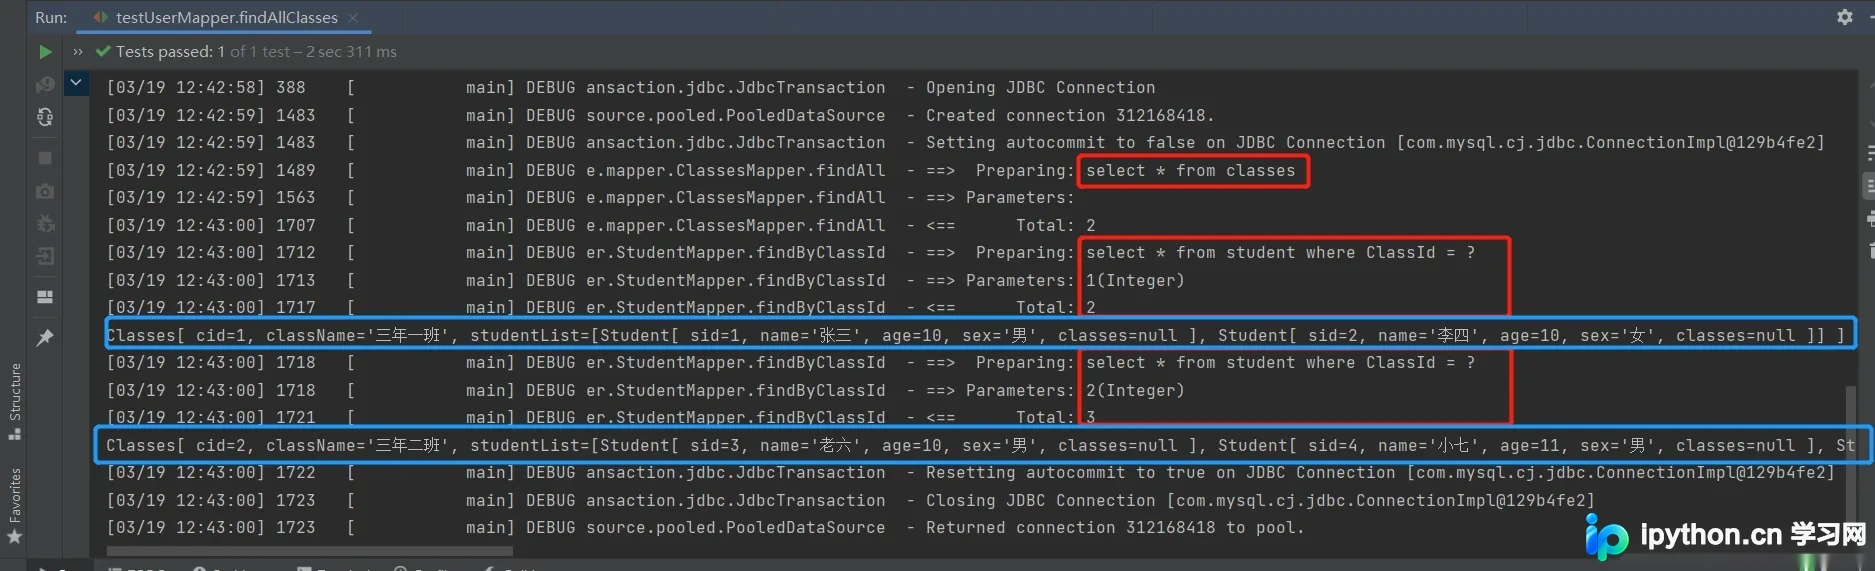
遍历查询到的班级列表,打印时会触发学生子查询。最终输出展示班级及其包含的所有学生信息。
四、注解与 XML 映射文件开发对比
在实际项目中,选择合适的开发模式至关重要。虽然注解方式语法简洁,但 XML 映射文件在处理复杂 SQL 和维护大型项目时更具优势。
- 注解开发:优势在于开发效率高,配置简单且具备编译期类型安全;劣势在于复杂 SQL 可读性差,且不支持连接查询(只能分解查询)。
- XML 映射:优势在于 SQL 集中管理,支持解耦和级联连接查询;劣势是需要额外的配置文件维护成本。
建议初学者或简单 CRUD 场景优先考虑注解,而在构建大规模应用或涉及复杂报表统计时,迁移至 XML 配置更为稳妥。
以上就是 MyBatis 注解实现自定义映射和关联查询的详细内容,更多关于 MyBatis 高级映射技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















