


Java使用POI将PPT转换为PDF时解决中文乱码问题

在使用Java开发PPT自动导出功能时,通过Apache POI转换PPT至PDF常遭遇中文字符显示异常(方块乱码)。该现象尤其在PPTX文件中因混合字体设置更为明显。本文将详细阐述如何利用代码遍历幻灯片元素并统一字体属性,从而在生成PDF预览图时还原正确文字。
转换原理与乱码成因
将PPT转换为PDF通常采用“矢量绘图渲染”策略:首先利用POI库读取幻灯片内容并将其绘制为图像(如PNG或JPG),随后借助iText等库将这些图像嵌入到PDF文档中。这一过程的核心在于图形渲染引擎能否正确解析原始PPT中的字形信息。
对于旧式的.ppt格式,由于字体索引相对固定,解决方案较为单一,即全局替换字体即可生效。然而,针对基于XML结构的.pptx格式,POI在处理包含多种中文字体(例如微软雅黑与宋体混排)的幻灯片时,若未逐字指定字体家族,极易出现部分文本无法匹配对应字形的情况,进而呈现为方框。
操作准备与环境配置
要实现稳定且无乱码的转换流程,需引入特定的Java库以分别处理Office文件格式和PDF构建。以下是必要的Maven依赖配置:
<dependency>
    <groupId>org.apache.poi</groupId>
    <artifactId>poi</artifactId>
    <version>3.9</version>
</dependency>
<dependency>
    <groupId>org.apache.poi</groupId>
    <artifactId>poi-ooxml</artifactId>
    <version>3.9</version>
</dependency>
<dependency>
    <groupId>org.apache.poi</groupId>
    <artifactId>poi-scratchpad</artifactId>
    <version>3.9</version>
</dependency>
<dependency>
    <groupId>com.itextpdf</groupId>
    <artifactId>iText</artifactId>
    <version>5.5.7</version>
</dependency>
注意: 确保运行环境(服务器或客户端)已安装所需的字体(如“宋体”),否则即便代码逻辑正确,渲染出的图像仍可能缺失字形。
修复步骤与代码实现
第一步:统一.pptx幻灯片字体设置
这是解决乱码的关键环节。在将PPT页转化为BufferedImage之前,需遍历所有形状,提取出文本块,并将其字体强制设定为系统中存在的统一字体(建议设为宋体或SimSun)。
// 假设 currentSlide 是当前正在处理的 XSLFSlide 对象
for( XSLFShape shape : currentSlide.getShapes() ){
    if ( shape instanceof XSLFTextShape ){
        XSLFTextShape txtshape = (XSLFTextShape)shape ;
        // 遍历文本段落
        for ( XSLFTextParagraph textPara : txtshape.getTextParagraphs() ){
            List<XSLFTextRun> textRunList = textPara.getTextRuns();
            // 遍历每一行文本运行段
            for(XSLFTextRun textRun: textRunList) {
                // 关键修改:强制指定字体族
                textRun.setFontFamily("宋体");
            }
        }
    }
}
第二步:执行转换全流程逻辑
以下完整方法演示了如何根据文件后缀区分处理逻辑,并在内部完成字体修正、图像缩放及最终的PDF组装。
public static void convertPPTToPDF(String sourcepath, String destinationPath, String fileType) throws Exception {
    FileInputStream inputStream = new FileInputStream(sourcepath);
    double zoom = 2; // 放大倍数,提高清晰度
    AffineTransform at = new AffineTransform();
    at.setToScale(zoom, zoom);

    Document pdfDocument = new Document();
    PdfWriter pdfWriter = PdfWriter.getInstance(pdfDocument, new FileOutputStream(destinationPath));
    PdfPTable table = new PdfPTable(1);
    pdfWriter.open();
    pdfDocument.open();

    Dimension pgsize = null;
    Image slideImage = null;
    BufferedImage img = null;

    if (fileType.equalsIgnoreCase(".ppt")) {
        // --- 处理旧版 .ppt 格式 ---
        SlideShow ppt = new SlideShow(inputStream);
        inputStream.close();
        pgsize = ppt.getPageSize();
        Slide slide[] = ppt.getSlides();
        pdfDocument.setPageSize(new Rectangle((float) pgsize.getWidth(), (float) pgsize.getHeight()));

        for (int i = 0; i < slide.length; i++) {
            TextRun[] truns = slide[i].getTextRuns();
            for ( int k=0;k<truns.length;k++){
                RichTextRun[] rtruns = truns[k].getRichTextRuns();
                for(int l=0;l<rtruns.length;l++){
                    rtruns[l].setFontIndex(1);
                    rtruns[l].setFontName("宋体");
                }
            }

            img = new BufferedImage((int) Math.ceil(pgsize.width * zoom), (int) Math.ceil(pgsize.height * zoom), BufferedImage.TYPE_INT_RGB);
            Graphics2D graphics = img.createGraphics();
            graphics.setTransform(at);
            graphics.setPaint(Color.white);
            graphics.fill(new Rectangle2D.Float(0, 0, pgsize.width, pgsize.height));
            slide[i].draw(graphics);
            slideImage = Image.getInstance(img, null);
            table.addCell(new PdfPCell(slideImage, true));
        }
    } else if (fileType.equalsIgnoreCase(".pptx")) {
        // --- 处理新版 .pptx 格式 ---
        XMLSlideShow ppt = new XMLSlideShow(inputStream);
        pgsize = ppt.getPageSize();
        XSLFSlide slide[] = ppt.getSlides();
        pdfDocument.setPageSize(new Rectangle((float) pgsize.getWidth(), (float) pgsize.getHeight()));

        for (int i = 0; i < slide.length; i++) {
            // 【核心修复】字体统一化循环
            for( XSLFShape shape : slide[i].getShapes() ){
                if ( shape instanceof XSLFTextShape ){
                    XSLFTextShape txtshape = (XSLFTextShape)shape ;
                    for ( XSLFTextParagraph textPara : txtshape.getTextParagraphs() ){
                        List<XSLFTextRun> textRunList = textPara.getTextRuns();
                        for(XSLFTextRun textRun: textRunList) {
                            textRun.setFontFamily("宋体");
                        }
                    }
                }
            }

            // 渲染图像
            img = new BufferedImage((int) Math.ceil(pgsize.width * zoom), (int) Math.ceil(pgsize.height * zoom), BufferedImage.TYPE_INT_RGB);
            Graphics2D graphics = img.createGraphics();
            graphics.setTransform(at);
            graphics.setPaint(Color.white);
            graphics.fill(new Rectangle2D.Float(0, 0, pgsize.width, pgsize.height));
            slide[i].draw(graphics);
            slideImage = Image.getInstance(img, null);
            table.addCell(new PdfPCell(slideImage, true));
        }
    }

    pdfDocument.add(table);
    pdfDocument.close();
    pdfWriter.close();
    System.out.println("Powerpoint file converted to PDF successfully");
}
结果验证与观察
经过上述字体遍历处理后,PPTX文件中的中文乱码现象应被消除。可以通过对比转换前后的页面快照直观确认效果:
转换前的中文乱码状态:
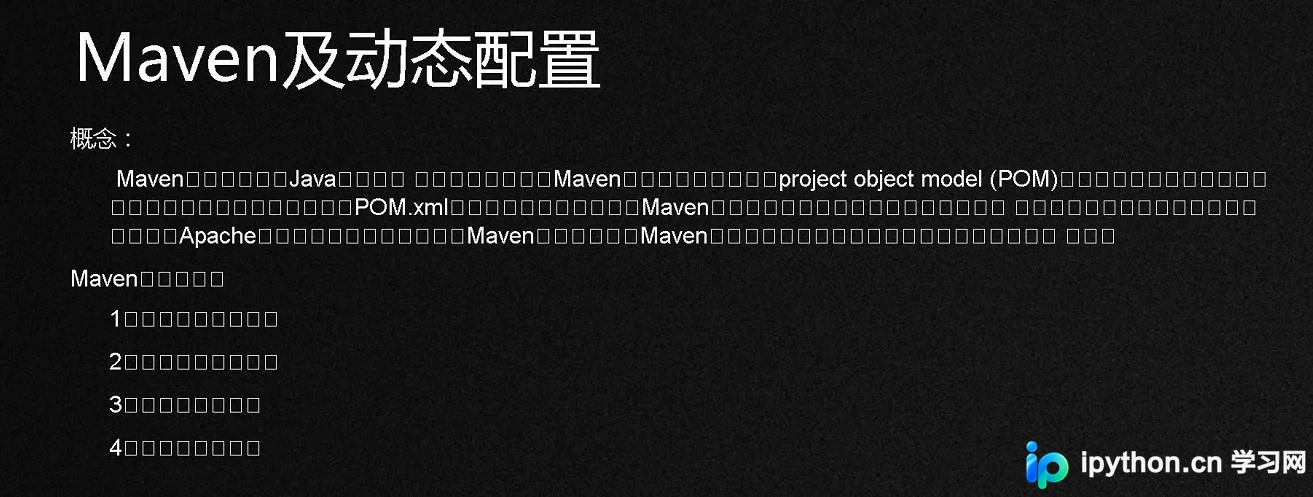
应用上述代码修复后的正常状态:
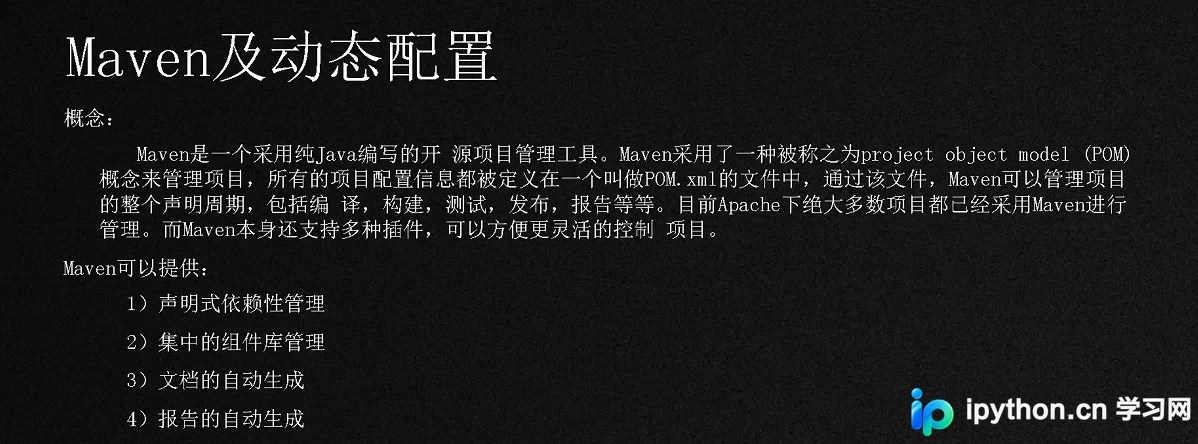
从图中可以看出,经过强制指定字体后,原本显示异常的方块已恢复为正常的中文字符,同时英文排版保持整齐,证明该方案在多语言混排的复杂场景下依然有效。
简要总结
Java环境下PPT转PDF乱码的根本原因在于底层渲染引擎未能精准映射混合字体配置。通过显式调用API重置字体家族(FontFamily),我们规避了POI潜在的默认处理缺陷。以上就是Java实现PPT转PDF出现中文乱码问题的解决方法的详细内容,更多关于Java办公自动化处理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















