


Python使用json.dumps输出中文乱码的解决方法

在使用 Python 将数据结构序列化为 JSON 字符串时,json.dumps() 默认遵循安全转义规则,会将中文转换为 \uXXXX 形式的 ASCII 编码,导致控制台输出晦涩且文件读取乱码。通过在调用时添加 ensure_ascii=False 参数,并配合文件写入时的 encoding='utf-8' 设置,即可直接获取并保持可读的中文字符串。
理解 json.dumps 的默认编码行为
Python 标准库中的 json 模块在处理非 ASCII 字符时,默认遵循 JSON 规范的安全转义规则。这意味着所有中文、特殊符号或其他扩展字符都会被转换为 \uXXXX 形式的 ASCII 兼容字符串。
>>> import json
>>> print(json.dumps('中国'))
"\u4e2d\u56fd"
这种纯 ASCII 输出虽然符合基础规范,但在日常开发与日志记录中会严重降低可读性。当此类数据直接写入文件且未正确处理底层编码时,便会呈现为无法识别的乱码字符。
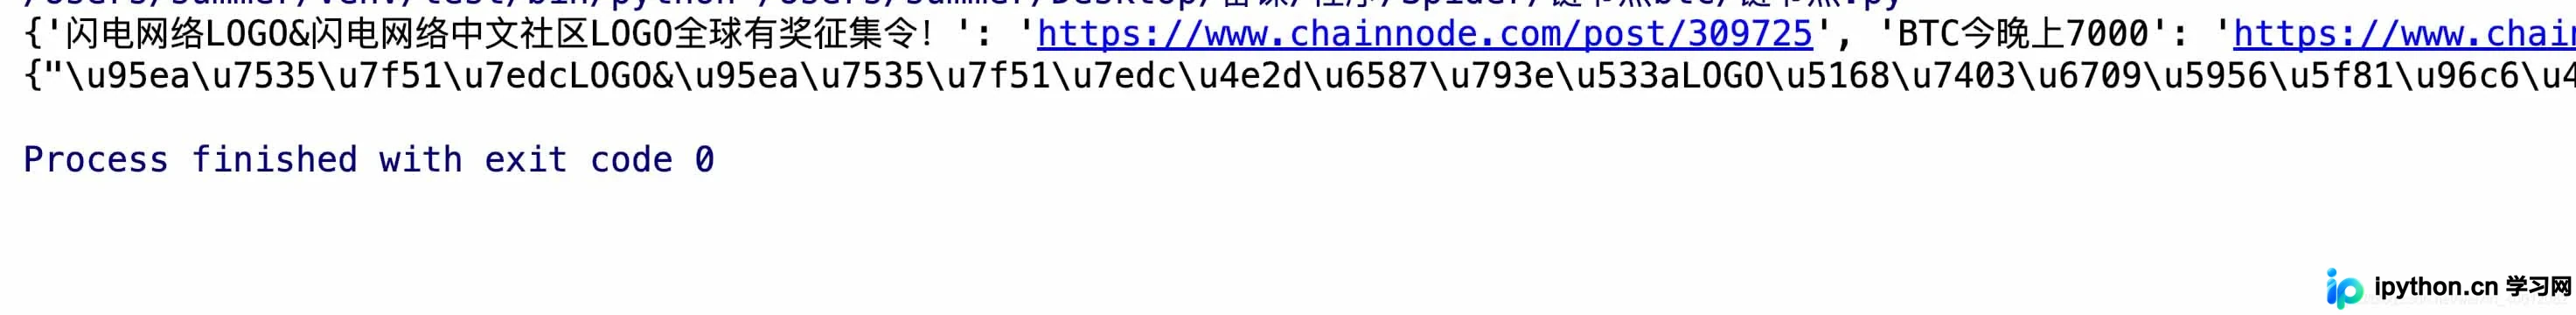
通过 ensure_ascii 参数直接输出中文
解决该问题的核心方法是在 json.dumps() 函数调用中明确指定 ensure_ascii=False。该参数会指示序列化器跳过默认的 ASCII 转义流程,直接以原始字符形式保留文本内容。
>>> print(json.dumps('中国', ensure_ascii=False))
"中国"
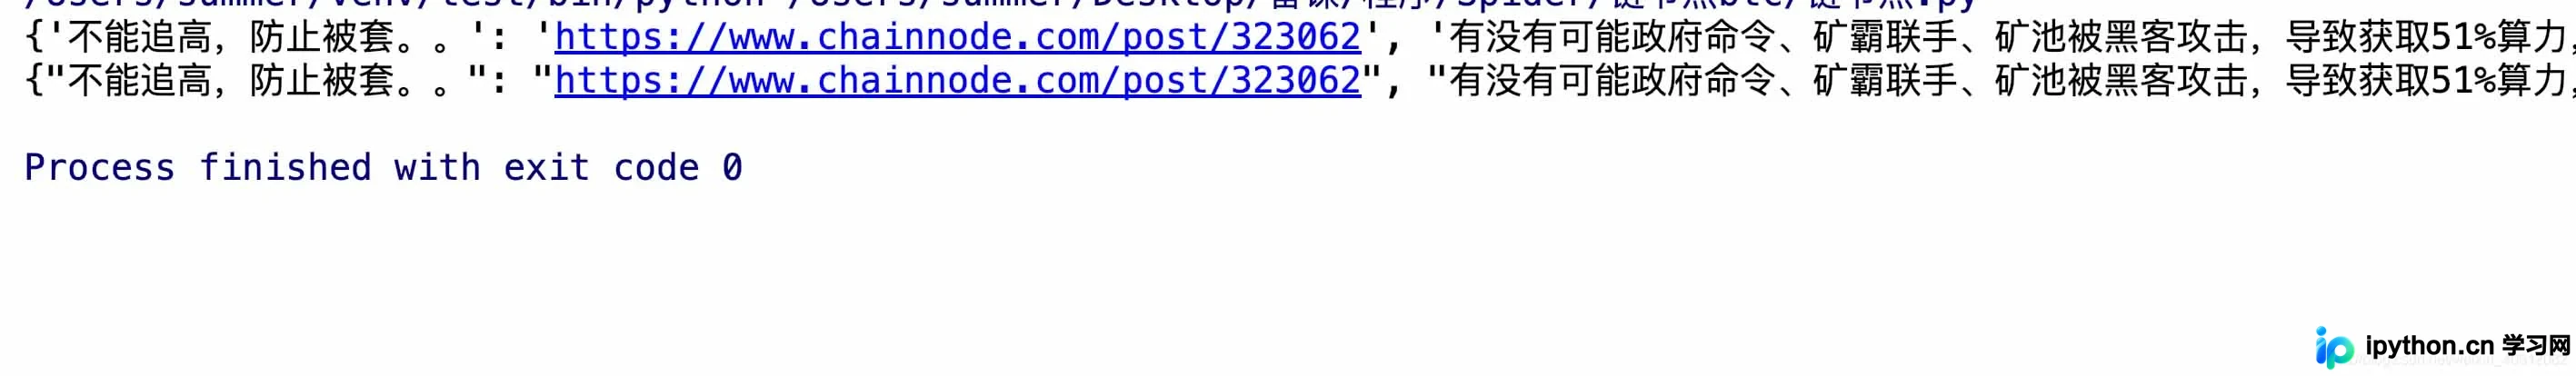
开启此参数后,返回的字符串将包含完整的 UTF-8 编码中文,彻底消除 \uXXXX 转义符。需要注意的是,该方法仅控制 Python 内存中的序列化输出格式,实际落盘到磁盘文件时仍需配合正确的打开模式。
文件写入场景下的完整操作
在实际开发中,通常需要先将数据结构转换为 JSON 字符串,再保存至本地文件。以下为标准的类方法实现逻辑,包含数据打印、序列化转换与安全写入三个步骤:
import json

def save_data(self, data):
    print("原始数据:", data)
    # 必须传入 ensure_ascii=False 以保证中文可读
    json_str = json.dumps(data, ensure_ascii=False)
    print("序列化结果:", json_str)

    # 写入文件时必须指定 encoding='utf-8'
    with open('output.json', mode='w', encoding='utf-8') as f:
        f.write(json_str)
执行该段代码后,控制台输出的字符串及生成的 output.json 文件均可直接查看清晰的中文内容,不再出现编码断裂或乱码现象。
关键注意事项
- 参数位置:
ensure_ascii是json.dumps的关键关键字参数,务必紧跟待序列化对象之后声明。 - 文件编码一致性: Python 3 默认系统编码通常为 UTF-8,但在跨平台或特定服务器环境中,显式声明
encoding='utf-8'是防止底层字节流解析错误的必要措施。 - 网络传输兼容性: 部分老旧的系统或严格遵循 RFC 标准的第三方接口可能要求严格的 ASCII 安全字符串。若对接外部 API,请提前确认对方对非 ASCII 字符的解码策略,必要时可临时切换回默认值。
以上就是 Python json.dumps 输出中文乱码的详细解决方法,更多关于 Python 数据处理与序列化优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















