


使用Golang实现多线程大文件下载器:原理与代码实战

本文详细介绍如何使用Go语言编写一个支持断点续传的多线程下载器。通过HTTP协议的Range请求头将大文件切分为多个片段并发下载,利用Goroutine提高传输效率,并在本地合并后进行完整性校验。
多线程下载的核心原理
多线程下载的本质是将一个大的目标文件分割为若干个小片段(Part),客户端向服务器发起多个并行的GET请求,每个请求通过指定起始和结束字节范围来获取对应片段,最后在本地按序拼接成完整文件。
HTTP Range / Content-Range 协议支持
Golang 实现此功能的基础在于 HTTP/1.1 协议对范围请求的支持:
- Range (请求头):用于告知服务器需要文件的哪一部分。格式通常为
bytes=start-end。 - Content-Range (响应头):服务器返回被请求的具体字节范围以及文件的总大小。例如
bytes 0-99/1000。
判断服务器是否支持断点续传或多线程下载的指标是响应头中是否存在 Accept-Ranges: bytes。如果支持,服务器通常会在处理范围请求时返回状态码 206 Partial Content。
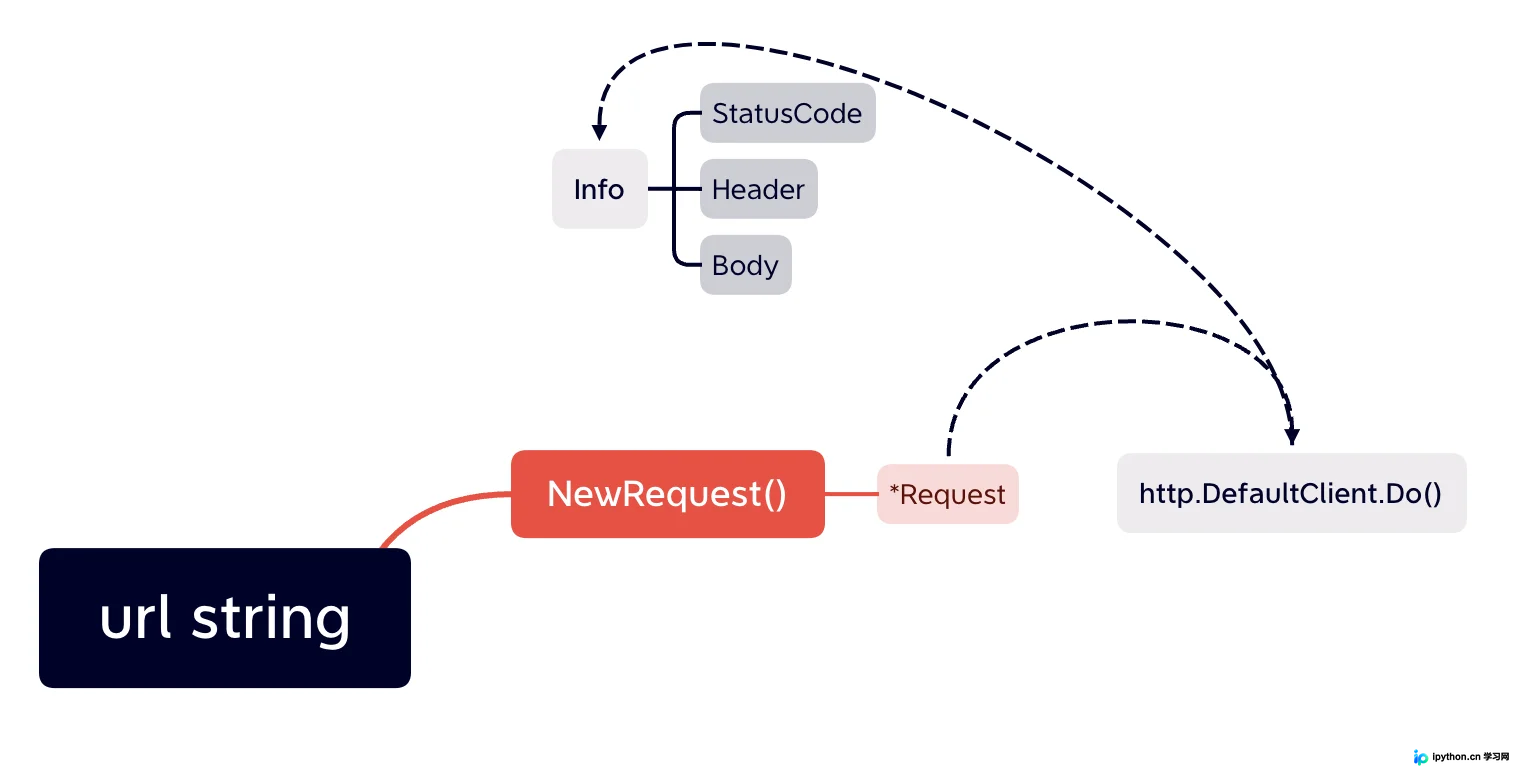
以下是检测目标 URL 是否支持范围请求的流程示意:
准备条件与结构体定义
在开始编码前,我们需要定义两个核心结构体来管理下载任务的状态和进度。
1. 初始化下载器 (FileDownloader)
FileDownloader 结构体负责存储目标 URL、文件大小、输出路径、分片数量以及下载进度信息。
type FileDownloader struct {
	fileSize       int           // 待下载文件总大小
	url            string        // 目标源链接
	outputFileName string        // 下载保存的文件名
	totalPart      int           // 文件切片总数
	outputDir      string        // 文件存储目录
	doneFilePart   []filePart    // 已完成下载的分片集合
	md5            string        // 用于校验的 MD5 值
}
2. 定义文件分片 (filePart)
filePart 代表一个具体的下载任务单元,包含该分片的序号、数据在源文件中的起始位置(From)、结束位置(To)以及实际接收到的数据(Data)。
type filePart struct {
	Index int      // 分片序号
	From  int      // 起始字节位置
	To    int      // 结束字节位置
	Data  []byte   // 下载得到的二进制数据
}
真实操作顺序
第 1 步:获取文件元数据
在下载内容之前,必须先发送一次 HTTP HEAD 或 GET 请求以获取文件总大小并验证服务器是否支持断点续传。同时,尝试从 Content-Disposition 头中提取文件名。
func (d *FileDownloader) getHeaderInfo() (int, error) {
	headers := map[string]string{
		"User-Agent": "Mozilla/5.0",
	}
	// 发送请求获取文件头信息
	req, err := http.NewRequest("HEAD", d.url, nil)
	if err != nil {
		return 0, err
	}
	for k, v := range headers {
		req.Header.Set(k, v)
	}

	resp, err := http.DefaultClient.Do(req)
	if err != nil {
		return 0, err
	}
	defer resp.Body.Close()

	// 检查响应状态
	if resp.StatusCode > 299 || resp.StatusCode < 200 {
		return 0, errors.New(fmt.Sprintf("Response error: %v", resp.Status))
	}

	// 验证是否支持断点续传
	if resp.Header.Get("Accept-Ranges") != "bytes" {
		return 0, errors.New("Server does not support Range requests")
	}

	// 提取文件名
	if d.outputFileName == "" {
		d.outputFileName = extractFileName(resp)
	}

	// 获取文件总长度
	contentLength := resp.Header.Get("Content-Length")
	size, _ := strconv.Atoi(contentLength)
	d.fileSize = size
	return size, nil
}

// 辅助函数:解析文件名
func extractFileName(resp *http.Response) string {
	contentDisp := resp.Header.Get("Content-Disposition")
	if contentDisp != "" {
		_, params, err := mime.ParseMediaType(contentDisp)
		if err == nil {
			return params["filename"]
		}
	}
	//  fallback: 取 URL path 最后一部分
	return filepath.Base(resp.Request.URL.Path)
}
第 2 步:计算分片逻辑
根据文件总大小和预定的并发数(切片数),计算出每个分片的起始字节和结束字节。注意处理最后一个分片的大小可能与其他不同。
jobs := make([]filePart, d.totalPart)
eachSize := d.fileSize / d.totalPart

for i := range jobs {
	jobs[i].Index = i
	// 计算 From
	if i == 0 {
		jobs[i].From = 0
	} else {
		jobs[i].From = jobs[i-1].To + 1
	}
	// 计算 To
	if i < d.totalPart - 1 {
		jobs[i].To = jobs[i].From + eachSize - 1
	} else {
		// 最后一个分片取到文件末尾
		jobs[i].To = d.fileSize - 1
	}
}
第 3 步:并发下载分片
启动 Goroutine 并发请求各个分片。在请求时,务必设置 Range 请求头。下载完成后,将数据暂存到内存或临时文件中(本例演示直接暂存内存中的 slice)。
func (d *FileDownloader) downloadPart(part filePart) error {
	// 构造 Range 请求头
	req, _ := http.NewRequest("GET", d.url, nil)
	req.Header.Set("Range", fmt.Sprintf("bytes=%d-%d", part.From, part.To))

	resp, err := http.DefaultClient.Do(req)
	if err != nil {
		return err
	}
	defer resp.Body.Close()

	// 读取 Body 内容
	data, err := io.ReadAll(resp.Body)
	if err != nil {
		return err
	}

	// 简单的长度校验
	expectedLen := part.To - part.From + 1
	if len(data) != expectedLen {
		return errors.New("Downloaded part length mismatch")
	}

	part.Data = data
	// 存储结果到共享切片中(在生产环境中需考虑加锁或 Channel)
	d.doneFilePart[part.Index] = part
	return nil
}
第 4 步:主调度与合成
使用 sync.WaitGroup 等待所有协程执行完毕,然后遍历 doneFilePart 按顺序写入磁盘。
func (d *FileDownloader) Run() error {
	// 1. 获取文件信息
	_, err := d.getHeaderInfo()
	if err != nil {
		return err
	}

	// 2. 生成任务队列
	jobs := generateJobs(d.totalPart, d.fileSize)

	// 3. 并发执行
	var wg sync.WaitGroup
	for _, job := range jobs {
		wg.Add(1)
		go func(j filePart) {
			defer wg.Done()
			err := d.downloadPart(j)
			if err != nil {
				log.Println("Part download failed:", err)
			}
		}(job)
	}
	wg.Wait()

	// 4. 合并文件
	return d.mergeFiles()
}
第 5 步:文件合并与校验
创建最终的目标文件,按索引顺序将各分片的 Data 写入。写入过程中可以实时计算哈希值用于最终校验。
func (d *FileDownloader) mergeFiles() error {
	path := filepath.Join(d.outputDir, d.outputFileName)
	outFile, err := os.Create(path)
	if err != nil {
		return err
	}
	defer outFile.Close()

	// 用于校验的 Writer
	writer := md5.New()
	io.Copy(outFile, nil) // placeholder for logic below

	for i := 0; i < d.totalPart; i++ {
		part := d.doneFilePart[i]
		// 必须确保分片已下载完成且按序写入
		_, err := outFile.Write(part.Data)
		if err != nil {
			return err
		}
		writer.Write(part.Data)
	}

	// 可选:计算最终文件 MD5 并与预期值对比
	finalMd5 := hex.EncodeToString(writer.Sum(nil))
	log.Printf("File merged successfully. MD5: %s", finalMd5)
	return nil
}
排错与注意事项
- 内存溢出风险:上述示例将所有分片数据存储在内存切片中。若下载数 GB 级别的大文件且并发数极高,可能导致 OOM。建议将
filePart中的数据改为先写入临时文件,或者限制总并发数。 - 服务端限制:部分服务器可能对单个 IP 的并发连接数有限制,或被识别为恶意爬虫而拒绝服务(返回 403)。请合理设置 User-Agent 和控制并发量。
- 非连续写入:在合并阶段,由于 Goroutine 的执行顺序不确定,务必依据
filePart.Index排序后依次写入磁盘,不能直接随意追加,否则会导致文件损坏。
总结
通过 HTTP Range 机制结合 Golang 的高并发特性,我们可以轻松构建一个高效的网络下载器。这种方式不仅加快了下载速度,还为开发更高级的工具(如支持断点续传的下载管理器)打下了基础。以上就是基于Go语言实现多线程快速下载大文件的详细内容,更多关于Go语言并发编程的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















