


MySQL 慢 SQL 优化思路与规范详解

面对线上数据库性能瓶颈,许多开发者往往只关注简单的查询改写,却忽略了底层索引原理和连接协议规范。本文从索引设计的最左前缀、冗余判断入手,深入剖析 GROUP BY 隐式排序、事务间隙锁及大分页等高频痛点,整理出一套实用的 MySQL 慢 SQL 优化思路与代码规范。
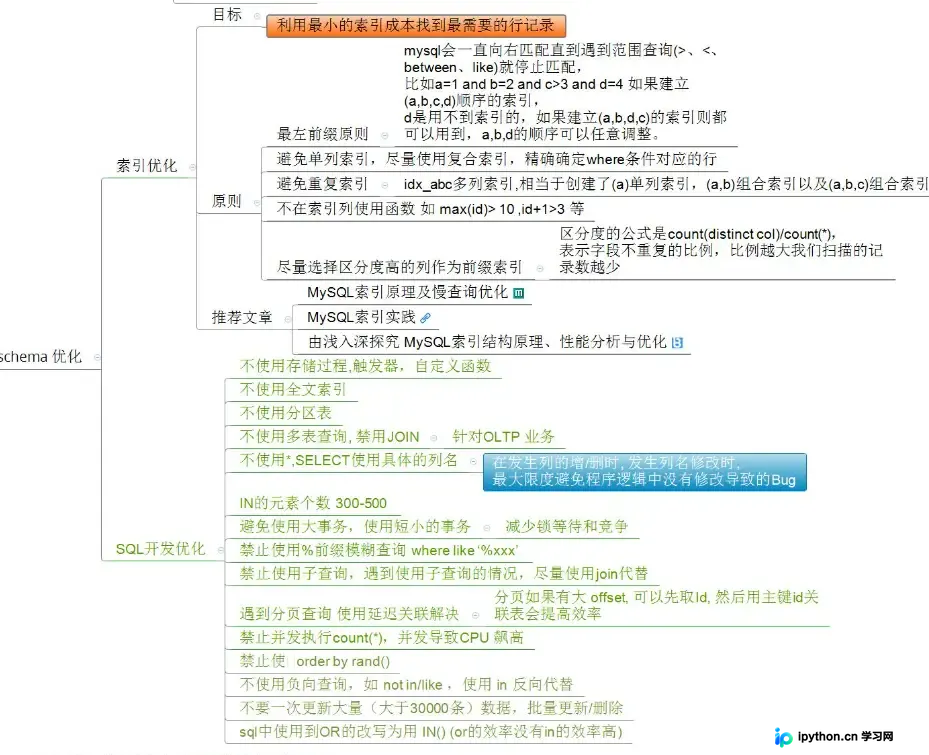
1、索引优化
第1步:评估并消除冗余索引
在建立索引前,必须确保表中不存在互相包含的冗余索引。例如,若表里已经存在复合索引 (a, b),则单独对字段 a 建立的单列索引即为冗余,应当删除。这能显著减少插入和更新时的维护开销。
第2步:合理设计复合索引
建立多条件查询的索引时,应将区分度最高的字段放在最前面。利用“最佳左前缀特性”,一个复合索引可以同时覆盖多个前缀条件的查询。
操作示例:针对 select ... where goods_no = 'aaa' and state=1,应创建复合索引:
ALTER TABLE `goods` ADD INDEX `idx_goodsno_state` (`goods_no`,`state`) USING BTREE;
第3步:使用短索引提升效率
对字符串列进行索引时,如果在前 N 个字符内多数值是唯一的,请勿对整个列进行索引。指定前缀长度不仅可以提高查询速度,还能节省磁盘空间和 I/O 操作。
第4步:控制单个表的索引数量
一个表上的索引个数不宜超过 8 个。索引并非越多越好,过多的索引会占据大量存储空间,并在每次写入数据时消耗额外的时间。
第5步:保障多表 JOIN 的效率
在多表关联查询中,务必保证被驱动表(后连接的表)的连接列上有索引。同时,必须严格检查 WHERE 条件中等号左右字段的类型和数据长度是否一致,否则会导致索引失效,进而引发全表扫描。
第6步:避免在索引列上进行运算或函数处理
核心规范:索引列不要使用函数、表达式或隐式转换。
- 错误示范:
where length(name)='Admin'或user_id + 2 = 10023。 - 常见陷阱:为便于按时间查询而在
create_tm上添加索引,但在查询时使用DATE_FORMAT(create_tm, '%Y%m'),这会致使索引失效。
第7步:谨慎使用 LIKE 与特殊运算符
- LIKE 规则:前缀匹配
'aaa%'可以使用索引;前后模糊匹配'%aaa%'无法使用索引,应避免生产环境大规模使用。 - 排除性查询:尽量避免使用
NOT、!=、<>、NOT IN等操作符,它们在索引树中寻找路径效率极低。 - NULL 值:包含 NULL 值的列不会被包含在索引中。复合索引中只要有一列为 NULL,该列在该索引中即无效。建议设计表结构时设置字段默认值非空。
第8步:理解范围查询阻断机制
在复合索引中,如果一个字段进行了范围查询(如 >、<、BETWEEN 或 IN),那么该字段右侧的其他字段将无法利用索引进行查找。
优化策略:根据业务场景调整索引字段顺序,将用于范围查询的字段后置或将排序字段前置以绕过此限制。
2、SQL 编写与执行优化规范
第9步:规范 LIMIT 与返回字段
- 精准截断:确定只需一条记录时,强制加上
LIMIT 1。找到后立即停止扫描,提升后半段查询性能。 - 严禁 SELECT *:程序端必须指定具体字段名称。这不仅减少网络传输和内存消耗,还能促使数据库走覆盖索引(Covering Index)。
第10步:GROUP BY 隐式排序问题(版本差异注意)
在 MySQL 5.7 及更早版本中,GROUP BY 默认会对结果集排序,导致出现 “Using filesort”。如果不需要排序,可显式指定 ORDER BY NULL 来禁止排序。
SELECT goods_no ... FROM mall_goods WHERE state = 1 GROUP BY goods_no ORDER BY NULL;
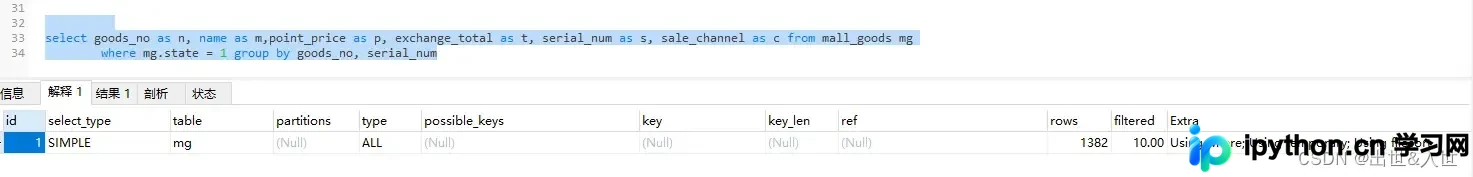
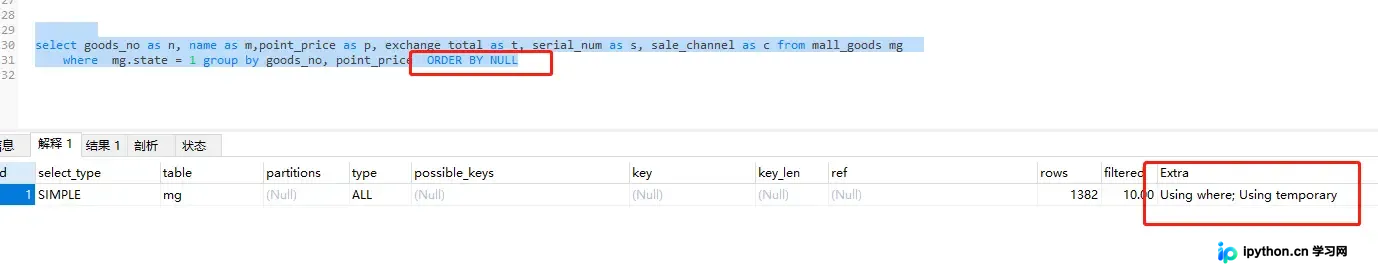
注意:MySQL 8.0 已移除 GROUP BY 的隐式排序特性。因此上述语法主要适用于 MySQL 5.7 环境。升级前请确认当前环境版本。
第11步:优化子查询与临时表(Using Temporary)
当 LEFT JOIN 的右表作为 WHERE 过滤条件时,容易产生临时表(Using temporary),影响性能。
重构方式:将对右表的过滤条件改为不作为查询条件的子查询,将 JOIN 降维或直接移除无关连接。
对比优化:
-- 优化前:可能产生临时表和文件排序
SELECT v.target, m.nickname
FROM app_recommend_controller r
LEFT JOIN video v ON r.video_id=v.id
LEFT JOIN member m ON v.member_id=m.id
WHERE v.display=1 AND v.game_id='9930';
-- 优化后:通过标量子查询代替 join 过滤
SELECT v.target, (SELECT nickname FROM member WHERE id=v.member_id) AS nickname
FROM app_recommend_controller r
LEFT JOIN video v ON r.video_id=v.id
WHERE v.display=1 AND v.game_id='9930';
第12步:控制事务规模与锁粒度
- 主键更新:事务内的更新语句尽量基于主键或唯一键(如
UPDATE ... WHERE id = XX),避免行锁升级为间隙锁(Gap Lock)导致并发阻塞或死锁。 - 最小化事务:一个事务内的 SQL 建议不超过 5 个,过长的持锁时间会严重影响数据库缓存命中率。
- 替代子查询:除了
SELECT,对于UPDATE/DELETE中的子查询,MySQL 优化器未必会转换为高效的 JOIN,建议在应用层拆分为多次查询或使用 JOIN。
第13步:高效处理大分页与统计
1. 大分页优化:
传统分页 LIMIT 10000, 10 会抛弃前一万条数据,越往后越慢。采用“游标法”:记住上次查询的最后一条 ID,下一页查询 WHERE id < last_id ORDER BY id DESC LIMIT 10。
2. COUNT 的正确用法:
对于 InnoDB 引擎,InnoDB 需要遍历索引进行统计。按执行效率从高到低推荐如下:
COUNT(*):官方推荐,专门优化,不取值累加。COUNT(1):与COUNT(*)几乎一样快。COUNT(主键 id):取出来判断不为空再累加,稍慢于前者。COUNT(字段):若允许为 NULL,需取出值判断后再累加,最慢。
第14步:大表结构与合并请求
- DDL 风险:对超过 100W 行的大表执行
ALTER TABLE会产生强表锁,必须经 DBA 审核并在业务低峰期执行。尽量将多个修改合并在一个 DDL 语句中完成。 - UNION vs UNION ALL:推荐使用
UNION ALL,因为它不会执行去重操作,节省 CPU 资源。 - 多表 JOIN 限制:线上环境多表 JOIN 尽量不超过 5 个表,优先选取结果集较小的表作为驱动表。
第15步:IN 替换 OR 提升检索速度
使用 OR 可能导致全表扫描或索引失效,而 IN 能更高效地利用索引。
-- 低效
SELECT * FROM t WHERE LOC_ID = 10 OR LOC_ID = 20;
-- 高效
SELECT * FROM t WHERE LOC_IN IN (10, 20);
第16步:混合排序规避
ASC 和 DESC 混用会导致索引失效。在需求评审阶段应尽量说服产品避免此类无序或混序要求。
第17步:复杂查询结果集阈值控制
包含 ORDER BY、GROUP BY 或 DISTINCT 的语句,在 WHERE 过滤后的中间结果集请保持在 1000 行以内。否则,排序和去重过程将在内存或磁盘中剧烈消耗资源,拖垮数据库。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















