


SQL Server如何利用DMV查询缺失索引及优化建议

在SQL Server性能调优中,通过查询优化器动态提供的系统视图,可以自动发现长期未建索引或索引组合不佳的表。掌握四大相关DMV视图的使用方法,能够快速获取包含列与等值/不等值列的建议,并通过预估收益判断优化优先级。
结果与目标
当数据库查询性能下降时,寻找合适的索引组合往往耗时费力。SQL Server从2005版本开始,内置了“自动”评估机制:在编译执行计划时,分析引擎会检测当前查询是否因缺少索引而效率低下,并据此生成建议。
本文主要讲解如何通过系统动态管理视图(DMV)直接查询这些建议数据,这是比使用DTA(Database Engine Tuning Advisor)工具更即时、更原生的方法。
准备条件
1. 环境要求: SQL Server 2005及以上版本。
2. 基本认知: 理解数据库索引的基本概念,知道什么是覆盖索引(Include Columns)、等值谓词(Equality)与不等值谓词(Inequality)。
3. 权限要求: 需要具备查询系统动态管理视图的权限。
核心操作:查看缺失索引的DMV视图
SQL Server提供了四个关键的视图来呈现这些信息,理解它们的作用域是进行优化的前提。
第1步:识别缺索引的表与字段详情
目的:找出哪些表经常被查询,且在WHERE子句中存在筛选字段或SELECT列表中包含未被覆盖的字段。
入口:视图 sys.dm_db_missing_index_details
动作与参数:
该视图记录自服务器启动以来所有的缺失索引信息(非持久化,重启后清空)。关键字段解读如下:
index_handle: 标识符,作为与其他视图关联的主键。database_id / object_id: 标记所属库及对象ID。equality_columns: 构成等值比较的列(如WHERE Table.Col = Constant),这是建立索引最优先的字段。inequality_columns: 构成不等值比较的列(如>,<,BETWEEN)。included_columns: 仅出现在SELECT列表中但不用于排序或过滤的列(即覆盖索引的包含列)。statement: 缺失索引的具体表名。
执行该视图查询后,可以得到类似以下结构的表格数据,其中直观展示了表名及需要建立的字段组合:
注意事项: 由于数据不持久化,若需保留历史记录,管理员必须编写定时作业定期将结果备份到其他表中。
第2步:获取具体的索引列映射
目的:某些情况下,直接从details视图中读取列信息可能受限于格式,或者需要针对特定索引句柄深入分析。
入口:函数 sys.dm_db_missing_index_columns(index_handle)
动作与参数:
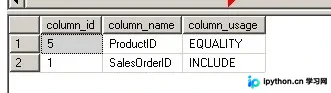
传入第一步得到的 index_handle 数值,返回带有索引顺序信息的列集合。注意:此处不包含空间索引。
第3步:整合信息并查看预估性能提升
目的:将库名、表名、缺失列拼接在一起,并计算如果建立该索引,能节省多少查询成本。
入口:关联三个视图:sys.dm_db_missing_index_group_stats、sys.dm_db_missing_index_groups 与 sys.dm_db_missing_index_details
动作与参数:
其中最核心的统计指标是 avg_user_impact。它表示:假设创建了该缺失索引组,用户查询平均可能获得的百分比收益(即查询成本的下降比例)。这个数值越高,说明优化紧迫性越强。
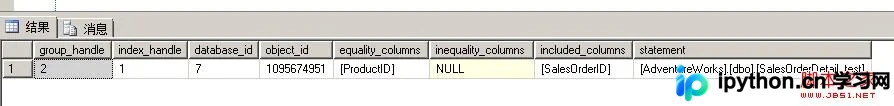
以下是合并查询并提供详细信息的完整脚本(以AdventureWorks数据库为例):
-- 查询提供缺失索引的数据库、架构和表的名称
-- 并提供应该用于索引键的列的名称
USE [AdventureWorks]
GO
SELECT migs.group_handle, mid.*
FROM sys.dm_db_missing_index_group_stats AS migs
INNER JOIN sys.dm_db_missing_index_groups AS mig
ON (migs.group_handle = mig.index_group_handle)
INNER JOIN sys.dm_db_missing_index_details AS mid
ON (mig.index_handle = mid.index_handle)
WHERE migs.group_handle = 2
执行上述语句可查看到详细的组别统计数据,例如:
第4步:获取完整的索引建议语句并落地
目的:根据视图输出的字段,构造出可以直接执行的 CREATE INDEX 脚本。
操作逻辑:
查看第一步查询出的 equality_columns(放在索引键中)和 included_columns(放在INCLUDE中)。
脚本示例:假设数据显示要在某测试表上使用 ProductID 作为主键,SalesOrderID 作为覆盖列:
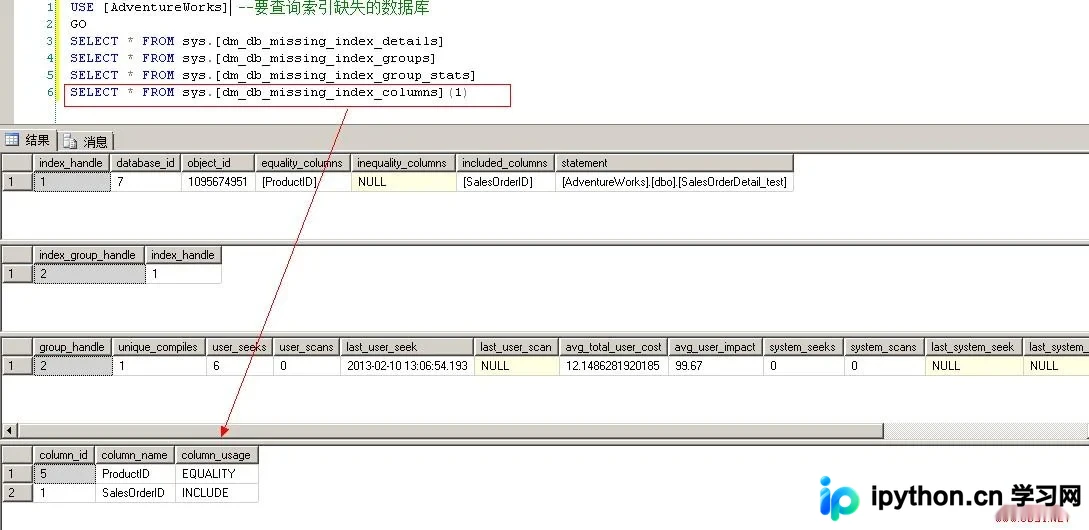
为了便于日常巡检,可以将所有相关的视图查询封装成一个存储过程或直接执行:
USE [AdventureWorks]
GO
SELECT * FROM sys.[dm_db_missing_index_details]
SELECT * FROM sys.[dm_db_missing_index_groups]
SELECT * FROM sys.[dm_db_missing_index_group_stats]
SELECT * FROM sys.[dm_db_missing_index_columns](1) --这里的1需要根据实际查到的index_handle替换
这通常会输出对应的列明细列表:
排错与建议确认
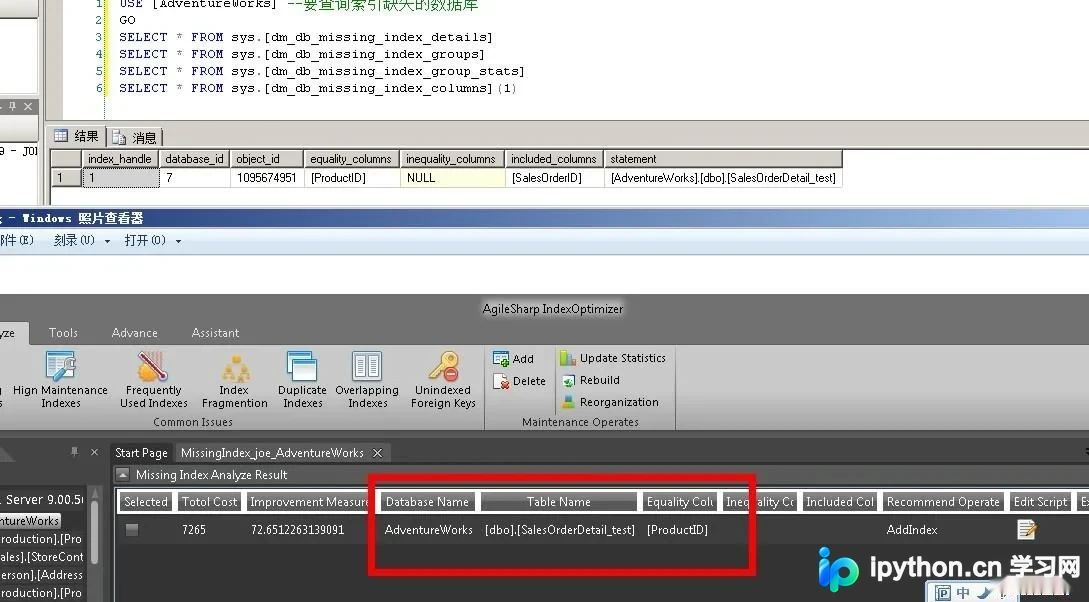
在使用各类工具(包括第三方优化插件)查看此类建议时,常能看到类似 Total Cost(总成本)与 Improvement Measure(改进度量)的字段。需要注意的是,不要盲目接受自动化给出的建议。
重要提醒:
1. DMV的建议是基于单一语句视角的,它不会考虑新加索引对UPDATE、INSERT操作的负面影响,也不会考虑维护索引带来的I/O开销。
2. 建议在应用前,使用 DTA (Database Engine Tuning Advisor) 进行综合模拟测试,或者手动验证该索引是否会破坏现有的高并发写入流程。
3. MSDN官方文档对每个字段的解释非常详尽,遇到歧义时应查阅对应MSDN链接。
部分开发者使用的增强分析界面可能会对这些字段做进一步封装,例如修正拼写错误(如将原本显示的Typo修复为Total Cost):
简要总结
通过以上四个步骤,我们可以系统性地利用SQL Server自身的监控能力,发现那些潜伏在日常查询中拖慢系统的“盲点”。核心在于关注 avg_user_impact 高低,并结合 sys.dm_db_missing_index_details 中的列定义,人工决策后实施索引构建。
以上就是SQLSERVER如何查看索引缺失及DMV使用介绍的详细内容,更多关于SQL Server数据库优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















