



金额合计看似只是一个 SUM(),但线上最常见的问题并不在语法本身,而在于原始数据、分组写法和执行成本。下面按实际排查顺序拆开说:先处理空结果和 NULL,再看金额字段类型是否可靠,接着避免 GROUP BY 写法出错,最后再讨论大表上的聚合性能。
为什么 SUM() 会返回 NULL 而不是 0
当查询结果为空,比如 WHERE 条件没有匹配到任何行时,SUM() 默认返回 NULL,不是 0。这在报表展示、接口返回值和后续计算里都容易引发空值问题。
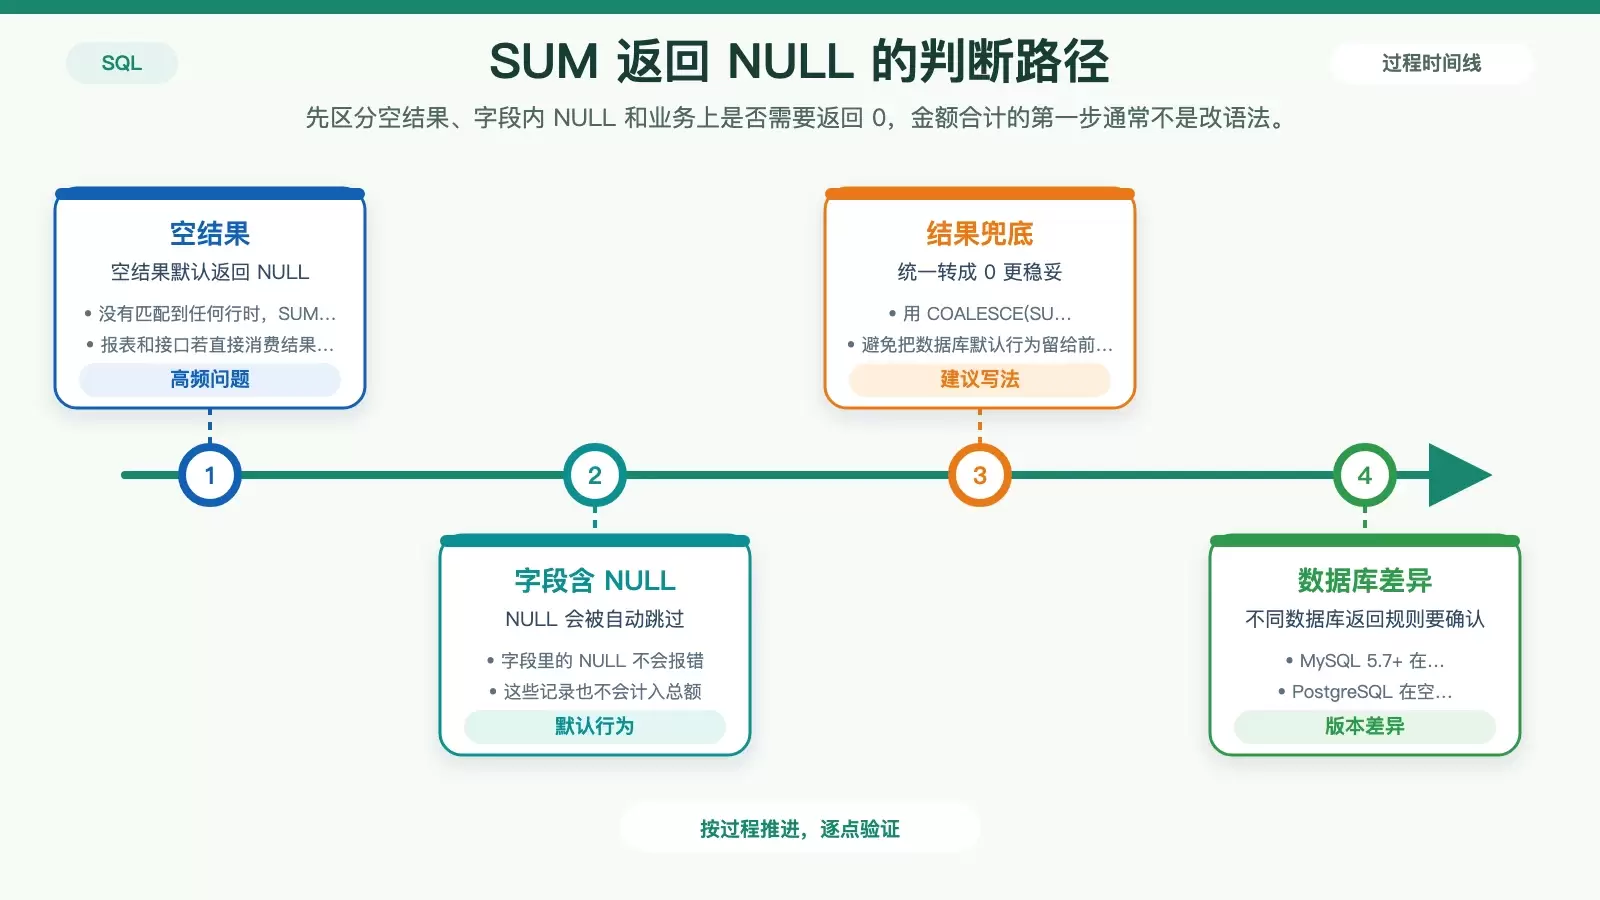
更稳妥的写法是直接把结果兜底成 0:
COALESCE(SUM(amount), 0)这里还有两个细节需要确认:
SUM()遇到字段中的NULL值时,会自动跳过,不报错也不计入合计。- MySQL 5.7+ 在
sql_mode包含STRICT_TRANS_TABLES时,对空组和不规范写法更敏感;PostgreSQL 在空结果时始终返回NULL。
所以,业务上要先判断“没数据”和“总额为 0”是不是同一件事。如果前端、报表或下游程序需要一个可直接计算的数字,建议统一使用 COALESCE(SUM(amount), 0)。
金额字段是字符串时,先清洗再求和
很多问题不是出在 SUM(),而是金额列本身存得不对。字段如果是 VARCHAR,还带有货币符号、千分位逗号等内容,直接执行 SUM(amount) 要么失败,要么被数据库静默转成错误结果。
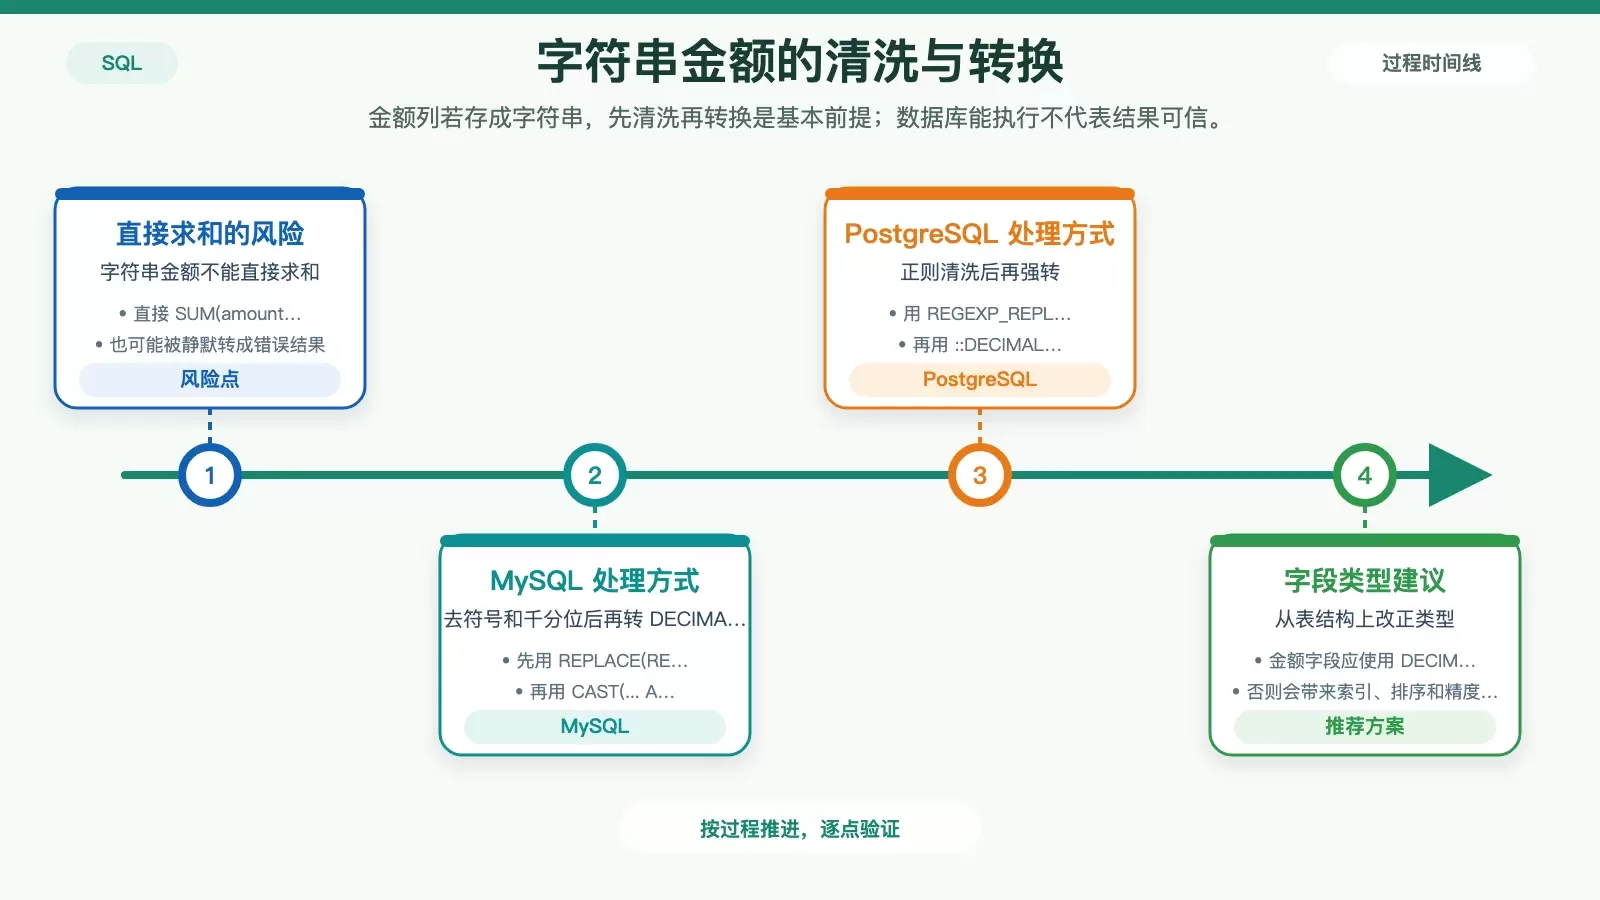
例如在 MySQL 里,'¥1,234.50' 可能被当成 0,这类结果最危险,因为 SQL 能跑通,但数据已经失真。
MySQL 的处理方式
先去掉货币符号和千分位,再转成数值类型:
REPLACE(REPLACE(amount, '¥', ''), ',', '')CAST(... AS DECIMAL(12,2))PostgreSQL 的处理方式
可以先用正则保留数字、负号和小数点,再强转为十进制:
REGEXP_REPLACE(amount, '[^0-9.-]', '', 'g')::DECIMAL字段设计的正确做法
金额字段应尽量使用 DECIMAL 或 NUMERIC,而不是字符串类型。原因不只是为了方便求和,还包括:
- 避免排序按字符顺序执行,导致金额大小规律错乱。
- 避免索引失效,影响筛选和聚合性能。
- 避免四舍五入和精度控制不可预期。
如果历史表已经把金额存成字符串,查询时至少要先清洗再转换;从长期看,还是应该把字段类型改回适合金额场景的十进制类型。
按用户或日期汇总时,GROUP BY 要写完整
做分组求和时,另一个高频问题是 GROUP BY 漏字段。比如你要统计每个用户的订单金额总和,只写了 GROUP BY user_id,但在 SELECT 中又取了 username,严格模式下就会报错。
典型报错如下:
Expression #2 of SELECT list is not in GROUP BY clause这种情况下有两种正规处理方式。
方式一:把所有非聚合字段写进 GROUP BY
GROUP BY user_id, username这是最直观也最安全的写法,适合分组维度本来就明确的查询。
方式二:对非分组字段使用聚合函数
MAX(username)这个写法的前提是 user_id 和 username 一一对应。否则虽然 SQL 能执行,但结果未必符合业务含义。
需要特别注意的是,不要为了让 SQL 通过而关闭相关 sql_mode。在 MySQL 8.0+ 默认严格模式下,报错本身就是在提醒你查询逻辑不完整;现在绕过去,后续版本升级或环境切换时往往会直接暴露问题。
大表上 SUM() 很慢,先看执行计划
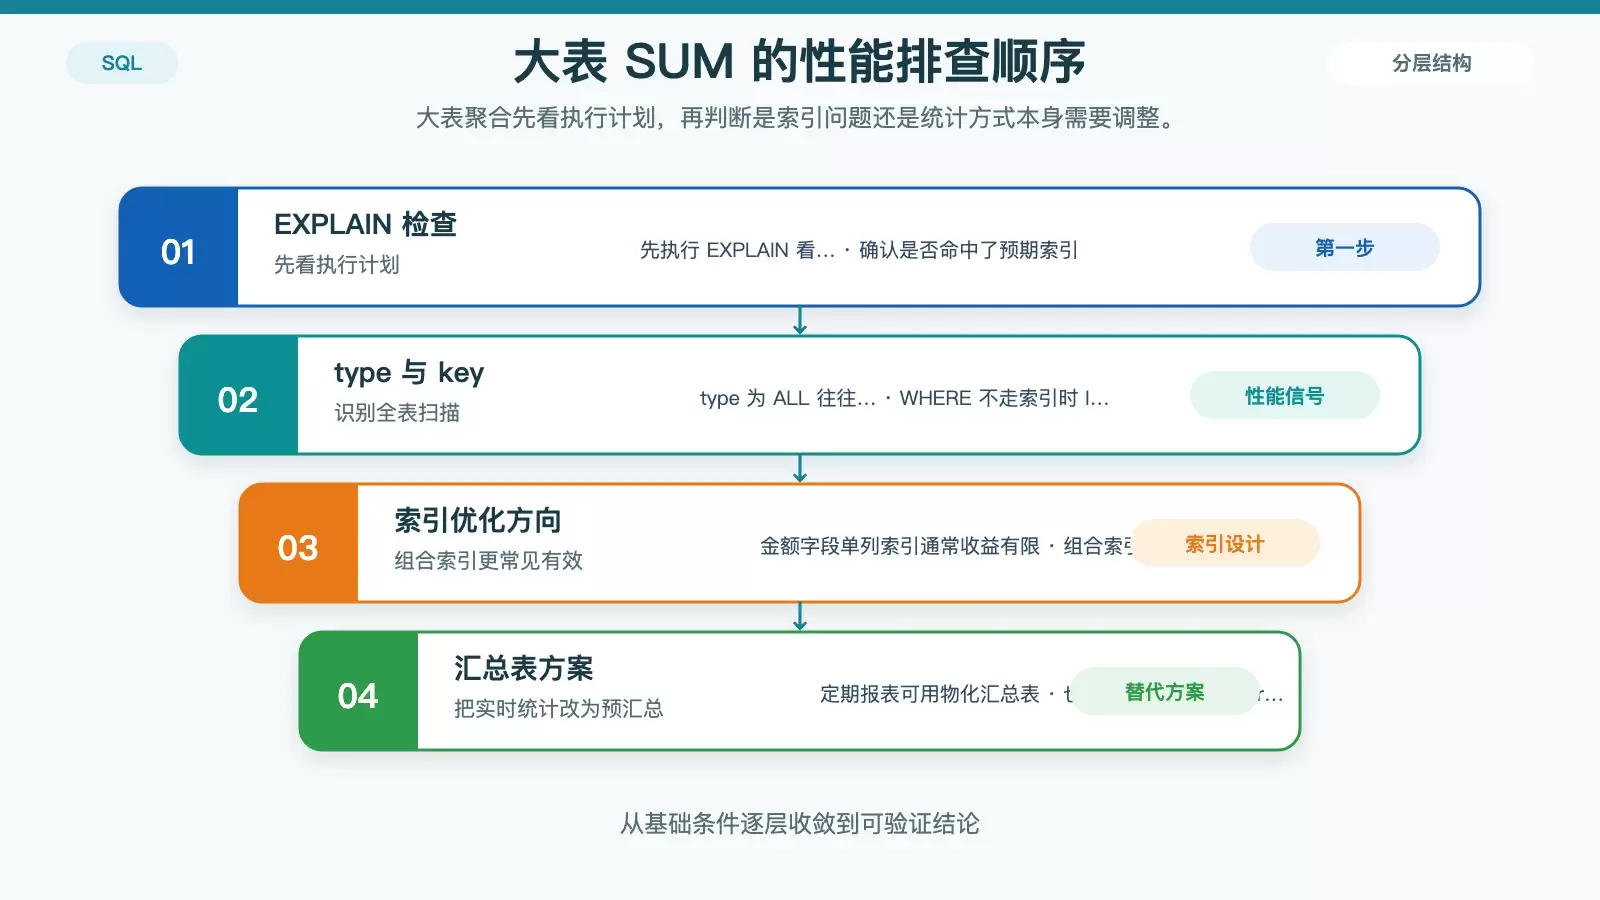
当表很大、筛选条件复杂,或者查询频率高时,SUM() 的瓶颈通常来自全表扫描和聚合带来的 I/O、CPU 开销。尤其是写了 WHERE 却没有命中索引,性能会明显下滑。
先用 EXPLAIN 看是否走索引
重点观察两个信息:
type是否为ALL,这通常表示全表扫描。key是否命中了预期索引。
如果这里已经显示全表扫,先别急着改 SQL 写法,优先判断筛选条件和索引设计是否匹配。
组合索引通常比金额列单列索引更有用
单独给金额字段建索引,很多时候收益不大;更常见的优化方向,是围绕查询条件和分组条件建立组合索引。例如:
(status, created_at, amount)这类索引更适合覆盖“按状态筛选 + 按时间范围统计”的常见金额汇总场景。
定期统计可以改用汇总表
如果业务只需要定时出报表,没必要每次都实时扫描明细表。可以考虑:
- 使用物化汇总表。
- 定时写入
summary表。
这样可以把高频聚合从在线查询阶段前移,明显减轻实时库压力。
写金额合计 SQL 时,优先检查这 4 件事
- 空结果是否需要用
COALESCE(SUM(amount), 0)兜底。 - 金额字段是不是
DECIMAL/NUMERIC,如果不是,是否已完成清洗和转换。 GROUP BY是否覆盖了所有非聚合字段,或是否正确使用了聚合函数。- 大表查询是否通过
EXPLAIN验证了索引命中情况,是否需要汇总表替代实时计算。
真正让 SUM() 失效的,往往不是函数不会用,而是空值处理、字段类型和数据质量没有先理顺。只要把这几项检查清楚,金额合计的结果和性能通常都能稳定下来。















