


Python多线程基础与线程阻塞机制详解

本文深入解析Python中的进程与线程概念,通过电影下载示例演示threading模块的基础用法。重点探讨多线程并发执行时的数据竞争问题,并详细讲解如何利用join方法实现线程阻塞,确保子线程任务完成后主线程再执行后续逻辑,从而保证程序执行的顺序性和数据一致性。
本文所依赖的环境为:
进程和线程的概念
进程概念
当我们运行一个程序时,系统首先会通过IO总线将该程序从存储介质加载到内存中,随后由cpu进行调度执行。此时,正在运行的程序被称为进程,它拥有独立的内存地址、内存空间和数据栈等资源。进程之间的通信通常被称为IPC,常见的实现方式包括管道、消息队列和套接字等。
线程概念
与进程不同,线程是运行在进程内部的基本执行单元,一个进程至少包含一个线程。在单个cpu核心中,同一时刻一个进程只能有一个线程处于工作状态,其他线程则处于挂起或睡眠状态。由于线程隶属于进程,它们共享进程的内存信息。线程间通信不仅可以利用共享内存,也可以使用管道、消息队列或套接字等方式进行交互。
线程优缺点
多线程是一种并发执行的方式,其主要优点在于能够同时处理多个任务,从而显著提升执行时间和系统效率。
例如,如果我们编写一个python服务器来下载电影,单线程模式下一次只能下载一部电影;而采用多线程技术后,可以实现“同时”下载n部电影,从而大幅提高下载效率。
然而,多线程并非万能,并发冲突是其主要挑战之一。以掘金点赞功能为例,如果不对点赞变量进行并发控制,可能会导致数据不一致的情况发生。
在python中如何使用线程
在使用python编写多线程代码之前,我们先通过一个小案例进行说明,假设我们使用python编写了一个电影下载程序。
import time

def downloadMovie(i):
    print("%s 开始下载编号为%s电影中。。。" % (time.strftime("%Y-%m-%d %H:%M:%S", time.localtime()), str(i)))
    time.sleep(5)
    print("%s 编号为%s电影下载完毕" % (time.strftime("%Y-%m-%d %H:%M:%S", time.localtime()), str(i)))

def main():
    for i in range(5):
        downloadMovie(i)

if __name__ == '__main__':
    main()
我们假设模拟下载电影的程序,其中下载过程使用time.sleep来模拟耗时操作。在未使用多线程的情况下,其执行流程如下:
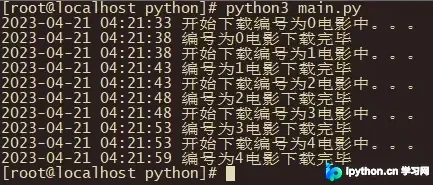
从代码可以看出,程序是顺序执行的,必须等待前一部电影下载完成后,才能开始下载下一部。
如果使用线程来实现该需求,我们可以按照以下方式编写代码:
import time
import threading

def downloadMovie(i):
    print("%s 开始下载编号为%s电影中。。。" % (time.strftime("%Y-%m-%d %H:%M:%S", time.localtime()), str(i)))
    time.sleep(5)
    print("%s 编号为%s电影下载完毕" % (time.strftime("%Y-%m-%d %H:%M:%S", time.localtime()), str(i)))

def main():
    for i in range(5):
        t = threading.Thread(target=downloadMovie,args=(i,))
        t.start()

if __name__ == '__main__':
    main()
上述代码在原始代码基础上,引入了threading库。在循环中,我们使用Thread类来创建线程实例对象,需要传入target参数指定目标函数,以及args参数指定函数参数。注意,target需要传入函数名称,而args需要传入参数列表,且参数必须是可迭代对象。因此,当只有一个参数时,需要在该参数后添加一个,逗号以构成元组。最后,调用start方法启动线程执行。
运行后的效果如下:
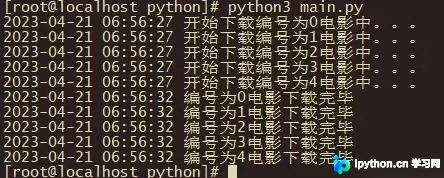
可以发现,程序几乎同步地打印了“下载开始”的信息,同时也几乎同时打印了“下载完毕”的信息,体现了多线程的并发特性。
总结来说,启动一个线程非常简单:只需引入threading模块,定义Thread类作为线程对象,最后调用start()方法即可运行。
线程阻塞也很重要
既然线程可以直接运行,为什么还需要阻塞机制呢?我们修改上述需求:下载完视频后,需要对视频进行压缩。由于本文仅讨论线程,因此压缩操作使用print函数代替。我们可以尝试如下操作:
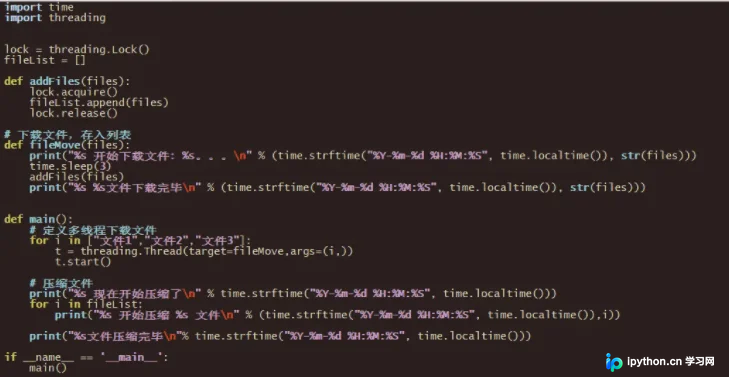
在上面的代码基础上,我们增加了两个步骤:1. 将下载好的文件路径放入列表fileList中;2. 最后遍历fileList列表中的文件进行压缩,并打印“压缩完毕”。乍看之下似乎没有问题。
那我们来运行一下这段代码呢?
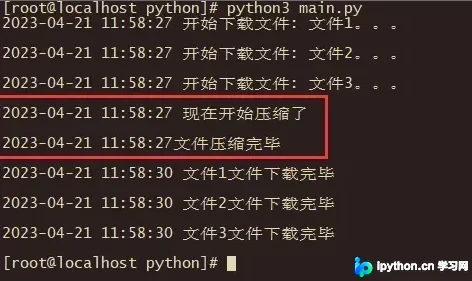
结果显然不符合预期:文件尚未下载完成,压缩操作就已经开始;而且压缩操作完成后,才输出文件下载完毕的信息。这是为什么呢?
这是因为线程启动后,如果不设置阻塞,它会一直在后台异步执行。以刚才的案例为例,我们可以将其理解为:
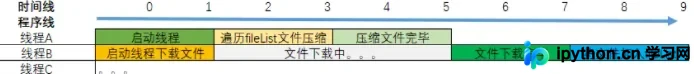
如上图所示,启动线程后,线程在后台运行,主线程立即执行遍历fileList列表的步骤。然而,此时fileList列表恰好为空,因此程序尝试压缩空文件。直到压缩操作完成,文件下载才真正结束。
此时,我们需要等待线程执行完毕后,再执行后续语句,否则后续操作将失去意义。因此,引入线程阻塞机制至关重要。我们需要确保所有下载线程执行完毕后,再开始压缩文件,只需在线程对象上增加一个join方法即可,修改后的代码如下:
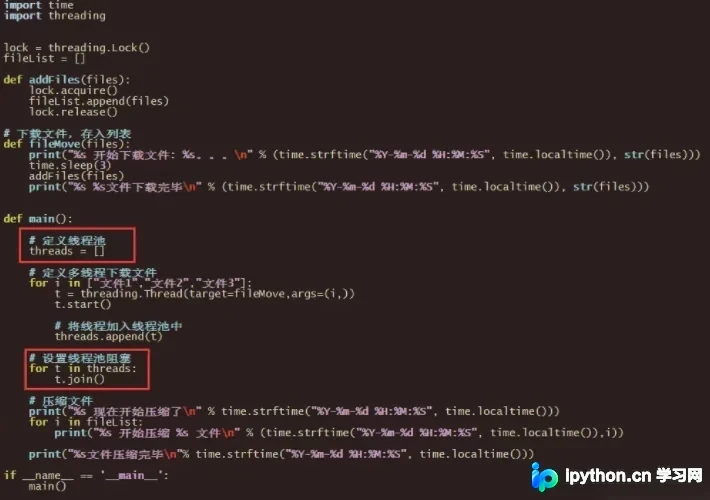
在原有代码基础上,我们需要先定义一个线程池(或列表)来存放已创建的线程,然后遍历该线程池,对每个线程设置阻塞。这样,程序会等待所有线程执行完毕后再进行后续操作。由于后续的压缩操作依赖于前序下载的结果,因此阻塞是必不可少的。程序执行结果为:
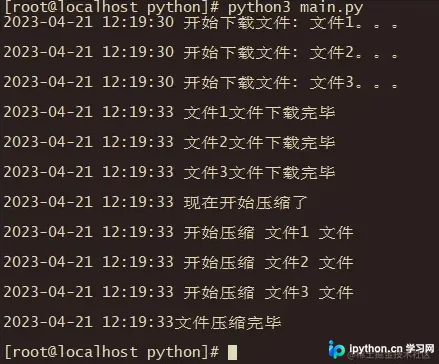
这个流程图可以理解为这样的逻辑:

现在,你应该明白阻塞机制的作用了吧。
总结
本文介绍了python的多线程机制,这里仅简单使用了threading库。在python中,多线程的库不仅限于此,还有thread、Queue等模块可供选择。最后,通过一个简单示例说明了线程阻塞的重要性。
以上就是浅析Python中线程以及线程阻塞的详细内容,更多关于Python线程的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















