


使用Python和BeautifulSoup批量抓取CSS模板

本文介绍如何使用Python结合BeautifulSoup库批量抓取指定站点的CSS模板资源。通过解析页面DOM结构提取目标链接,自动下载压缩文件至本地目录。附带完整代码示例、环境配置步骤及常见报错解决方法,帮助开发者快速实现静态资源的自动化采集。
实现原理与运行环境
该方案的核心逻辑是模拟浏览器请求目标列表页,利用CSS选择器精准定位模板入口链接与下载按钮地址,随后逐个发起请求并将远程ZIP文件流写入本地磁盘。运行前需确保系统已安装Python环境(建议Python 3.x)及基础网络访问权限。
核心抓取代码
#!/usr/bin/env python
# -*- coding: utf-8 -*-
import urllib.request
import os
import time
from bs4 import BeautifulSoup

start = time.time()
path = os.getcwd() + '/模板之家抓取的模板/'
if not os.path.isdir(path):
    os.mkdir(path)

# 目标列表页地址(可根据实际翻页规律手动修改)
url = "http://www.cssmoban.com/cssthemes/index_80.shtml"
theme_url = 'http://www.cssmoban.com/cssthemes/'

try:
    req = urllib.request.Request(url)
    response = urllib.request.urlopen(req)
    soup = BeautifulSoup(response.read(), 'html.parser')

    # 提取列表页中的模板详情页链接
    result = soup.select('p[class="title"] a')

    for item in result:
        link = item['href']
        new_url = theme_url + link.split('/')[-1]

        detail_resp = urllib.request.urlopen(new_url)
        detail_soup = BeautifulSoup(detail_resp.read(), 'html.parser')

        # 定位详情页内的下载按钮链接
        btn_links = detail_soup.select('.btn a')
        if len(btn_links) > 1:
            down_url = btn_links[1]['href']

            # 使用时间戳命名防止并发或重复下载冲突
            local_file = path + time.strftime('%Y%m%d%H%M%S', time.localtime(time.time())) + '.zip'
            urllib.request.urlretrieve(down_url, local_file)
except Exception as e:
    print(f'抓取异常: {e}')
finally:
    end = time.time()
    print('模板抓取完成!')
    print(f'一共用时:{end-start:.2f}秒')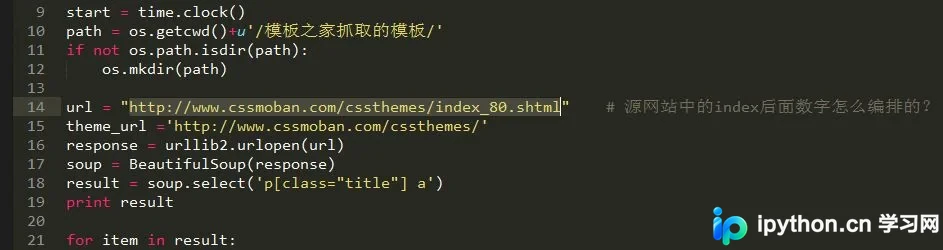
操作步骤说明
第1步:安装解析库
打开终端或命令提示符,进入项目所在目录,执行以下命令获取HTML解析依赖:
pip install beautifulsoup4
目的:解决脚本中 from bs4 import BeautifulSoup 的导入报错。重要参数:若使用虚拟环境,请确保当前终端已激活对应环境。
第2步:配置抓取目标与分页
编辑脚本中的 url 变量。由于部分模板站的分页参数呈现非线性特征(如 index_80.shtml ),直接按页码递增可能导致404或空页。此时建议在代码中手动拼接需要抓取的固定地址,或提前观察页面DOM规律进行调整。
第3步:执行脚本并确认结果
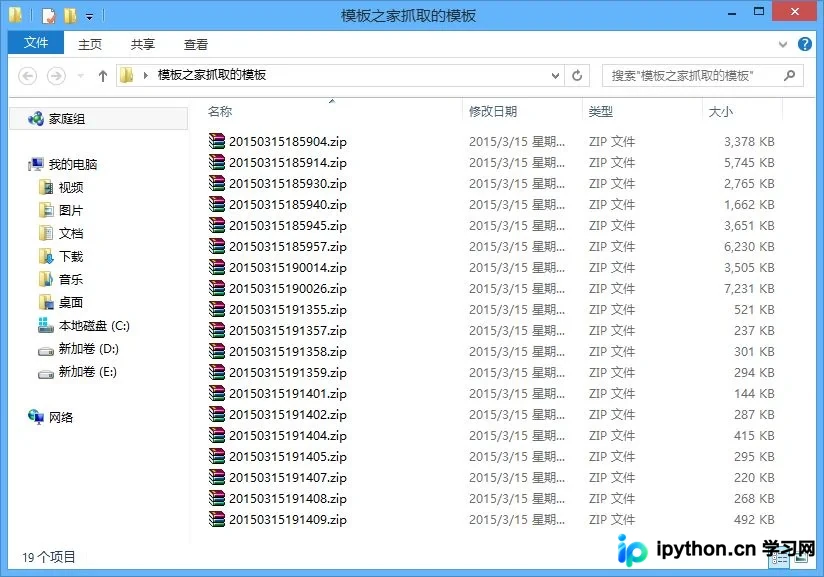
保存修改后的py文件,在终端运行 python your_script_name.py。脚本会在当前工作区自动创建 /模板之家抓取的模板/ 子目录,随后依次解析列表页与详情页,将ZIP源文件落地保存。等待控制台打印 “模板抓取完成!” 即为流程结束。
常见问题排查
- 报 ConnectionError 或超时:目标服务器可能存在反爬策略或网络波动。可在脚本中加入
time.sleep()控制请求频率,或检查代理配置。 - Select 选择器返回空列表:网站UI改版导致类名变更。右键查看目标元素实际Class名称,替换
p[class="title"]或.btn a即可适配新结构。 - 下载文件无法解压:部分站点返回的是拦截页面而非真实Zip流。需核对
down_url拼接后的最终链接是否在浏览器中可直接访问。
简要总结
通过简单的HTTP请求与DOM文本提取,即可将耗时的手动复制下载转变为一次性自动化任务。掌握基本的选择器匹配与文件流保存逻辑后,可灵活扩展至其他静态资产采集场景。以上就是使用Python批量抓取CSS模板的详细内容,更多关于Python自动化脚本与网页数据采集的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















