


适合Python初学者的练手项目:爬虫、数据分析与自动化脚本
适合Python初学者的三个实用练手项目详解:从静态网页爬虫、多源账单数据分析到本地文件批量整理脚本,提供清晰步骤、完整代码及避坑指南。
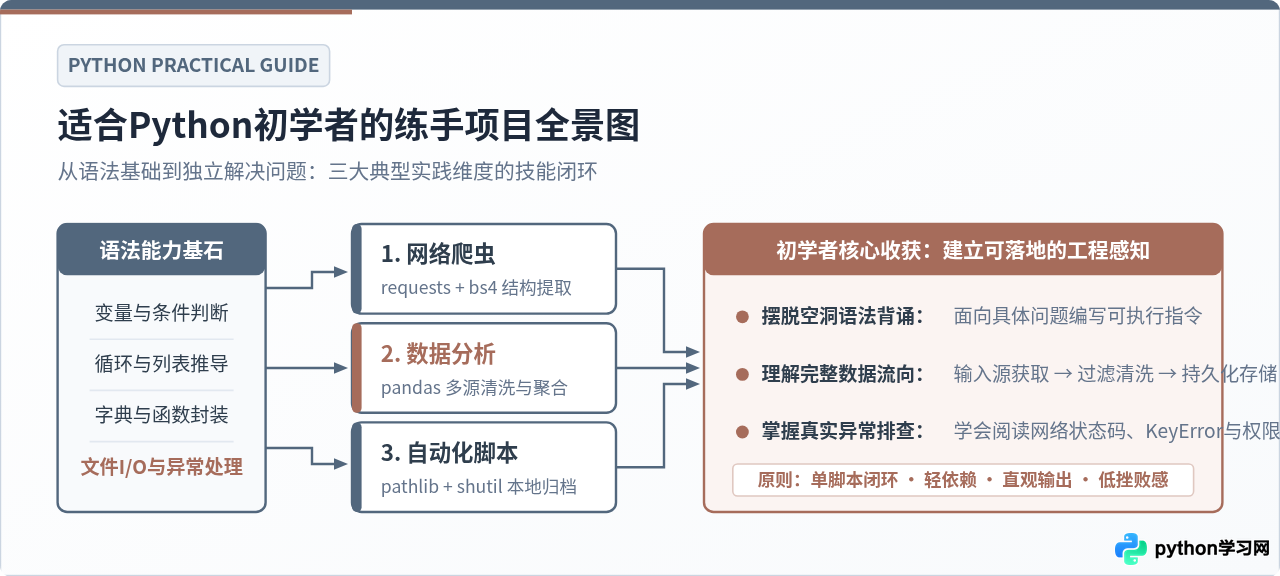
一、初学者练手项目的筛选标准与常见误区
初学编程时最容易犯的错误是过早尝试大型综合项目。例如很多教程建议新手“用Django写一个全功能电商商城”或“手写分布式网络爬虫”,这类项目往往包含用户认证、数据库迁移、多进程并发、反爬逆向以及前端模板等复杂概念。初学者一旦陷入密集的报错和复杂的中间件配置,很容易在看到实际成果前丧失信心。
真正适合新手的练手项目应当满足四个核心条件:一是目标单一,只解决一个明确的具体问题;二是轻量依赖,优先使用内置标准库或主流单库,不需要在本地额外启动数据库服务;三是反馈即时,程序运行后在几秒内就能看到终端输出或文件生成;四是可追溯易排查,遇到错误时调用栈短小,通过单断点或简单的打印语句就能定位原因。
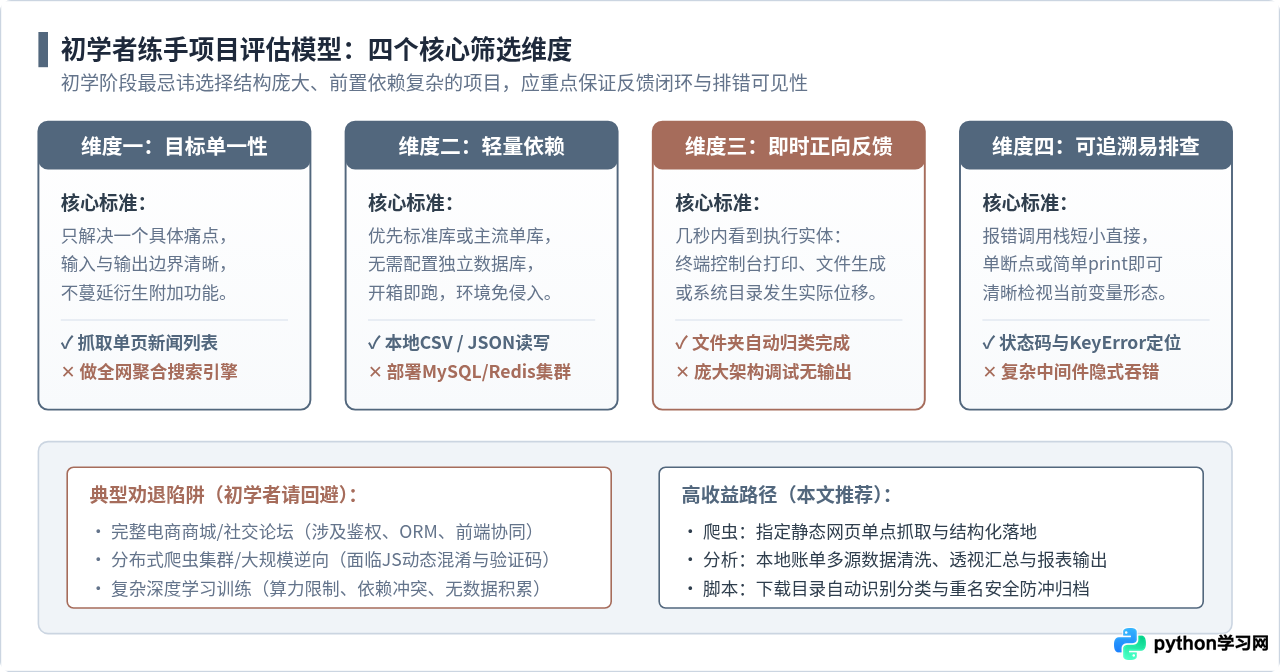
基于上述原则,网络爬虫、数据分析和自动化脚本是收益最高的切入点:爬虫解决外部网络数据的获取问题;数据分析解决杂乱表格的整理与统计问题;自动化脚本则直接处理本地日常繁琐的文件与系统操作。下面逐一拆解这三个方向的典型项目实践。
二、网络爬虫方向:静态技术简报采集与结构化归档
网络爬虫是理解“网络协议”与“DOM树形结构”最直观的方式。对于初学者,切忌一开始就去抓取需要登录、滑块验证码或带有高强度JS动态渲染的大型商业站点。最适合上手的目标是结构固定的静态资讯列表或开源技术博客。
1. 核心流程与运行机制
完成一个基础爬虫需要经历四个明确步骤:构造携带合规请求头的HTTP请求、校验服务端响应状态码与字符编码、使用解析器定位HTML节点并提取文本与属性、最后将清洗后的列表数据持久化写入本地CSV文件。
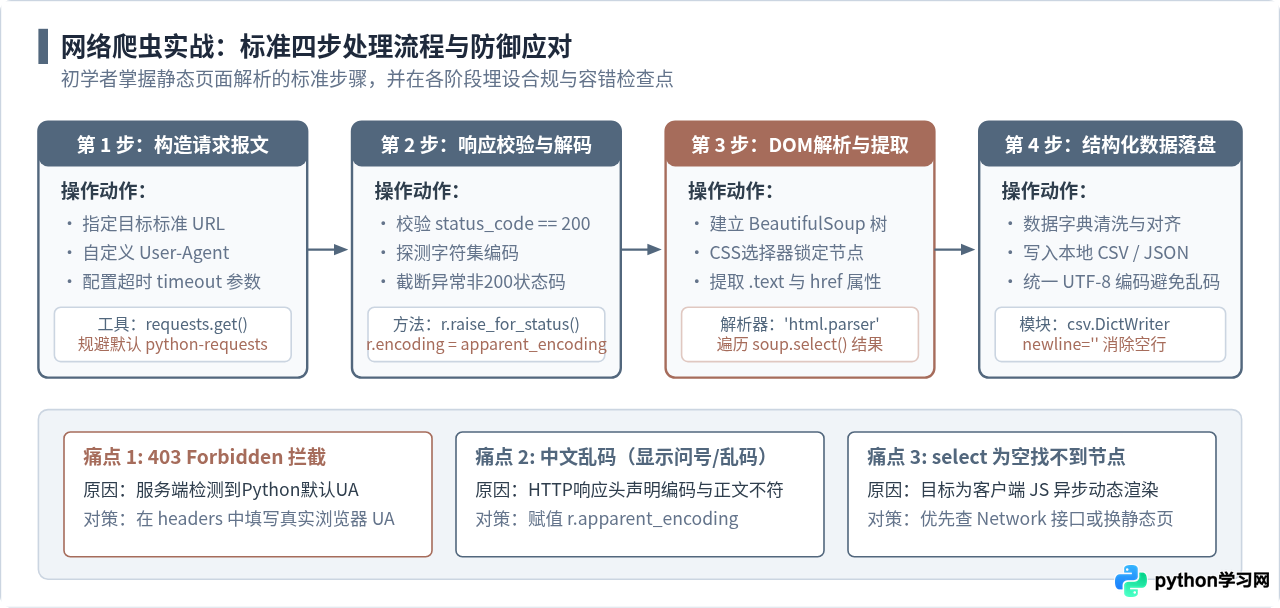
2. 完整实战代码示例
下面是一个抓取指定静态技术站点精选文章标题、发布日期与阅读链接的完整脚本。项目使用 requests 负责网络传输,使用 beautifulsoup4 负责HTML解析,并利用标准库 csv 存储结果。
import csv
import requests
from bs4 import BeautifulSoup

def fetch_tech_articles(target_url, output_csv_path):
    # 1. 显式设置 User-Agent,规避 Python 默认请求头带来的 403 拦截
    headers = {
        'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) '
                      'AppleWebKit/537.36 (KHTML, like Gecko) '
                      'Chrome/120.0.0.0 Safari/537.36'
    }

    print(f"[*] 正在发起网络请求: {target_url}")
    try:
        response = requests.get(target_url, headers=headers, timeout=10)
        # 2. 状态码校验:非 200 会主动抛出 HTTPError
        response.raise_for_status()
    except requests.RequestException as err:
        print(f"[!] 网络请求失败: {err}")
        return False

    # 针对中文网页自动检测编码,避免页面返回中文乱码
    response.encoding = response.apparent_encoding

    # 3. 构建 DOM 树并使用 CSS 选择器提取节点
    soup = BeautifulSoup(response.text, 'html.parser')
    article_nodes = soup.select('div.article-item')

    extracted_data = []
    for item in article_nodes:
        # 使用 select_one 精确获取各子标签,并处理可能为空的边界情况
        title_tag = item.select_one('h2.title')
        date_tag = item.select_one('span.publish-date')
        link_tag = item.select_one('a.detail-link')

        if title_tag and link_tag:
            title = title_tag.get_text(strip=True)
            link = link_tag.get('href', '').strip()
            date = date_tag.get_text(strip=True) if date_tag else '未知日期'

            extracted_data.append({
                '标题': title,
                '发布日期': date,
                '文章链接': link
            })

    print(f"[*] 解析完成,成功提取到 {len(extracted_data)} 篇有效文章")

    # 4. 写入本地 CSV 文件
    if extracted_data:
        fieldnames = ['标题', '发布日期', '文章链接']
        with open(output_csv_path, mode='w', encoding='utf-8-sig', newline='') as f:
            writer = csv.DictWriter(f, fieldnames=fieldnames)
            writer.writeheader()
            writer.writerows(extracted_data)
        print(f"[+] 数据已成功保存到本地: {output_csv_path}")
        return True
    else:
        print("[!] 未在页面中找到符合选择器的文章项,请检查选择器配置")
        return False

if __name__ == '__main__':
    # 示例调用(此处以本地测试或公开静态页面为例)
fetch_tech_articles('https://example.com/tech-news', 'tech_articles.csv')- 403 Forbidden 报错:大多数现代Web服务器会检查
User-Agent标头。如果不传自定义头,requests默认携带python-requests/2.x.x,会被防火墙直接阻断。 - 中文出现“烫烫烫”或问号乱码:不要依赖
response.text的推测编码。在读取text之前显式调用response.encoding = response.apparent_encoding。 - 选择器返回列表为空:先在浏览器中右键点击“查看网页源代码”。如果在源代码中搜不到目标文字,说明页面由前端 JavaScript 异步渲染(SPA架构),单纯使用
requests无法获取内容,初学者建议换选纯服务端渲染的静态页面作为练习目标。
三、数据分析方向:个人消费账单多源汇总与透视报表
很多人以为数据分析就是训练复杂的机器学习模型,但实际工作中 80% 的时间都在做数据清洗(Data Cleaning)与结构重塑。从微信支付、支付宝或银行客户端导出的流水账单,往往格式不统一、包含特殊货币符号、存在大量空缺值,这恰好是初学者练习 pandas 库的最佳现实素材。
1. 核心流程与数据形态演变
练习此项目的核心收获是掌握表格结构化转换的思维模式。初学者必须摆脱用 for 循环逐行遍历二维列表的直觉习惯,学会利用列向量运算、条件掩码过滤以及 groupby 聚合统计。
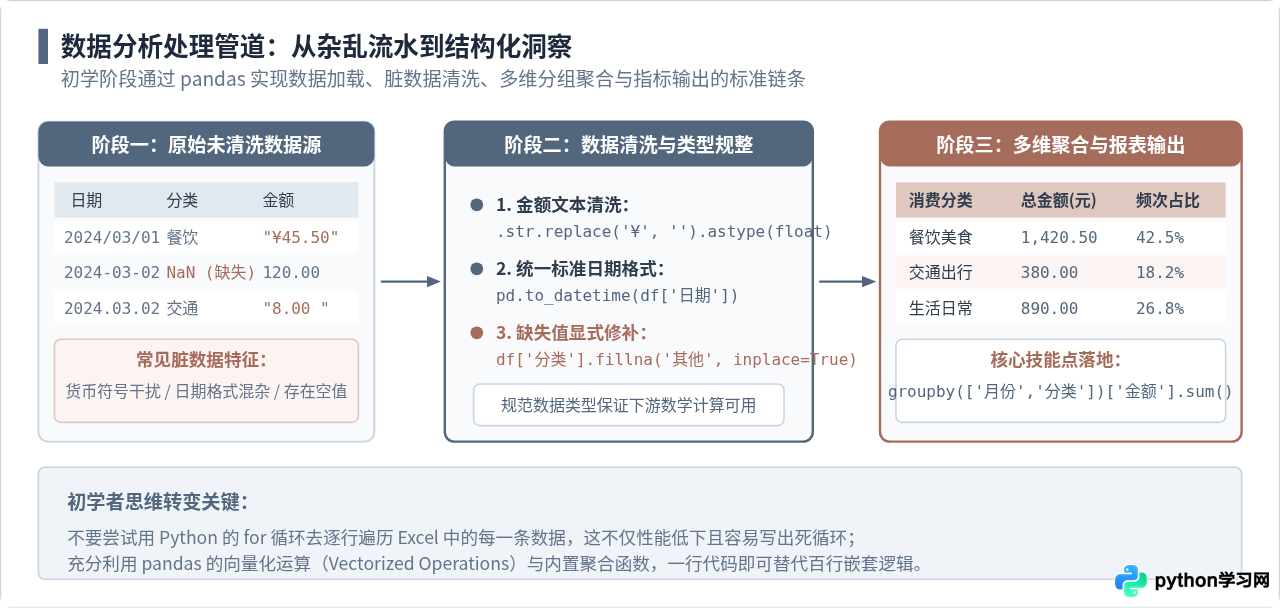
2. 完整实战代码示例
以下代码读取包含杂乱格式的原始交易明细表,自动清洗金额与日期、填补缺失分类,并按月份和交易类别聚合计算总支出、交易频次及占比,最终输出汇总报表。
import pandas as pd
import numpy as np

def analyze_expense_records(input_csv, summary_output_csv):
    print(f"[*] 正在读取原始交易流水: {input_csv}")
    # 1. 加载 CSV 文件
    df = pd.read_csv(input_csv)

    print(f"[*] 原始数据规模: {df.shape[0]} 行, {df.shape[1]} 列")

    # 2. 数据清洗:去除前后空白字符
    df.columns = df.columns.str.strip()

    # 3. 金额列清洗:去除货币符号 '¥'、英文逗号 ',' 并转为数值型
    # 使用 .copy() 避免触发 SettingWithCopyWarning
    df = df.copy()
    if df['金额'].dtype == object:
        df['金额'] = (
            df['金额']
            .astype(str)
            .str.replace('¥', '', regex=False)
            .str.replace(',', '', regex=False)
            .str.strip()
        )
        df['金额'] = pd.to_numeric(df['金额'], errors='coerce')

    # 4. 缺失值处理:金额为空的直接剔除,分类为空的填充为 '其他消费'
    df = df.dropna(subset=['金额'])
    df['分类'] = df['分类'].fillna('其他消费').astype(str).str.strip()

    # 5. 标准化日期并提取月份维度
    df['交易时间'] = pd.to_datetime(df['交易时间'], errors='coerce')
    df = df.dropna(subset=['交易时间'])
    df['月份'] = df['交易时间'].dt.strftime('%Y-%m')

    # 6. 多维聚合统计:按月份和分类统计总额与频次
    grouped = df.groupby(['月份', '分类'])['金额'].agg(
        总金额='sum',
        交易笔数='count'
    ).reset_index()

    # 计算各月内各项支出的占比
    month_totals = grouped.groupby('月份')['总金额'].transform('sum')
    grouped['支出占比'] = (grouped['总金额'] / month_totals * 100).round(2).astype(str) + '%'
    grouped['总金额'] = grouped['总金额'].round(2)

    # 7. 导出结构化分析结果
    grouped.to_csv(summary_output_csv, index=False, encoding='utf-8-sig')
    print(f"[+] 统计汇总表已生成: {summary_output_csv}")

    # 控制台打印前 5 行预览
    print("\n--- 报表明细预览 ---")
    print(grouped.to_string(index=False))
    return grouped

if __name__ == '__main__':
    # 构造演示输入数据并执行分析
    sample_data = {
        '交易时间': ['2024/03/01 12:30', '2024-03-02 08:15', '2024.03.05 19:40', '2024-03-12 18:00', '2024-04-01 09:00'],
        '分类': ['餐饮美食', '交通出行', np.nan, '餐饮美食', '生活日用'],
        '金额': ['¥45.50', '8.00 ', '120.00', '68.00', '¥230.50']
    }
    pd.DataFrame(sample_data).to_csv('raw_bills.csv', index=False, encoding='utf-8-sig')
analyze_expense_records('raw_bills.csv', 'monthly_expense_summary.csv')- SettingWithCopyWarning 警告:对过滤后的 DataFrame 切片直接赋值时常见此警告。在切片后调用
.copy()可以显式告知 pandas 创建独立副本。 - 求和结果变成长字符串拼接:这是因为“金额”列在读入时被识别为
object(字符串),直接使用sum()会执行文本连接。必须使用pd.to_numeric()显式转为浮点数后再做运算。 - 聚合后列名丢失或层级错乱:使用
groupby后如果不加.reset_index(),分组字段会留在行索引(Index/MultiIndex)中,导致导出 CSV 时缺失表头或难以进行二次关联。
四、自动化脚本方向:本地下载目录自动分类与安全归档
自动化脚本是初学者最能体验“代码提升工作效率”的方向。无论是 Windows 还是 macOS,用户的“下载(Downloads)”文件夹经过几个月使用,往往会堆放上百个不同扩展名的安装包、文档、解压包和图片,查找文件耗时费力。
编写一个文件自动分类归档脚本,仅需使用 Python 自带的标准库 pathlib 和 shutil,无需安装任何第三方包,即可在数秒内整理数千个文件。
1. 核心流程与防御机制
新手编写文件系统操作脚本,最致命的问题是由于覆盖同名文件而导致数据丢失,或者递归遍历时把自身新创建的归档文件夹移动进子目录造成死循环。因此,严密的状态分支判定与安全防冲设计不可或缺。
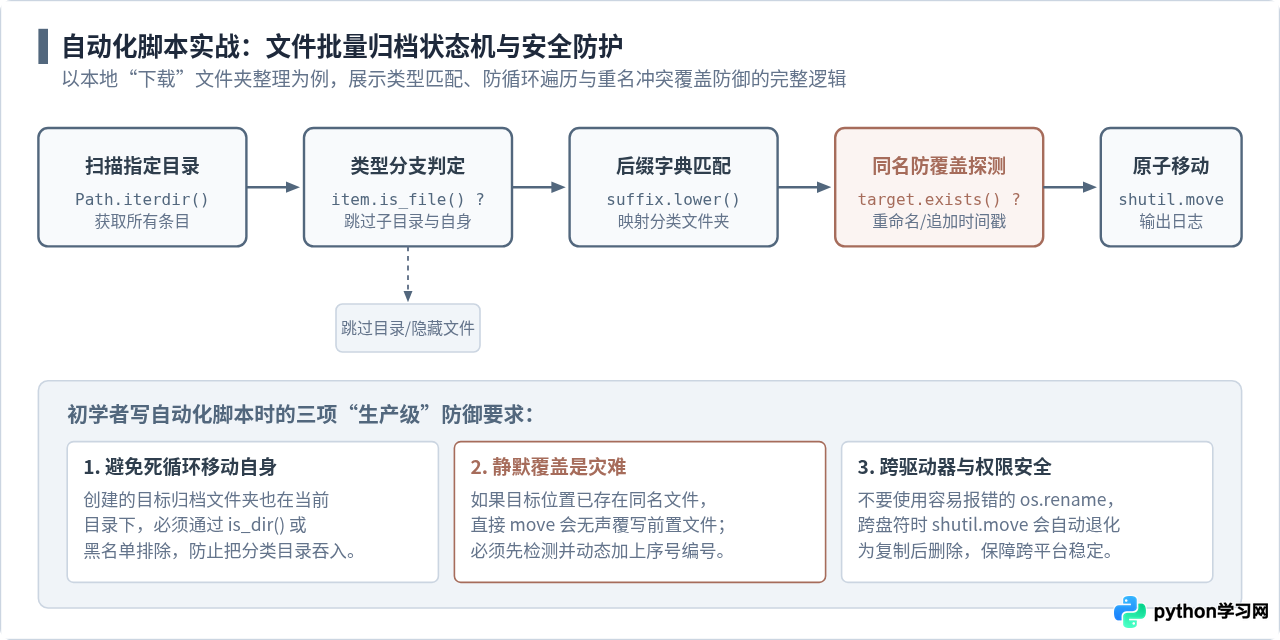
2. 完整实战代码示例
以下脚本通过扩展名规则字典映射目标文件夹,遍历指定路径下的文件,自动跳过目录与隐藏文件,并在遇到同名文件时自动增加递增编号,确保操作安全。
import shutil
from pathlib import Path

# 扩展名分类映射字典
CATEGORY_MAP = {
    '图片': ['.jpg', '.jpeg', '.png', '.gif', '.svg', '.webp'],
    '文档': ['.pdf', '.docx', '.doc', '.xlsx', '.pptx', '.txt', '.md'],
    '压缩包': ['.zip', '.rar', '.7z', '.tar', '.gz'],
    '代码与脚本': ['.py', '.json', '.html', '.css', '.js', '.sql'],
    '安装程序': ['.dmg', '.exe', '.pkg', '.msi', '.deb']
}

def get_safe_destination(target_dir, filename):
    # 检查目标路径是否已存在同名文件,若存在则追加递增序号:file(1).pdf
    target_path = target_dir / filename
    if not target_path.exists():
        return target_path

    stem = target_path.stem
    suffix = target_path.suffix
    counter = 1
    while True:
        new_name = f"{stem}({counter}){suffix}"
        candidate_path = target_dir / new_name
        if not candidate_path.exists():
            return candidate_path
        counter += 1

def organize_directory(source_folder):
    source_path = Path(source_folder).resolve()
    if not source_path.exists() or not source_path.is_dir():
        print(f"[!] 指定源目录无效: {source_folder}")
        return

    print(f"[*] 开始整理目录: {source_path}")
    moved_count = 0
    skipped_count = 0

    # 收集当前规则建立的所有目标文件夹名称,防止把分类目录本身作为待移动文件
    managed_folder_names = set(CATEGORY_MAP.keys()) | {'其他分类'}

    # 遍历当前目录下的所有第一级条目
    for item in source_path.iterdir():
        # 1. 严格过滤:跳过子目录与系统隐藏文件(以.开头)
        if item.is_dir() or item.name.startswith('.'):
            continue

        # 2. 避免误移动归档目标同名项
        if item.name in managed_folder_names:
            continue

        # 3. 匹配扩展名归属类别
        ext = item.suffix.lower()
        matched_category = '其他分类'
        for category, extensions in CATEGORY_MAP.items():
            if ext in extensions:
                matched_category = category
                break

        # 4. 创建目标分类子目录
        dest_dir = source_path / matched_category
        dest_dir.mkdir(exist_ok=True)

        # 5. 计算安全落盘路径并执行移动
        dest_file_path = get_safe_destination(dest_dir, item.name)
        try:
            shutil.move(str(item), str(dest_file_path))
            print(f"[+] 移动: {item.name} -> {matched_category}/{dest_file_path.name}")
            moved_count += 1
        except Exception as err:
            print(f"[!] 移动文件失败 {item.name}: {err}")
            skipped_count += 1

    print(f"\n[*] 整理完成!成功归档: {moved_count} 个文件,跳过/异常: {skipped_count} 个条目")

if __name__ == '__main__':
    # 示例运行:可替换为实际路径,如 Path.home() / 'Downloads'
    test_dir = Path('./demo_downloads')
    test_dir.mkdir(exist_ok=True)

    # 模拟生成几个测试待分类文件
    (test_dir / 'annual_report.pdf').touch()
    (test_dir / 'avatar.png').touch()
    (test_dir / 'backup_2024.zip').touch()

organize_directory(test_dir)- 不要使用
os.rename替代shutil.move:在 Windows 系统下,如果跨磁盘分区移动文件(例如从 C 盘移动到 D 盘),os.rename会抛出OSError: [WinError 17] 系统无法将文件移到不同的磁盘驱动器。而shutil.move会在跨卷时自动退化为“先复制再删除原文件”,保证跨平台一致性。 - 文件正被占用导致
PermissionError:如果某个 PDF 或 Office 文档正被阅读软件打开,移动时会抛出权限拒绝。在实际脚本中应把shutil.move放入try-except保护块中,打印警告并跳过,防止因单个文件被锁导致整个脚本崩溃中断。
五、三大方向对比与初学者渐进实践建议
为了帮助读者根据自己的实际痛点选择最适合的第一站,下表对网络爬虫、数据分析与自动化脚本进行了多维度横向对比:
| 项目方向 | 首要核心库 | 典型输入输出 | 初学者成就感来源 | 最容易卡壳的地方 |
|---|---|---|---|---|
| 网络爬虫 | requests, bs4 |
目标网页 URL → 本地 CSV / JSON | 将互联网上的海量信息自动抓取到本地表格 | HTTP 403 拦截、中文乱码、JS 动态页面 |
| 数据分析 | pandas |
杂乱多源表格 → 结构化透视报表 | 几行代码取代在 Excel 中几小时的手动汇总 | 数据类型不匹配、索引错位、空值处理 |
| 自动化脚本 | pathlib, shutil |
无序混乱目录 → 规整分类归档 | 直接接管并解决身边日常繁琐的机械电脑操作 | 重名文件覆盖覆盖、文件锁定、死循环遍历 |
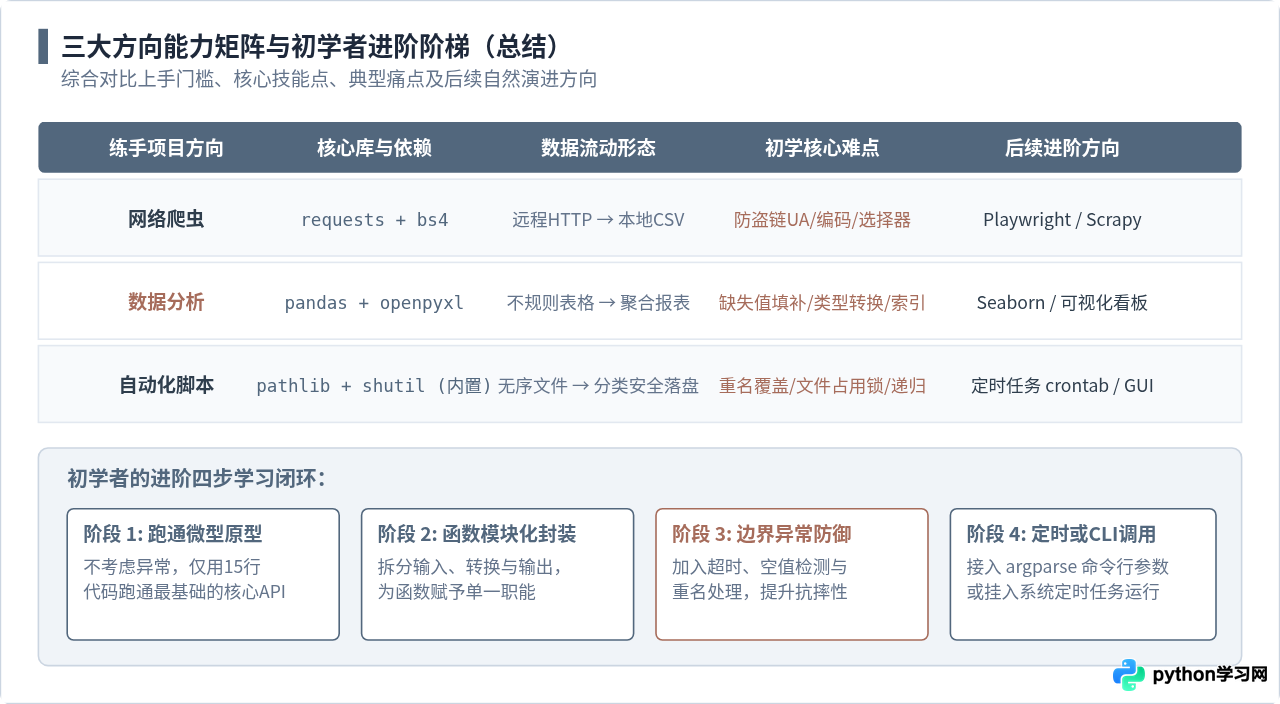
最后,给准备开始动手的初学者三条非常朴素但关键的建议:
- 先跑通 10 行以内的微型原型,再逐步完善:不要一开始就试图写出支持几十种参数的完美程序。先用最粗暴的代码把单条数据抓下来、或者把单个文件挪过去,验证核心逻辑可行后,再逐步重构成函数并补充异常处理。
- 善用打印语句(print)观察变量类型与形态:初学阶段遇到的绝大多数莫名其妙的报错,根源都是“你以为这个变量是个列表,实际上它是一个字典”或“你以为金额是个数字,其实它是带空格的字符串”。在关键步骤之后打印
type(var)和内容,比反复重读语法书管用得多。 - 解决身边真实存在的问题:最能激发编程动力的项目,往往是那些能为你自己省下半小时机械劳动的脚本。把本文提供的示例代码作为骨架,替换成你常去的网站、你自己上个月的账单、或者你自己的桌面文件夹,运行并看到真实改变的那一刻,你就已经真正迈过了初学者的门槛。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















