


Python类使用__slots__大幅降低实例内存占用的方法

在Python中大规模创建同类对象时,默认会为每个实例分配独立的字典结构,导致显著的内存开销。通过在类定义中添加__slots__声明固定属性列表,可替换字典存储机制,实现内存的大幅缩减。本文详细说明该技术的实现步骤、适用场景及代码维护的注意事项。
理解默认内存管理机制
Python 默认采用动态特性,允许在运行时为任意对象实例动态添加或删除属性。底层实现上,解释器会为每个实例分配一个 __dict__ 字典来存储这些键值对。这种设计带来了极高的灵活性,但当需要同时存活数百万个轻量级对象时,字典结构的额外开销会迅速累积成庞大的内存负担。
使用__slots__进行内存优化的操作步骤
第1步:定位高频创建的普通类
扫描项目中频繁实例化的数据容器或模型类。以常见的资源类为例,业务场景中可能一次性加载并缓存约一百万个类似如下的实例:
class Image(object):
    def __init__(self, id, caption, url):
        self.id = id
        self.caption = caption
        self.url = url
        # _setup() 等其他初始化逻辑
第2步:添加__slots__声明固定字段
确认该类属性结构固定后,直接在类作用域下声明 __slots__ 列表。此时 Python 不再为实例创建 __dict__,而是预先分配仅包含指定属性的连续空间:
class Image(object):
    __slots__ = ['id', 'caption', 'url']

    def __init__(self, id, caption, url):
        self.id = id
        self.caption = caption
        self.url = url
        # _setup() 等其他初始化逻辑
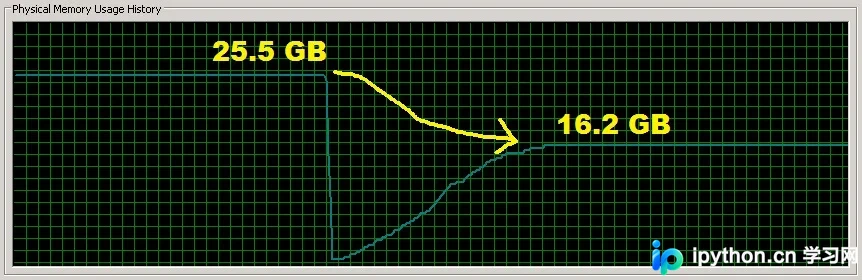
修改代码后重新部署,由于去除了冗余字典指针与哈希表结构,单个实例的内存占用会明显下降。当实例数量达到数十万甚至百万级时,整体进程的内存水位将出现质的改变。以下为某服务进程在应用该优化前后的内存监控对比截图(单进程内存基准约为 6GB):
替代方案与兼容性注意事项
对于仅需读写的不可变数据集合,collections.namedtuple 是另一种轻量选择。它基于元组构建,内存紧凑且支持字段命名访问,但其类继承语义与常规面向对象开发习惯存在差异,若需自定义初始化流程则必须重载 __new__ 而非 __init__。
引入 __slots__ 优化需权衡以下风险:
- 代码维护成本:属性名需在
__slots__和__init__赋值处重复声明,违背单一职责原则(DRY)。部分开发者认为这相当于隐式文档,便于后期维护,但团队更倾向于避免双重定义。 - 动态扩展限制:声明了
__slots__的实例将无法动态绑定未在列表中定义的属性。若项目依赖动态挂载配置项或某些框架的反射机制,需提前评估兼容性。 - 适用阈值:该优化具有规模效应。仅数千个实例时节省的微薄内存不足以抵消调试复杂度,建议仅在确认存在百万级常驻对象且有明确内存瓶颈时启用。
总结
利用 Python 的 __slots__ 机制切断实例字典分配,是应对海量轻量对象内存膨胀的高效手段。配合合理的架构规划与严格的字段定义管理,可在不牺牲运行效率的前提下显著压低资源水位。以上就是使用__slots__优化Python实例内存占用的详细内容,更多关于Python性能调优的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















