


C#高性能敏感词过滤:基于字典树优化的实现

发布时间:2026-10-13 |
2人浏览过
面对海量文本内容的合规性检查,传统的字符串替换往往导致性能低下。本文将深入探讨如何利用C#特性,通过自定义字典结构与精准匹配算法,实现高效、低损耗的敏感词过滤功能。
背景与核心思路
在涉及AIGC、论坛审核或用户生成内容(UGC)的场景中,敏感词过滤是基础但关键的一环。简单的正则表达式虽然编写容易,但在处理长列表词汇时效率极低;而多次调用string.Replace不仅难以兼顾不同长度的词汇,还会造成大量的内存分配。
理想的解决方案应具备以下特征:
- 单次遍历:不重复扫描文本
- 精准定位:避免错误截断
- 灵活扩展:支持动态词库更新
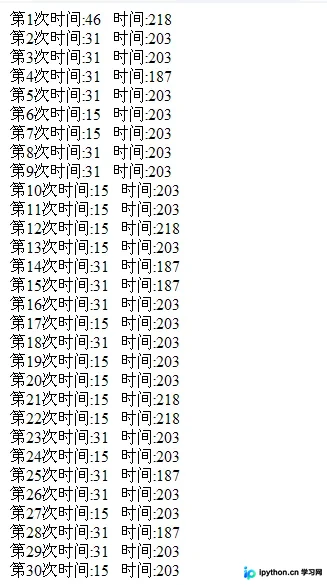
以下是某次压力测试的表现,展示该方法在处理110多KB文本时的优异性能对比(单位:秒):
准备条件与数据结构
要实现上述目标,我们需要建立一套映射机制。核心在于利用哈希表存储所有敏感词的初始字符,并在后续匹配中快速缩小搜索范围。
第1步:初始化字典结构
目的:将扁平的词组列表转化为可快速检索的多级索引。
- 入口参数:包含多个敏感词的字符串数组(以
|分隔)。 - 核心逻辑:
定义一个DicList字典,键为字符char,值为该字符开头的词组列表List<string>。遍历时提取每个词的头部作为Key。 - 动作说明:
System.Text.StringBuilder sb = new System.Text.StringBuilder(text.Length);
string filterText = "需要过滤的脏字 以|分开";
string[] filterData = filterText.Split('|');
foreach (var item in filterData)
{
    char value = item[0];
    if (dicList.ContainsKey(value))
        dicList[value].Add(item);
    else
        dicList.Add(value, new List() { item });
}
第2步:执行逐字比对算法
目的:根据当前字符是否在字典中,决定是否进行后续匹配。
- 操作:遍历输入文本
text的每一个字符索引i。 - 分支判断:
1. 如果text[i]不在字典表中,直接原样追加到结果中。
2. 如果在字典表中,则获取该字符对应的所有候选词,并按Length升序排列。这是为了优先匹配最短的词汇,减少不必要的截取尝试。 - 验证流程:
int count = text.Length;
for (int i = 0; i < count; i++)
{
    char word = text[i];
    if (dicList.ContainsKey(word))
    {
        int num = 0; // 是否找到匹配的关键字
        var data = dicList[word].OrderBy(g => g.Length);

        foreach (var wordbook in data)
        {
            if (i + wordbook.Length <= count) // 边界检查防止越界
            {
                string result = text.Substring(i, wordbook.Length);
                if (result == wordbook)
                {
                    num = 1;
                    sb.Append(GetString(result)); // 替换为星号等占位符
                    i = i + wordbook.Length - 1; // 跳过已匹配的字符
                    break; // 匹配成功立即跳出内层循环
                }
            }
        }
        if (num == 0) sb.Append(word); // 未匹配成功,追加原字符
    }
    else
    {
        sb.Append(word); // 字典外字符直接追加
    }
}
return sb.ToString();
完成判断与注意事项
当遍历结束并返回新的字符串后,即完成了过滤工作。在实际应用中需注意:
- 性能评估:该方法通过牺牲一定的内存建立字典,换取了CPU计算的高效,在处理万级词汇时优势明显。
- 替换策略:示例中使用了GetString()函数将敏感词全部替换为*,也可根据需要改为留空或保留首尾字符。请确保在处理过程中做好数据备份,避免意外覆盖原始日志。
以上就是C#基于字典优化的敏感词过滤实现的详细内容,更多关于C#程序设计与内容安全的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















