


C# 实现双向链表 DbLinkList 详解

本文深入讲解 C# 中双向链表(DbLinkList)的完整实现机制。相比单链表,双向链表通过引入前驱指针(Prev),显著提升了特定场景下的遍历与定位效率。
结果与目标
构建一个支持泛型的双向链表结构 DbLinkList<T>。该结构需包含完整的增删改查功能,并利用 Prev 指针实现从尾向前的反向遍历,从而解决单链表无法直接访问前驱节点的问题。
准备条件
需要基础的 C# 编程能力,了解泛型类与接口 IListDS<T> 的基本定义。开发环境支持标准 .NET 框架即可。
真实操作顺序
第1步:定义节点 DbNode<T>
目的:建立链表的原子单元,同时存储数据及前后节点的引用。
动作:创建泛型类 DbNode<T>,包含三个私有字段:data(存储值)、next(指向后驱)、prev(指向前驱)。提供多个构造函数以支持灵活初始化(如仅指定数据、或指定前后节点),并封装对应的属性供外部访问。
namespace 线性表
{
  public class DbNode<T>
  {
    private T data;
    private DbNode<T> prev;
    private DbNode<T> next;

    // 提供多种构造函数以便不同场景下实例化
    public DbNode(T data) { /* ... */ }
    // 省略其他重载构造函数

    public T Data { get; set; }
    public DbNode<T> Prev { get; set; }
    public DbNode<T> Next { get; set; }
  }
}
第2步:实现链表主体 DbLinkList<T>
目的:管理链表状态,暴露公共操作方法。
动作:实现 DbLinkList<T> 类,继承自 IListDS<T>。维护一个 head 引用指向首节点。核心方法包括:
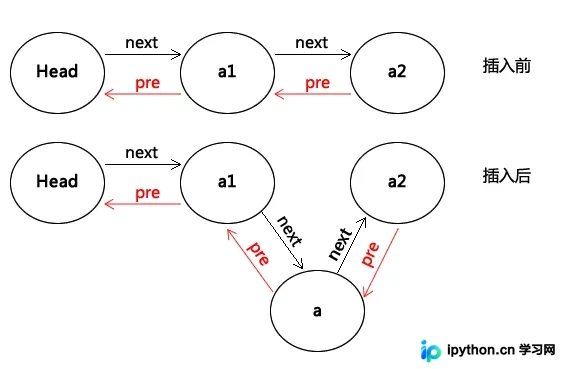
Append(T item):在链表末尾追加元素。需注意将新节点的前驱指向原尾节点。InsertBefore(T item, int i):在第i个位置前插入。处理头插法时需更新head指针;处理中间插入时需调整相邻节点的Next和Prev交叉指向。RemoveAt(int i):移除指定位置节点。若移除的是首节点,需更新head;若为中间节点,需将前驱节点的Next指向后继节点,同时确保后继节点的Prev指向正确(若存在后继)。
第3步:插入与删除逻辑的核心实现
目的:确保指针链接不断裂,维持双向结构的完整性。
入口:任意修改链表结构的方法。
重要参数:目标索引 i、数据对象 item。
操作细节:以 InsertBefore 为例,在找到插入点 d(前驱)和目标位置 n(原节点)后,新建节点 q。执行以下链接重建:
d.Next = qq.Prev = dq.Next = nn.Prev = q
同理,RemoveAt 删除节点 p 时,连接其前驱 q 与后继 p.Next,并更新后继(若不为空)的 Prev 指向 q。
第4步:其他功能增强
目的:完善链表工具性。
动作:实现以下辅助方法:
GetItemAt(int i)/ 索引器:遍历查找指定索引数据。IndexOf(T value):正向遍历查找值首次出现的索引。Reverse():创建新链表或将当前链表反向。实现逻辑是从头遍历原节点,逐个前插到新结构中,最后替换head指针。TestPrevErgodic():利用Prev指针从尾部向前遍历,验证双链表的反向访问能力。
完成判断
通过编写测试代码验证功能的正确性。创建一个字符串类型的双向链表,依次执行头插、尾插、随机插入、删除、反转等操作。检查打印输出是否符合预期顺序,特别是使用 TestPrevErgodic 能否正确输出反向序列,以及 IndexOf 返回值是否正确。
测试与排错
操作:运行典型测试用例。
DbLinkList<string> dblink = new DbLinkList<string>();
dblink.InsertBefore("v", 0);
dblink.Append("y");
Console.WriteLine(dblink.ToString()); // 输出: v,y
// 测试反转
dblink.Reverse();
Console.WriteLine(dblink.ToString()); // 输出: y,v
// 测试反向遍历
Console.WriteLine(dblink.TestPrevErgodic()); // 输出: v,y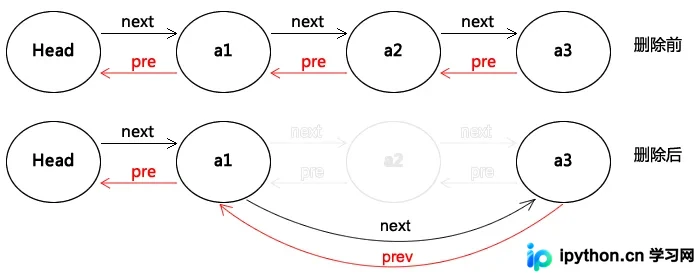
常见问题:
- NullReferenceException:在插入或删除节点时,未判断相邻节点是否为空(例如删除最后一个节点时,其后继为 null,不可执行
p.Next.Prev)。 - 边界处理:在头部插入或删除时,记得更新全局
head指针,否则后续遍历将从旧的首节点开始,导致数据丢失或逻辑错误。 - 空列表操作:对空链表进行
GetItemAt或RemoveAt时应先检查IsEmpty()。
性能优势与应用建议
双链表的最大优势在于支持双向遍历。在单链表中,若要获取某节点的前驱,必须从头再次遍历,时间复杂度为 O(n)。而在双链表中,只需通过 node.Prev 即可直接获取,时间复杂度降至 O(1)。
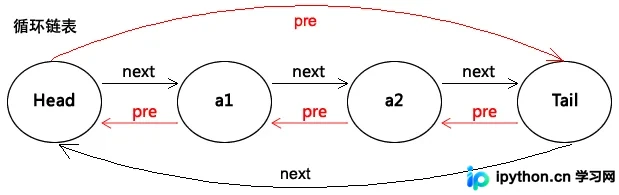
此外,若进一步将首尾相连形成循环双向链表(Head.Prev = Tail, Tail.Next = Head),可优化查找策略:当搜索前半部分元素时从 Head 向后找,后半部分从 Tail 向前找,进一步缩短平均搜索路径。
虽然手动实现有助于理解底层原理,但在实际 .NET 项目开发中,微软已提供了高性能且经过充分优化的内置实现 System.Collections.Generic.LinkedList<T>。建议开发者在学习完上述原理后,优先直接使用系统内置链表以保证稳定性与维护性。
以上就是C#实现双向链表 DbLinkList 的详细内容,更多关于C# 数据结构算法的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















