


MySQL索引原理与实战:B+树优化、最左前缀与key_len分析

MySQL的性能核心在于存储引擎与索引的设计。本文以InnoDB引擎为例,剖析B+树索引的数据组织方式,重点讲解复合索引的最左前缀匹配法则、排序约束及哈希索引的特性。同时,通过explain输出的key_len字段反推索引使用情况,帮助开发者构建高效的数据检索方案。
B+树索引结构与数据存放
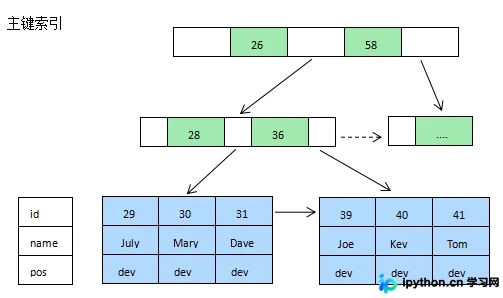
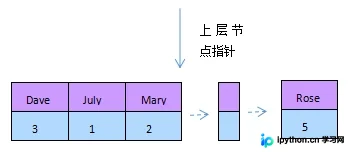
MySQL的默认存储引擎是InnoDB,其索引实现基于B+树(文中统称为BTREE)。与MyISAM将索引和数据分离不同,InnoDB的表数据文件本身就是索引文件(聚簇索引),叶子节点直接存放完整的数据行记录;而MyISAM的索引叶子节点仅指向数据行的物理地址。
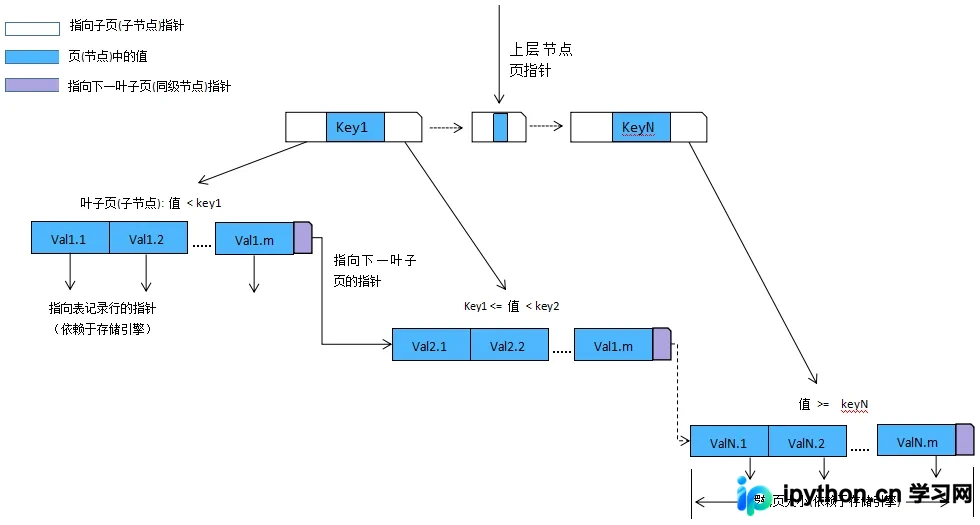
B+树的非叶子节点仅存储键值(Key)用于导航,不包含具体数据。所有的键值按升序排列,且同一层的节点通过指针相连,这使得范围查询非常高效。查找时,通过二分法在树层间定位,最终在叶子节点进行精确或范围匹配。
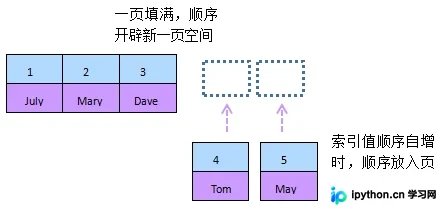
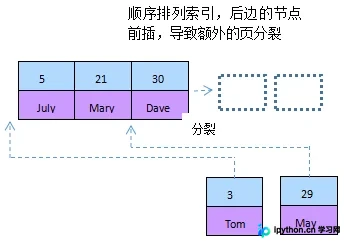
InnoDB的页(Page)是存储的基本单位,默认大小为16KB。当一页的数据写满(达到分裂因子,通常为15/16容量)时,会触发“页分裂”操作,开辟新页。为了减少页分裂带来的性能损耗,建议主键采用自增整数。若使用无序字符串(如UUID或MD5)作为主键,插入时的随机性会导致频繁的数据页重排和碎片产生。
聚簇索引与辅助索引的区别
InnoDB主要维护两类索引:
- 聚簇索引(Clustered Index):即主键索引。它将行数据与索引结构紧密绑定,表中只能有一个聚簇索引。插入和更新数据时高度依赖主键的顺序性。
- 辅助索引(Secondary Index):在非主键列上建立的索引。其叶子节点存储的是该列的值 + 对应的主键ID。查询时需要先查辅助索引找到主键,再拿着主键去聚簇索引中查取完整数据,这就是“回表”过程。
复合索引的使用原则:最左前缀匹配
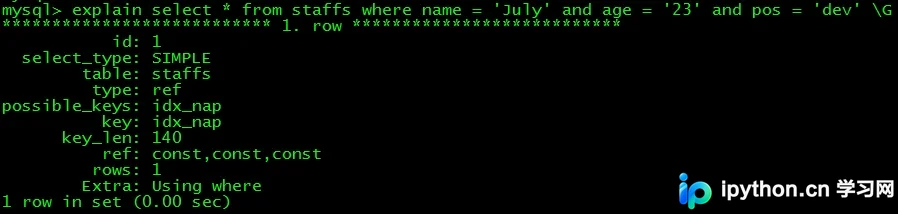
对于复合索引 (A, B, C),MySQL遵循最左前缀原则。以下示例以 staffs (name, age, pos) 表的索引 idx_nap(name, age, pos) 进行分析:
第1步:全值匹配
查询条件包含索引所有列,效率最高。例如:SELECT * FROM staffs WHERE name = 'July' AND age = 23 AND pos = 'dev'。
第2步:匹配最左前列
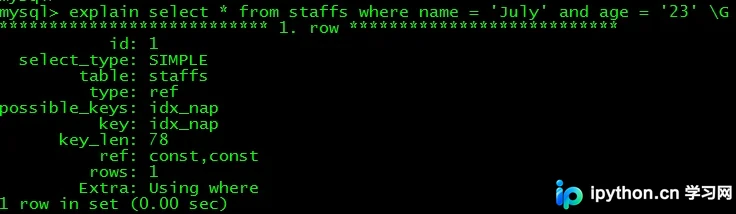
即使不指定所有列,只要从最左侧开始即可命中索引。例如只查 WHERE name = 'July' AND age = 23,此时 key_len 会减小,表明仅使用了前两列。
第3步:匹配列前缀(Prefix Match)
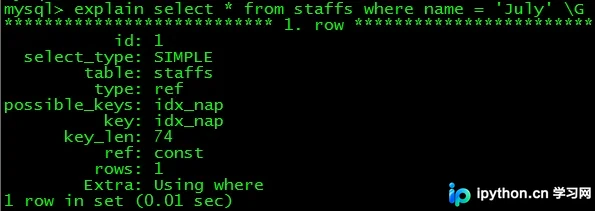
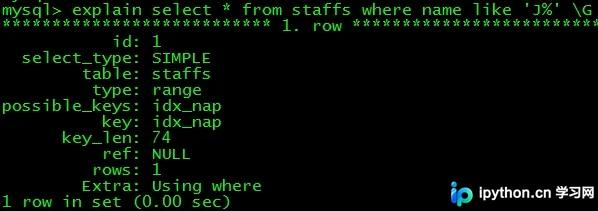
利用字符串类型的特征,仅匹配开头部分。例如 WHERE name LIKE 'J%' 可走索引。但注意,'%Jul' 或 '%Jul%' 等前导模糊匹配无法使用B+树索引加速。
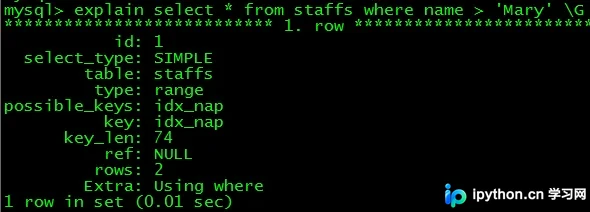
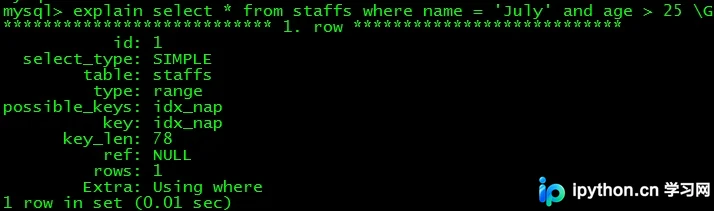
第4步:精确匹配一列并范围匹配右侧相邻列
当查询跨越范围时,范围查询右侧的列将失效。例如 WHERE name = 'July' AND age > 23,此时只用到了 name 和 age 两列,pos 列的索引无法利用。
第5步:只读索引(覆盖索引 Covering Index)
如果查询的列全部包含在辅助索引中,数据库无需回表查聚簇索引,直接从辅助索引获取数据,即“覆盖索引”。此时 EXPLAIN 的结果中 Extra 列显示为 Using index。
select name, age, pos from staffs where name = 'July' and age = 25 and pos = 'dev'
-- Extra: Using index; Using where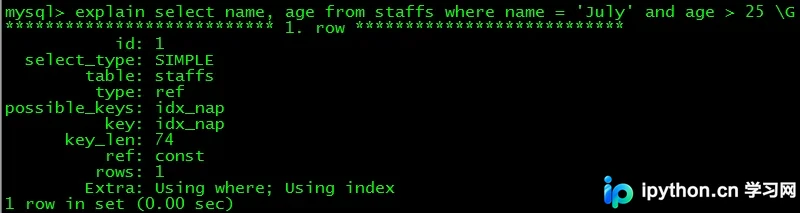
长字符串索引优化:前缀索引
对于 TEXT 或超长 VARCHAR 字段,建立全量索引占用空间大且影响写入性能。可使用前缀索引,仅取字符串前N个字符建立索引。确定N的原则是保证较高的选择性(Selectivity,即:重复值少的比例)。
-- 计算不同长度的选择性
select count(distinct left(a, 7))/count(*) as non_repeat from tab;
添加前缀索引的语法如下:
-- 单列前缀索引
alter table tab add index idx_pn(name(9));
-- 复合前缀索引
alter table tab add index idx_cpn(count, name(9));
哈希索引(Hash Index)与特殊场景
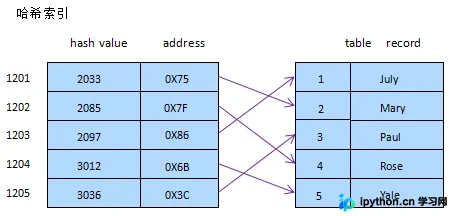
InnoDB原生不主动创建哈希索引,除非使用内存存储引擎Memory或通过自适应哈希索引机制隐式生成。哈希索引通过散列值定位,具有以下特点:
- 速度极快:精确匹配(= 或 IN)仅需一次IO。
- 局限性:
- 不支持范围查询和排序(ORDER BY)。
- 必须匹配所有构成哈希的列。
- 存在碰撞(Collision),冲突时需逐行比对。
调试技巧:explain 与 key_len 分析
在生产环境排查慢查询时,EXPLAIN 命令至关重要。其中 key_len 表示实际使用的索引字节长度,可用于推断是否用到了复合索引的所有列。以下是常见类型的索引长度估算基础(假设 UTF-8 字符集):
- INT:4字节。若有 NOT NULL 标志位加1字节,共5字节。
- BIGINT:8字节。若有标志位共9字节。
- CHAR/NVARCHAR(n):字符数 × 字符集字节数 + 最大长度字节开销(VARCHAR通常多2字节定长标识)。
-- 测试INT类型key_len
create table keyLenTest1(
    id int primary key auto_increment,
    typeKey int default 0 ,
    add_time timestamp not null default current_timestamp
) charset utf8;
alter table keyLenTest1 add index idx_k(typeKey);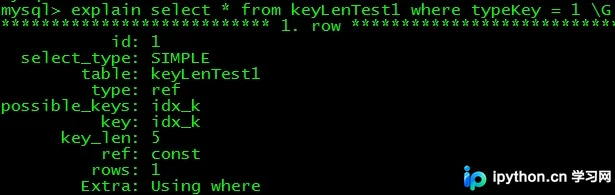
修改为 CHAR 类型后的变化:
-- 改为char型,1个字符
alter table keyLenTest1 modify typeKey char(1);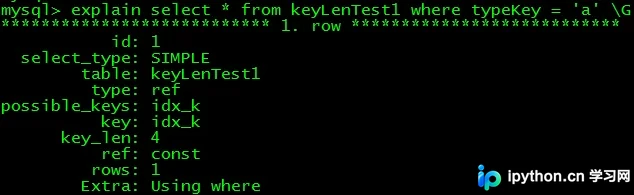
-- 改为char型,2个字符
alter table keyLenTest1 modify typeKey char(2);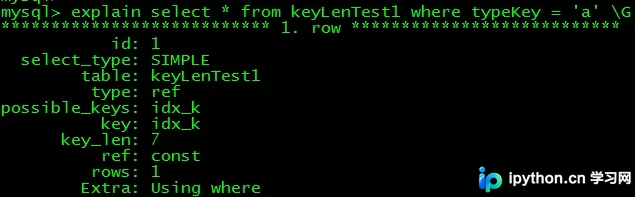
修改为 VARCHAR 类型后的变化:
-- 改为varchar型,1个字符
alter table keyLenTest1 modify typeKey varchar(1);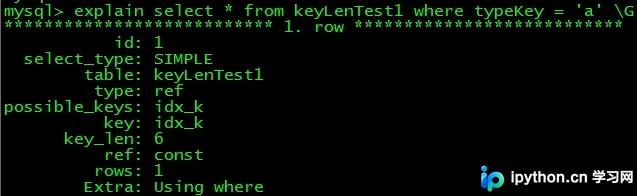
-- 改为varchar型,2个字符
alter table keyLenTest1 modify typeKey varchar(2);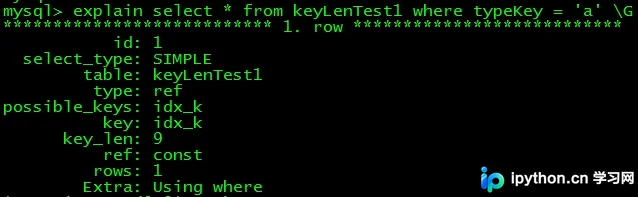
通过分析 key_len 的理论值与实际值的偏差,可以验证SQL语句是否达到了预期的索引效果。此外,若需更深层的性能分析,可配合 SLOW QUERY LOG 和 SHOW PROFILES 进行综合评估。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















