


C# 异步多线程网络爬虫实现原理与核心代码解析

本文详细解析如何利用 C# 构建一个支持并发抓取的网络爬虫程序。文章涵盖 URL 去重管理机制、基于 HttpWebRequest 的异步多线程实现、连接超时处理、数据流分块读取以及页面链接的正则提取与过滤策略,为开发定制化工具提供完整的技术参考。
结果与目标
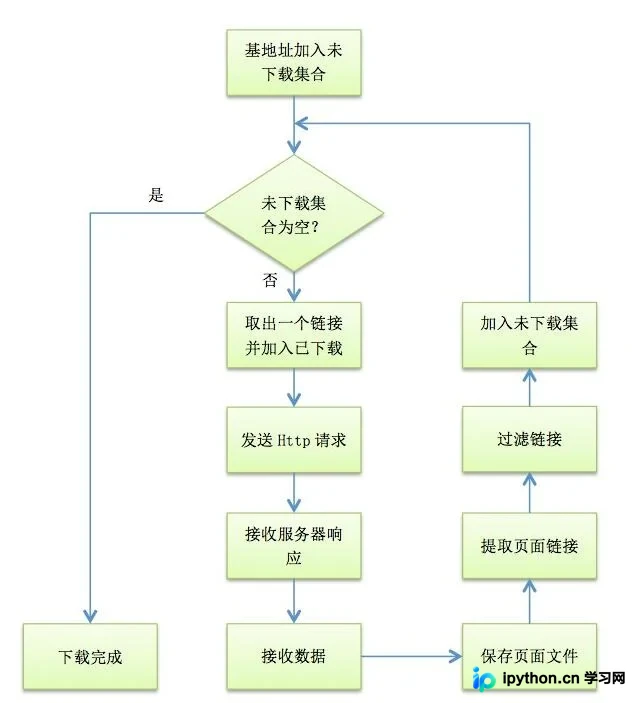
构建一个能够自动遍历指定起始网址及其子链路的下载器。该工具需具备以下能力:
- 支持从单一
RootUrl开始,递归或层级式地获取页面资源。 - 通过异步机制提升多个 URL 同时下载的效率,避免阻塞主线程。
- 有效管理未下载和已下载的 URL 队列,防止死循环与重复抓取。
- 自动识别并存储网页中的相关链接,依据深度限制和类型规则进行过滤。
准备条件
在动手编写代码前,需要明确几个关键概念与组件。
数据结构设计
为了跟踪爬取进度,我们需要维护两个核心集合。由于不仅要保存 URL 字符串,还需记录其相对于初始地址的深度(Depth),推荐使用 Dictionary<string, int> 结构:
- 待下载集合 (Unloaded):存放等待被访问的 URL 及其深度。
- 已下载集合 (Loaded):存放已经处理完毕的 URL,用于去重判断。
并发模型选择
C# 提供了强大的 System.Net.HttpWebRequest 类来处理 HTTP 协议。为了实现非阻塞的高效下载,我们将利用其 Begin/End 异步接口,并结合线程池来模拟多个工作实例,从而实现真正的并发效果。
真实操作顺序
第1步:初始化请求状态与工作实例
首先定义工作实例的状态数组,用于标识哪些线程正在忙于下载。
private bool[] _reqsBusy = null; //每个元素代表一个工作实例是否正在工作
private int _reqCount = 4; //默认开启4个并发工作实例
同时,我们需要一个容器来保存每次请求携带的数据上下文。这里创建一个自定义的 RequestState 类,封装请求对象、URL、深度及内存缓冲:
class RequestState
{
 private const int BUFFER_SIZE = 131072; //每次读取数据包的大小
 private byte[] _data = new byte[BUFFER_SIZE];
 private StringBuilder _sb = new StringBuilder(); //拼接完整的 HTML

 public HttpWebRequest Req { get; private set; }
 public string Url { get; private set; }
 public int Depth { get; private set; }
 public int Index { get; private set; }
 public Stream ResStream { get; set; }
 public StringBuilder Html => _sb;
 public byte[] Data => _data;
 public int BufferSize => BUFFER_SIZE;

 public RequestState(HttpWebRequest req, string url, int depth, int index)
 {
  Req = req;
  Url = url;
  Depth = depth;
  Index = index;
 }
}
第2步:分配任务与发起异步请求
通过轮询空闲的工作实例来调度任务。当有可用实例时,锁定集合取出一个 URL,更新状态标志后发起请求。
private void DispatchWork()
{
 if (_stop) return; //若标记停止,不再分配新任务
 for (int i = 0; i < _reqCount; i++)
 {
  if (!_reqsBusy[i])
  {
   RequestResource(i); //分配给第i个工作实例
  }
 }
}
第3步:执行具体的 HTTP GET 请求
这是核心的网络交互部分。关键在于使用 BeginGetResponse 发起异步调用,并设置回调函数 ReceivedResource 处理响应。同时注册超时回调以防请求挂起。
private void RequestResource(int index)
{
 lock (_locker) //保证多线程访问集合时的线程安全
 {
  if (_urlsUnload.Count <= 0)
  {
   _workingSignals.FinishWorking(index);
   return;
  }

  //标记忙碌,并从队列取出第一个URL
  _reqsBusy[index] = true;
  int depth = _urlsUnload.First().Value;
  string url = _urlsUnload.First().Key;

  _urlsLoaded.Add(url, depth);
  _urlsUnload.Remove(url);
 }

 try
 {
  HttpWebRequest req = (HttpWebRequest)WebRequest.Create(url);
  req.Method = "GET"; //显式指定方法
  req.Accept = "text/html"; //仅接受HTML内容以节省带宽
  req.UserAgent = "CustomSpider/1.0"; //伪装浏览器UA

  RequestState rs = new RequestState(req, url, depth, index);

  //异步请求响应
  var result = req.BeginGetResponse(new AsyncCallback(ReceivedResource), rs);

  //注册超时取消机制
  ThreadPool.RegisterWaitForSingleObject(result.AsyncWaitHandle,
    TimeoutCallback, rs, _maxTime, true);
 }
 catch (WebException we)
 {
  MessageBox.Show("请求失败: " + we.Message);
  _reqsBusy[index] = false;
  DispatchWork(); //失败也尝试调度其他任务
 }
}
如果请求超时,将触发 TimeoutCallback,此时必须中止正在进行的请求并重置实例状态:
private void TimeoutCallback(object state, bool timedOut)
{
 if (timedOut)
 {
  RequestState rs = state as RequestState;
  if (rs != null)
  {
   rs.Req.Abort(); //强制撤销网络请求
   _reqsBusy[rs.Index] = false;
   DispatchWork(); //释放出来的空位立即补上新任务
  }
 }
}
第4步:接收响应数据流
在收到服务器响应后,需要处理可能的错误码(如 404 或 500),确认成功后获取响应流。为了适应大文件,我们不一次性读取所有字节,而是采用分块异步读取的方式。
private void ReceivedResource(IAsyncResult ar)
{
 RequestState rs = (RequestState)ar.AsyncState;
 HttpWebRequest req = rs.Req;
 try
 {
  HttpWebResponse res = (HttpWebResponse)req.EndGetResponse(ar);
  if (res.StatusCode == HttpStatusCode.OK)
  {
   Stream resStream = res.GetResponseStream();
   rs.ResStream = resStream;

   //开始分块读取数据
   resStream.BeginRead(rs.Data, 0, rs.BufferSize,
     new AsyncCallback(ReceivedData), rs);
  }
  else
  {
   HandleFailedRequest(rs);
  }
 }
 catch(Exception ex)
 {
  Console.WriteLine($"处理响应出错: {ex.Message}");
  HandleFailedRequest(rs);
 }
}

private void HandleFailedRequest(RequestState rs)
{
 rs.Req.Abort();
 _reqsBusy[rs.Index] = false;
 DispatchWork();
}
第5步:分块读取与缓存拼接
ReceivedData 是接收数据的真正位置。只要读取到的字节数大于 0,就说明还有剩余数据,应继续发起下一次读取请求;直到读取数为 0 表示数据接收结束。
private void ReceivedData(IAsyncResult ar)
{
 RequestState rs = (RequestState)ar.AsyncState;
 Stream resStream = rs.ResStream;
 int read;

 try
 {
  read = resStream.EndRead(ar);

  if (read > 0)
  {
   MemoryStream ms = new MemoryStream(rs.Data, 0, read);
   using(StreamReader reader = new StreamReader(ms, Encoding.UTF8))
   {
    string content = reader.ReadToEnd();
    rs.Html.Append(content); //追加内容
   }

   //继续读取下一块数据
   resStream.BeginRead(rs.Data, 0, rs.BufferSize,
     new AsyncCallback(ReceivedData), rs);
  }
  else
  {
   //所有数据读取完毕,进入业务处理阶段
   ProcessCompletedPage(rs);
  }
 }
 catch(Exception e)
 {
  Console.WriteLine(e.ToString());
  _reqsBusy[rs.Index] = false;
  DispatchWork();
 }
}
第6步:链接提取与队列入队
当单个页面的全部数据拼接完成(ProcessCompletedPage 中),先将其保存至本地文件。接着使用正则表达式从 HTML 中提取所有符合条件的超链接。
private string[] GetLinks(string html)
{
 //匹配常见URL格式,忽略大小写
 const string pattern = @"http://([\w-]+\.)+[\w-]+(/[\w- ./?%&=]*)?";
 Regex r = new Regex(pattern, RegexOptions.IgnoreCase);
 MatchCollection matches = r.Matches(html);
 return matches.Select(m => m.Value).ToArray();
}
拿到链接数组后,需要经过严格的过滤才能加入 _urlsUnload 队列,避免抓取图片/CSS等非文本资源或深度过深的内容:
private void AddUrls(string[] links, int currentDepth)
{
 if (currentDepth >= _maxDepth) return; //超过最大深度不再抓取

 foreach (var link in links)
 {
  string cleanUrl = link.Trim();
  if (!UrlAvailable(cleanUrl)) continue; //跳过已存在或非法类型的链接

  //检查是否为当前站点内部的链接
  if (cleanUrl.Contains(_baseUrl))
  {
   _urlsUnload.Add(cleanUrl, currentDepth + 1);
  }
 }
}

private bool UrlAvailable(string url)
{
 if (_urlsLoaded.ContainsKey(url) || _urlsUnload.ContainsKey(url))
  return false;
 //过滤常见静态资源后缀
 if (url.EndsWith(".jpg") || url.EndsWith(".png") ||
     url.EndsWith(".css") || url.EndsWith(".js"))
  return false;
 return true;
}
完成判断
任务的最终结束依赖于工作状态的汇总。程序启动时会创建一个定时器(如每 300ms 一次),检测是否所有工作实例都处于空闲且没有新的 URL 可供抓取的状态:
private void CheckFinish(object param)
{
 bool allFinished = _workingSignals.IsFinished();
 if (allFinished && _urlsUnload.Count == 0)
 {
  _checkTimer.Dispose();
  DownloadFinish?.Invoke(0); //触发完成事件
 }
}
简要总结
以上就是利用 C# 结合 HttpWebRequest 异步 API 实现高并发网络爬虫的详细内容。通过状态机控制、分块流式读取与正则过滤,可以有效应对基本的 Web 信息采集需求。更多关于 C# 高级网络编程的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















