


Python结合点密度过滤与OCR的验证码识别实践

针对含干扰曲线的简单文本验证码,利用Python进行点密度过滤与OCR识别是一种可行的基础方案。本文详细拆解从环境搭建、图像去噪到字符提取的全流程,帮助开发者掌握验证码识别的核心逻辑与实操步骤。
验证码预处理思路与目标
面对带有曲线干扰的验证码图片,首要任务是分离字符主体与背景噪声。常见的处理方向包括特征匹配、字典映射或直接调用OCR模块,但无论采用何种识别策略,均需在前期对图片进行针对性清洗。以下述原始样本为例,干扰线主要呈现为贯穿画面的连续曲线:
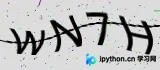
尝试追踪单像素法虽能定位曲线走向,但容易误伤字符笔画,导致轮廓断裂。更为稳定的策略是引入局部点密度阈值:将图像划分为固定尺寸的网格,统计每个单元格内的黑点数量,低于设定阈值的区域判定为稀疏的干扰线并将其置白,高于阈值的区域则保留为密集的字符主体。
准备基础依赖库与OCR引擎
本方案依赖图像操作库PIL、OCR封装库pytesser以及底层引擎Tesseract。按顺序完成以下配置即可进入编码阶段:
- 安装PIL:获取官方版本的PIL库以支持图像打开、裁剪与像素级访问。
- 配置pytesser:下载解压后,将其主目录置于Py脚本同级路径下,确保能被系统正常导入。
- 部署Tesseract数据文件:下载Tesseract OCR Engine,提取其中的
tessdata 文件夹,完整替换掉pytesser目录下的同名子目录,以保证字库匹配准确。
实施点密度过滤去除干扰曲线
确定环境无误后,编写密度过滤函数。算法核心逻辑为遍历图像的X/Y轴,每次截取5×5像素的小矩形区域,统计其中非白色像素(值为255以外的值)的个数。若计数小于临界值11,则该区域整体填充为白色背景,从而擦除细碎的干扰线:
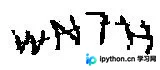
经过该步骤处理后,画面仅剩高对比度的独立字符结构,大幅降低了后续OCR引擎的误判率。实际应用中,可根据验证码字体粗细微调网格大小(如改为4×4)或密度阈值(如改为8~15之间)。
配置对比度增强并调用OCR识别
去噪完成后,需进一步优化图像质量以适配OCR解析器。依次执行以下标准化流程:
- 中值滤波:使用MedianFilter平滑孤立噪点,防止字符粘连或断裂。
- 对比度拉伸:将Contrast参数提升至2倍,强化黑白边界。
- 灰度二值化:调用convert("1")强制转换为单色位图,符合传统OCR输入规范。
- 导出并识别:保存为.tif格式供pytesser调用,输出最终识别字符串。
完整处理脚本与运行逻辑
以下为整合了密度计算、图像增强与OCR调用的完整核心代码。已对旧版语法中的拼写偏差进行修正,可直接在Python 3环境下配合对应库运行:
#encoding=utf-8
from PIL import Image, ImageEnhance, ImageFilter
import sys
from pytesser import *

def numpoint(im):
    """计算图像中非白色像素的总数"""
    w, h = im.size
    data = list(im.getdata())
    return sum(1 for p in data if p != 255)

def point_density_filter(im, grid_size=5, threshold=11):
    """基于点密度的5x5网格去干扰算法"""
    w, h = im.size
    for y in range(0, h, grid_size):
        for x in range(0, w, grid_size):
            box = (x, y, x + grid_size, y + grid_size)
            crop_region = im.crop(box)
            count = numpoint(crop_region)
            if count < threshold:
                # 将该网格区域全部刷白
                for dy in range(y, min(y + grid_size, h)):
                    for dx in range(x, min(x + grid_size, w)):
                        im.putpixel((dx, dy), 255)
    im.save(r'filtered_captcha.jpg')

def run_ocr():
    """图像增强并执行OCR识别"""
    img_path = "filtered_captcha.jpg"
    im = Image.open(img_path)
    # 平滑与对比度提升
    im = im.filter(ImageFilter.MedianFilter())
    enhancer = ImageEnhance.Contrast(im)
    im = enhancer.enhance(2)
    # 转黑白二值图
    im = im.convert('1')
    im.save("ocr_input.tif")
    print(image_file_to_string("ocr_input.tif"))

if __name__ == '__main__':
    original = Image.open("captcha.png")
    point_density_filter(original)
    run_ocr()
识别精度分析与常见问题排查
受限于原始字体的不规则扭曲程度,该方案的端到端识别率通常处于中等水平。若在实际测试中出现乱码或空结果,可按以下顺序核查:
- 字库错位:确认
tessdata 是否完整且版本与引擎匹配,缺失简体中文字模将导致全字母集乱码。 - 阈值未覆盖特殊样式:部分验证码干扰线较粗或字符极细,需调整density_threshold参数,并通过打印中间状态图验证分割效果。
- 滤镜过度平滑:MedianFilter可能模糊短笔画,可降级为GaussianFilter或暂时跳过此步观察OCR反馈。
总结
利用Python结合点密度过滤与轻量级OCR引擎,能够构建一套低门槛的验证码自动识别流水线。虽然对于高对抗性变形字体仍需引入深度学习或模板库替代方案,但该流程已具备处理常规静态图文验证的基础能力,可作为自动化测试与数据采集模块的快速原型参考。以上就是Python结合点密度过滤与OCR验证码识别实践的详细内容,更多关于验证码自动识别与图像预处理的技术资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















