


MySQL数据库性能优化:索引原理、创建与存储引擎选择

在MySQL数据库中,索引是提升查询速度最经济的手段,但需权衡读写代价。本文旨在解决如何合理建立索引、理解其底层原理、正确应用各类索引类型(如复合索引、全文索引),以及如何根据业务场景选择合适的存储引擎。通过掌握最左前缀匹配、避免索引失效场景及执行批量优化策略,可显著降低I/O开销,提升系统整体响应能力。
索引原理与适用场景
索引的本质是排好序的数据结构,通常基于B+树实现。其算法复杂度为 log2N,能够以极少的磁盘I/O次数定位数据。虽然建立索引无需修改程序或调整SQL语句即可大幅提升读性能,但它是以牺牲写操作(INSERT、UPDATE、DELETE)效率和增加磁盘占用为代价的。
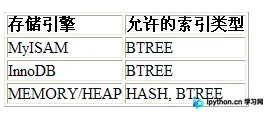
第1步:评估是否适合添加索引
目的:识别高价值索引字段,避免无效索引消耗资源。
判断标准:
- 高频查询条件:频繁作为WHERE子句条件的字段应创建索引。例如:
select * from emp where empno = 1; - 低基数不建索引:唯一性极差的字段(如性别)即使频繁查询也不宜单独建索引,全表扫描可能更快。
- 高频更新不建索引:如计数器字段(logincount),每次更新都需维护索引树,得不偿失。
- 非必要不建索引:不出现在WHERE、JOIN或ORDER BY中的字段不应创建索引。
第2步:理解索引类型及其区别
入口:在建表或修改表结构时选择。
动作:根据需求选择以下四种索引类型之一:
- 主键索引 (PRIMARY):自动创建在自增ID或主键上,唯一且非空,聚簇索引(InnoDB中数据存在索引节点中)。
- 唯一索引 (UNIQUE):允许NULL值,但值必须唯一。适用于邮箱、手机号等唯一标识。
- 普通索引 (INDEX):最基本的索引,无任何限制,仅用于加速查询。
- 全文索引 (FULLTEXT):专为文本检索设计,主要支持MyISAM和InnoDB(5.6+)。注意:MyISAM下的中文全文索引效果不佳,通常需结合Sphinx/Coreseek或使用InnoDB的FTS功能。
第3步:创建与维护索引的操作流程
目的:规范索引的创建、删除与查看,确保索引有效。
重要参数:索引名、列名、长度(前缀索引)、ASC/DESC。
1. 创建索引
-- 在现有表中添加普通索引
ALTER TABLE table_name ADD INDEX index_name (col_name);

-- 创建唯一索引
CREATE UNIQUE INDEX index_name ON tbl_name (col_name [(length)] [ASC | DESC]);

-- 添加主键(若尚未设置)
ALTER TABLE table_name ADD PRIMARY KEY (column_list);
2. 删除索引
-- 删除普通索引
DROP INDEX index_name ON tbl_name;
ALTER TABLE table_name DROP INDEX index_name;

-- 删除主键
ALTER TABLE table_name DROP PRIMARY KEY;
3. 查看索引状态
SHOW INDEX FROM table_name;
SHOW KEYS FROM table_name;
DESC table_Name;
索引的高级应用与避坑指南
建立索引只是第一步,正确使用才能发挥其威力。以下场景决定了索引能否被优化器选中。
第4步:复合索引的最左前缀原则
背景:复合索引是多列的组合,遵循“最左前缀”匹配规则。
演示环境:假设表 dept 上有复合索引 (dname, loc)。
-- 创建复合索引
alter table dept add index myind (dname, loc);

-- 测试1:使用第一列 dname,索引生效
explain select * from dept where dname='研发部';
-- 结果:key 显示 myind

-- 测试2:跳过第一列直接查 loc,索引失效
explain select * from dept where loc='MsBDpMRX';
-- 结果:key 为 NULL,全表扫描
第5步:避免常见的索引失效场景
目的:防止因写法不当导致全表扫描。
风险点:
- LIKE 模糊查询:
-'%aaa':前缀通配,索引失效。
-'aaa%':后缀通配,索引依然有效。 - OR 条件:如果 OR 两侧的条件列没有全部建立索引,优化器通常会放弃索引,退化为全表扫描。例如:
WHERE dname='a' OR loc='b'(若loc无索引)。 - 数据类型隐式转换:字符串字段在WHERE中未加引号,导致类型不匹配。
-dname=1234:失效。
-dname='1234':生效。 - 计算或函数操作:对索引列进行函数运算(如
YEAR(date_col))会导致索引失效。 - 统计成本过高:若MySQL估计全表扫描比走索引更快(如小表或数据分布均匀),则不使用索引。
第6步:监控索引使用效率
入口:执行SQL后检查状态变量。
命令:SHOW STATUS LIKE 'Handler_read%';
- handler_read_key:越高越好,表示成功使用索引查询的次数。
- handler_read_rnd_next:越高越差,表示全表扫描或乱序读取的次数,反映查询低效。
常用SQL优化策略
第7步:优化大批量数据插入
背景:大量INSERT操作会频繁触发索引重建和日志刷盘,拖慢速度。
针对MyISAM:
ALTER TABLE table_name DISABLE KEYS; -- 关闭键维护
LOAD DATA INFILE 'file.txt' INTO TABLE table_name; -- 或批量INSERT
ALTER TABLE table_name ENABLE KEYS; -- 重新构建索引
针对InnoDB:
- 将待导入数据按主键顺序排列。
- 临时关闭唯一性检查和自动提交:
SET unique_checks=0;SET autocommit=0; - 执行插入后恢复设置。
第8步:优化 GROUP BY 与 JOIN
目的:减少内存排序(Filesort)和临时表开销。
默认情况下,MySQL会对 GROUP BY 的结果进行排序。若不需要排序结果,可追加 ORDER BY NULL 来禁止排序,从而节省CPU时间。
-- 强制不排序
EXPLAIN SELECT * FROM dept GROUP BY dname ORDER BY NULL;
在关联查询中,尽量使用 JOIN 替代子查询。InnoDB中,适当的JOIN可利用索引进行连接,避免在内存中创建临时表。
存储引擎的选择与数据类型优化
第9步:选择合适的存储引擎
比较:
- MyISAM:
- 优势:读速度快,压缩空间小。
- 劣势:不支持事务和外键;删除数据后空间不回收,易产生碎片。
- 适用:读多写少、对事务要求不高的场景(如日志记录)。 - InnoDB:
- 优势:支持事务、ACID特性、外键、行级锁;崩溃恢复能力强。
- 劣势:写入稍慢,占用磁盘空间较大(ibdata1)。
- 适用:大多数现代应用的首选,特别是涉及并发写和事务的场景。 - Memory:
- 数据存储在内存中,速度极快,但断电丢失。
- 适用:缓存、会话状态等非持久化数据。
操作建议:
- 对于MyISAM表,定期执行
OPTIMIZE TABLE table_name;以回收碎片空间,整理文件。 - InnoDB的数据文件通常在
data/ibdata1,表结构在.frm文件中(5.6之后每个表有独立的.ibd文件)。
第10步:选择合适的数据类型
精度要求高:涉及金钱或科学计算,严禁使用 FLOAT 或 DOUBLE,应使用 DECIMAL 定点数以保证精度。
日期类型:根据实际需要选择最小存储类型。例如,只需年月日时用 DATETIME 或 TIMESTAMP,而非字符串。注意Unix时间戳在2038年后的溢出问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















