


C++聚合关系中成员对象的构造与析构顺序详解

在C++面向对象设计中,聚合关系涉及一个主类包含另一个类的实例作为成员。这种组合关系决定了对象生命周期中的关键行为:当创建主对象时,内部成员对象会优先被构造;销毁时则顺序相反。本文将通过具体代码案例,深入剖析这一默认的构造与析构调用顺序及其背后的资源管理逻辑。
聚合关系的本质与图示
聚合关系是一种特殊的拥有关系,表示“has-a”语义。例如,一辆汽车(Car)拥有一台引擎(Engine),但引擎可以独立于汽车存在或被更换。在这种结构下,Car 类通常将 Engine 作为其私有数据成员。
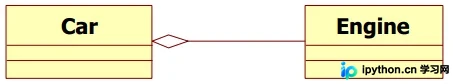
准备阶段:定义关联类
为了清晰展示对象初始化的时序,我们需要构建两个简单的类:代表核心部件的 Engine 类和代表整车的 Car 类。每个类都需实现构造函数和析构函数,并配合日志输出以便观察执行轨迹。
第1步:实现被聚合类 Engine
目的:定义独立的引擎模块,提供基本的生命周期接口。
操作:首先编写头文件 Engine.h,声明类及虚析构函数(虽此处非多态基类,但作为良好实践)。
#pragma once
class Engine
{
public:
  Engine();
  ~Engine();
};
接着实现源文件 Engine.cpp,在构造和析构时分别打印提示信息。
#include <iostream>
#include "Engine.h"
using namespace std;

Engine::Engine()
{
  cout << "调用构造函数:Engine()" << endl;
}

Engine::~Engine()
{
  cout << "调用析构函数:~Engine()" << endl;
}
第2步:实现主容器类 Car
目的:在 Car 内部实例化 Engine 对象,形成聚合关系。
操作:在 Car.h 中包含引擎头文件,并将 Engine 作为私有成员 m_eCar。
#pragma once
#include "Engine.h"

class Car
{
public:
  Car();
  ~Car();
private:
  Engine m_eCar;
};
在 Car.cpp 中实现相应的构造函数和析构函数。
#include <iostream>
#include "Car.h"
using namespace std;

Car::Car()
{
  cout << "调用构造函数:Car()" << endl;
}

Car::~Car()
{
  cout << "调用析构函数:~Car()" << endl;
}
核心验证:构造与析构的执行顺序
完成上述代码编译后,若在主程序中实例化一个 Car 对象并随后让其作用域结束,我们将观察到严格的执行序列。这印证了C++标准中关于对象生命周期管理的规则。
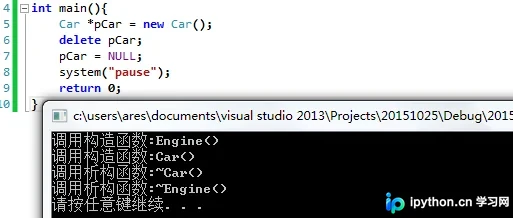
构造过程:由内而外
当执行 Car c; 时,内存分配完成后,编译器首先处理成员变量。由于 m_eCar 是 Car 的一部分且必须在 Car 本体初始化前就绪,因此 Engine() 构造函数会被优先调用。只有当所有成员对象(这里是引擎)都成功构造后,才会执行 Car 自身的构造函数体内容。这就好比组装实体车,必须先确保引擎运转正常,才能将其装入车身并完成整车调试。
析构过程:由外而内
当 Car 对象离开作用域或被手动删除时,生命周期的反转立即开始。系统首先执行 ~Car() 析构函数,完成整车层面的清理工作。紧接着,内部的成员对象 m_eCar 才会触发 ~Engine() 析构函数。这种逆序机制确保了外部依赖项(如整车框架)在分解前先释放对内部组件的控制权,防止悬空引用或资源泄漏。
总结与维护建议
C++聚合关系下的构造函数和析构函数严格遵循“构造时成员先行,析构时成员后置”的顺序。这一机制保障了复杂对象内部状态的完整性。
- 开发提示:不要在
Car的初始化列表中修改已经默认构造完成的简单成员,除非显式重写初始化列表以调整顺序。 - 资源管理:若
Engine持有底层硬件指针或文件句柄,务必确保在~Engine中正确释放,以免在~Car结束后发生访问违规。
以上就是C++聚合关系类的构造函数与析构函数的调用顺序的详细内容,更多关于C++面向对象编程的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















