


SQL Server 参数化 SQL 的 Parameter Sniff 问题与优化方案

在 SQL Server 开发中,遇到数据分布不均匀时,参数化存储过程极易发生 Parameter Sniff(参数嗅探)现象,导致不合理的执行计划被缓存并重用,进而引发严重的性能抖动。本文详细解析了该问题的成因,并介绍了一种兼顾执行计划缓存与按需重编译的实用策略。
Parameter Sniff 现象与问题分析
Parameter Sniff 是指在第一次编译带有参数的 SQL 语句或存储过程时,SQL Server 根据传入的具体参数值生成执行计划并将其缓存。当下次调用同一语句但传入不同参数时,数据库会尝试重用已有的缓存计划。若新参数对应的数据分布特征(如数据量极大或极小)与原计划生成时的情况差异巨大,就会导致严重的性能劣化。
为了直观理解,我们构建一个包含约 50 万条记录的测试表 ParameterSniffProblem,其中大部分数据的 CustomerId 呈现均匀分布,但特定客户 ID 6666 拥有大量订单。
1. 创建测试环境:
create table ParameterSniffProblem
(
id int identity(1,1),
CustomerId int,
OrderId int,
OrederStatus int,
CreateDate Datetime,
Remark varchar(200)
)
declare @i int = 0
while @i<500000
begin
INSERT INTO ParameterSniffProblem values (@i%10000,@i,RAND()*10,GETDATE()-RAND()*100,NEWID())
set @i=@i+1
end
-- 模拟特定客户数据量激增
INSERT INTO ParameterSniffProblem values (6666,RAND()*100000,1,GETDATE()-RAND()*100,NEWID())
GO 100000
CREATE CLUSTERED INDEX IDX_CreateDate on ParameterSniffProblem(CreateDate)
CREATE INDEX IDX_CustomerId ON ParameterSniffProblem(CustomerId)
2. 编写参数化存储过程:
通常为了提高性能和防止 SQL 注入,我们会使用动态 SQL 结合 sp_executesql 来实现灵活的参数化查询:
CREATE PROCEDURE [dbo].ParameterSniffTest
(@p_CustomerId int,@p_Status int,@p_FromDate datetime,@p_ToDate datetime)
AS
BEGIN
SET NOCOUNT ON
DECLARE @Parm NVARCHAR(MAX), @sqlcommand NVARCHAR(MAX) = N''
SET @sqlcommand = 'SELECT * FROM ParameterSniffProblem WHERE 1=1'

IF(@p_CustomerId IS NOT NULL)
SET @sqlcommand = CONCAT(@sqlcommand,'AND CustomerId=@p_CustomerId ')
IF(@p_Status IS NOT NULL)
SET @sqlcommand = CONCAT(@sqlcommand,'AND OrederStatus=@p_Status ')
IF(@p_FromDate IS NOT NULL)
SET @sqlcommand = CONCAT(@sqlcommand,'AND CreateDate>=@p_FromDate ')
IF(@p_ToDate IS NOT NULL)
SET @sqlcommand = CONCAT(@sqlcommand,'AND CreateDate<=@p_ToDate ')

SET @Parm= '@p_CustomerId int,@p_Status int,@p_FromDate datetime,@p_ToDate datetime'
EXEC sp_executesql @sqlcommand,@Parm,
@p_CustomerId = @p_CustomerId, @p_Status = @p_Status,
@p_FromDate = @p_FromDate, @p_ToDate = @p_ToDate
END
GO
3. Parameter Sniff 的表现:
首次传入 @p_CustomerId = 100
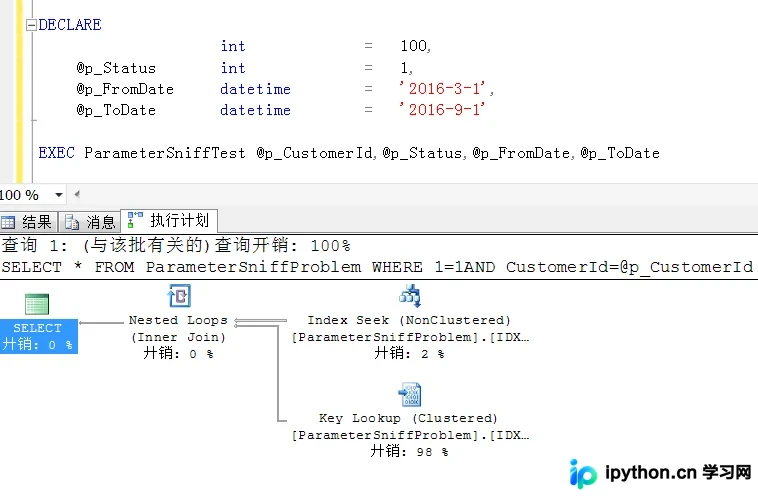
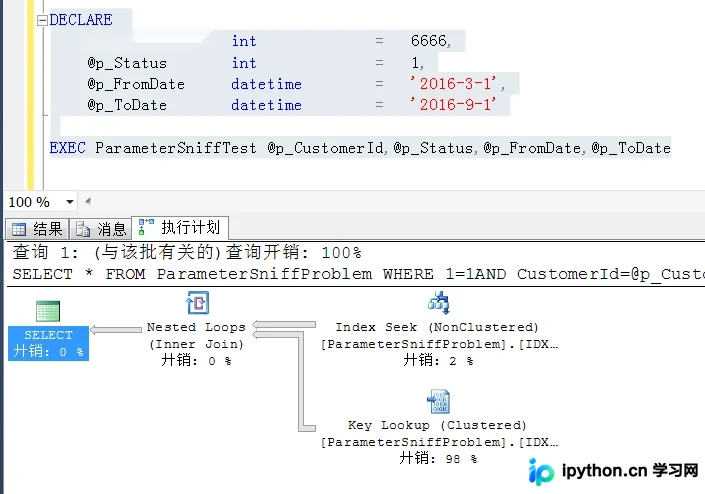
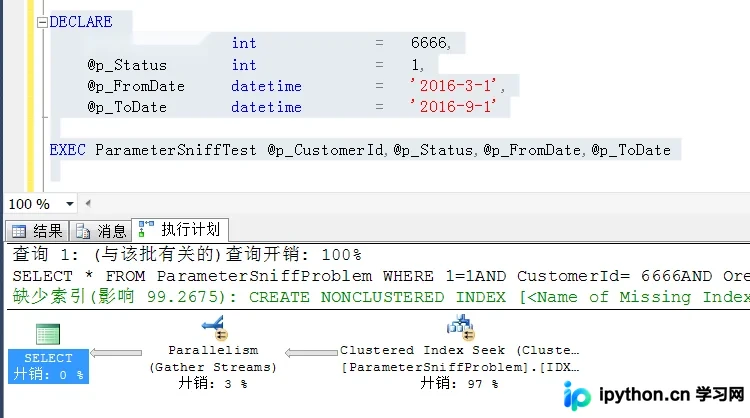
随后传入 @p_CustomerId = 6666(海量数据),由于复用了之前的索引查找计划,数据库试图只读取极少数数据,结果发现数据并不在预期的少量记录中,最终可能表现为扫描错误或缺失数据,或者因为过滤条件无法生效而导致极其低效的执行逻辑:
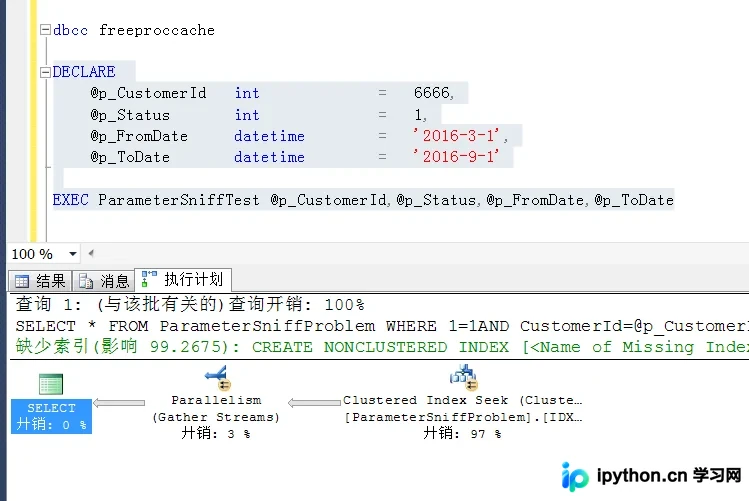
若清空缓存强制重新编译,针对 6666 的数据量,最优解实际上是走全表扫描(Table Scan)。这表明重用计划在此场景下是不合理的:
优化方案:针对性非参数化处理
解决 Parameter Sniff 的传统方法(如强制重编译、使用本地变量等)往往会导致所有执行计划全部失效,增加了服务器的 CPU 负担。更精细的策略是:仅对有“数据倾斜”风险的关键参数进行非参数化处理。
- 识别高风险参数:在上述案例中,
CustomerId是造成分布不均的核心原因。 - 修改拼接逻辑:不再将
@p_CustomerId作为参数传递给sp_executesql,而是直接将其值拼入 SQL 字符串中。
修改后的处理代码:
IF(@p_CustomerId IS NOT NULL)
-- 注意:此处不再是占位符,而是直接拼接整型数值
SET @sqlcommand = CONCAT(@sqlcommand,'AND CustomerId= ',@p_CustomerId)
效果验证与分析
当按照上述方式修改后,再次执行存储过程:
- 首次执行
@p_CustomerId=1:生成的 SQL 为 `... AND CustomerId= 1`。SQL Server 为其编译计划,依然命中IDX_CustomerId索引。
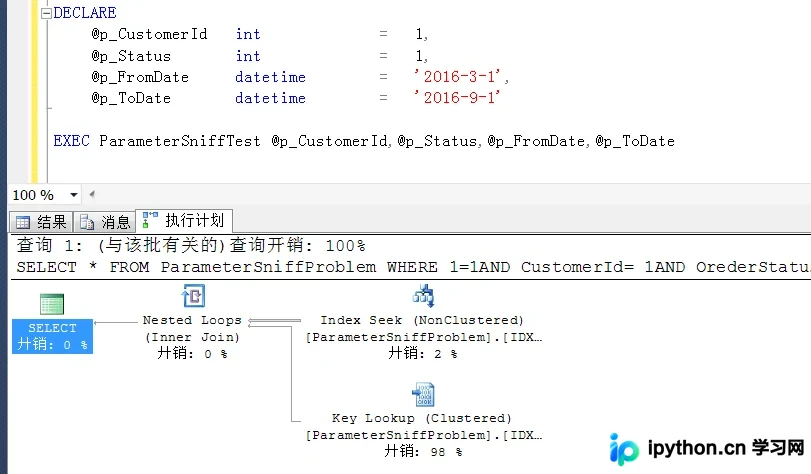
- 再次执行
@p_CustomerId=6666:由于 SQL 语句文本发生了改变(从 `CustomerId=1` 变为 `CustomerId=6666`),数据库判定其为不同的查询请求,因此不会复用CustomerId=1的计划,而是自动生成针对海量数据的优化计划(全表扫描或其他适宜方式)。
总结
这种折中方案虽然无法完全消除因关键参数变化带来的重编译开销,但它在两个维度上实现了平衡:
- 避免灾难性性能降级:确保了数据倾斜时不会产生错误的执行计划。
- 维持部分缓存复用:对于非核心参数(如
DateRange,Status)的变化,只要主键参数不变,仍有机会利用相同的底层执行框架,减少不必要的完全重编译。
在实际生产中,没有一种万能的方法能彻底消除 Parameter Sniff。开发者应优先针对那些已知存在严重数据偏斜(Skewness)的字段采取特殊的拼接策略,从而以最小的代价保障系统的稳定性。
以上就是 Parameter Sniff 问题分析与优化的详细内容,更多关于 SQL Server 执行计划优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















