


Pearson相关系数与Spearman等级相关系数的区别及适用场景

本文详解皮尔森(Pearson)与斯皮尔曼(Spearman)相关系数的核心差异。前者精准刻画连续变量的严格线性关系,后者灵活捕捉任意方向的单调趋势,并对异常值具备更强鲁棒性。结合公式推导与多类散点图对照,系统梳理两者在[-1,1]区间内的取值逻辑,为科研分析与特征筛选提供明确的指标选择依据。
指标定位与核心差异
相关系数是量化两个变量协同变化程度的统计指标,取值范围固定为[-1,1]。正负号指示方向,绝对值大小反映强度。在实际数据处理中,最常采用的两类指标具有明确的数学边界:
- 皮尔森相关系数(Pearson):专门用于评估两个连续型变量之间的线性依赖程度。要求数据近似满足特定分布假设,且对离群点高度敏感。
- 斯皮尔曼等级相关系数(Spearman):用于评估两个变量(含有序分类数据)之间的单调关系。只要变量保持“同增同减”或“此消彼长”的趋势即可计算,不强制要求线性或正态分布,抗干扰能力显著更强。
数学定义与数值解读
两者的计算基础均围绕差值平方和展开,最终映射至统一尺度:
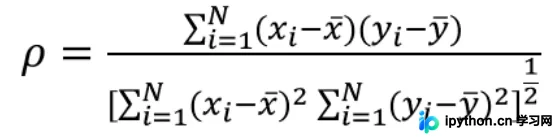
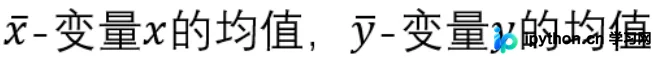
-1 ≤ p ≤ 1。接近0表示无线性关联;接近±1表示强线性关联。
Spearman系数通过将原始观测值转换为秩次后再计算,其本质是对变量排序一致性的度量:
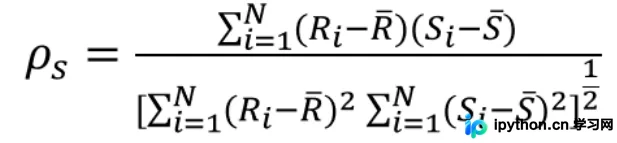
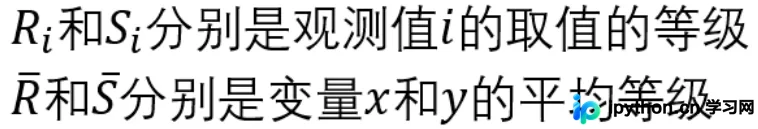
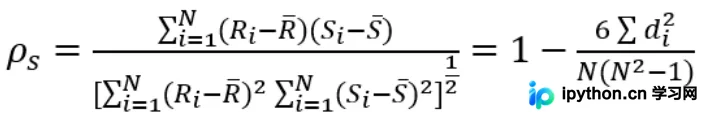
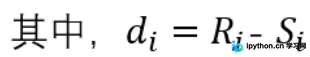
不同数据形态下的结果对比
理解系数量级变化的关键,在于观察散点图中数据点的分布轨迹。以下列举四种典型场景:
- 严格直线关系(递增/递减):变量变化率恒定。Pearson与Spearman系数同步达到极值±1。
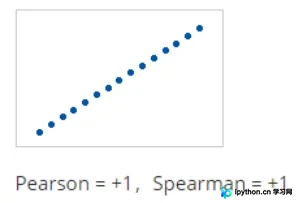
直线上升轨迹下双系数同时取满+1 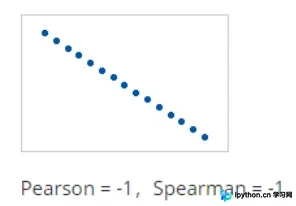
严格下降直线上双系数均为-1 - 非线性的单调关系:变量仍朝同一方向变化,但增速逐渐放缓或加速。此时Pearson因无法拟合弯曲轨迹而呈现中间值,Spearman却因仅关注排序顺序仍锁定为±1。
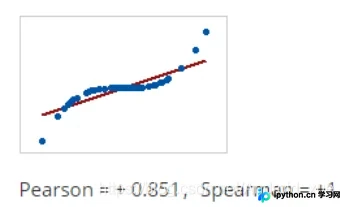
增速递减的弧线使Pearson偏离满分,Spearman依然保持高位 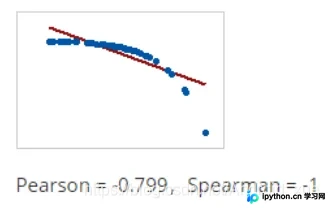
此类形态下两系数出现显著分化 - 随机散布或零关联:数据点呈云雾状分布,无任何方向规律。Pearson与Spearman均趋近于0,表明特征间缺乏可提取的统计依赖。
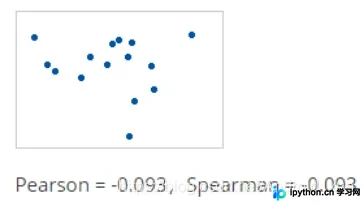
无明显规律的数据集显示双系数双双归零
非线性陷阱与排错建议
相关系数为0并不意味着变量独立。对于存在倒U型、指数变化等非单调关系的数据,两类指标均会失效: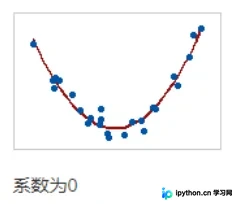
- 绘制探索性散点图:在调用相关性计算函数前,先使用可视化工具查看关键特征组合的二维投影,确认是否存在隐藏曲线或分段趋势。
- 处理极端离群值:Pearson极易被单点拉升或压制,可尝试截断极端样本后重新计算;若业务场景允许牺牲部分精度以换取稳定性,直接切换至Spearman。
- 补充高阶检验:针对复杂依赖结构,可引入互信息或距离相关系数进行交叉验证,避免单一指标的局限性。
总结
Pearson相关系数与斯皮尔曼相关系数的根本差异在于拟合维度的不同:前者锚定直线的陡峭程度,后者聚焦排序的一致性方向。面对常规近似平稳的数据,Pearson能提供更高的统计效力;当数据呈阶梯分布、包含粗大误差或仅需判断趋势走向时,Spearman是更稳妥的替代方案。在自动化特征工程管线中,将两者并行计算并辅以图形检查,能有效避免误判相关性强弱。以上就是Pearson与Spearman相关系数区别的详细内容,更多关于数据统计分析与机器学习的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















