


Python利用pdfplumber库提取PDF表格数据教程

本文详细介绍如何利用Python的pdfplumber库快速提取PDF文件中的表格数据。通过安装依赖、配置解析策略与遍历页面的实操步骤,提供可直接运行的代码模板与参数说明,帮助用户高效完成结构化数据抓取任务。
pdfplumber库简介与环境准备
pdfplumber 是一款基于 Python 的轻量级数据处理工具,专用于从 PDF 文档中精准提取文本与表格信息。相比传统的文本读取方式,该库能够自动识别表格线条结构,支持按页遍历、过滤排序与格式化输出,非常适合批量处理多页报表或合同类文档。使用的前提是已安装 Python 运行环境及 pip 包管理工具。
核心操作步骤
第1步:安装与验证依赖库
在终端或命令行中输入安装指令,系统将自动拉取 pdfplumber 及其底层依赖(如 pdfminer.six、Pillow 等)。
pip install pdfplumber安装完成后,可通过以下命令查看当前版本与依赖项,确认环境已就绪:
pip show pdfplumber执行后终端返回包含 Version、Requires 等字段的详细信息即表示安装成功。
第2步:构建文件读取与页面遍历框架
定义目标 PDF 的本地路径,使用上下文管理器安全打开文件,并获取总页数以便后续循环处理。此步骤的目的是确保资源正确加载且避免句柄残留。
import pdfplumber

# 替换为实际存放 PDF 的路径
local_path = '/Users/kkstar/Downloads/demo_table.pdf'

with pdfplumber.open(local_path) as pdf:
    # 获取总页数
    num_pages = len(pdf.pages)

    # 遍历每一页
    for page_num in range(num_pages):
        page = pdf.pages[page_num]
第3步:配置表格解析策略并提取数据
调用 extract_table 方法时,传入字典类型的解析参数可大幅提升复杂表格的识别率。主要参数包括垂直与水平策略,以及交点容差值。调整容差参数能解决线条断裂或错位导致的单元格合并问题。
        # 配置解析策略
        table_settings = {
            "vertical_strategy": "lines",       # 以竖线为界识别列
            "horizontal_strategy": "lines",     # 以横线为界识别行
            "intersection_x_tolerance": 15,     # X轴交点容差
            "intersection_y_tolerance": 15      # Y轴交点容差
        }

        # 提取当前页表格(返回二维列表)
        table_data = page.extract_table(table_settings=table_settings)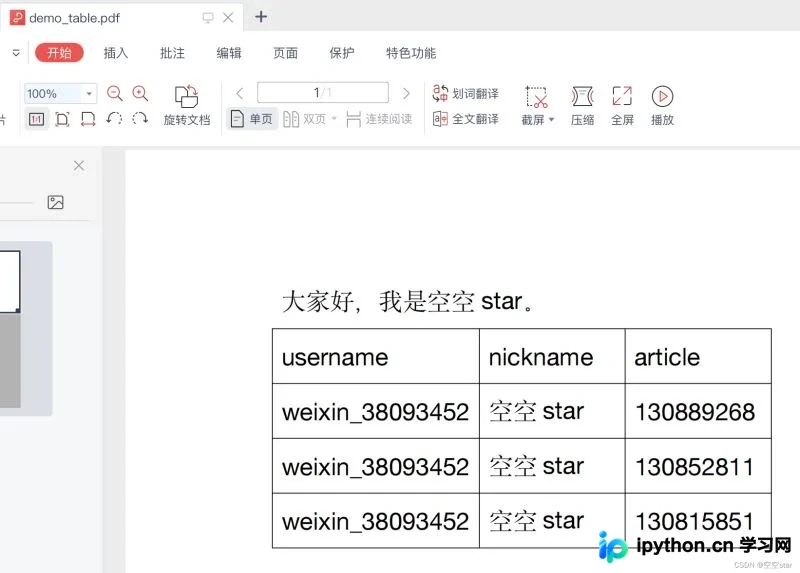
第4步:清洗数据与输出结果
提取出的数据通常为嵌套列表格式。遍历列表即可逐行打印或转为 CSV/JSON 格式保存。观察到标准控制台输出包含表头与多行数据,且进程正常退出时,代表提取任务已完成。
        if table_data:
            for row in table_data:
                print(row)
        else:
            print(f"第 {page_num+1} 页未检测到表格")
常见问题与参数调优
若提取结果出现行列错位或单元格丢失,属于布局解析常见的边界判断偏差。此时应重点检查 intersection_x_tolerance 与 intersection_y_tolerance 参数:数值过小会导致断线无法连接,数值过大会造成无关斜线误判为边框。建议根据实际文件的 DPI 分辨率逐步微调至 ±20 范围。另外,部分由图像生成的扫描件 PDF 缺乏矢量线条,该库默认策略可能失效,此类情况需配合 OCR 引擎使用。
总结
通过上述流程,即可稳定利用 Python 的 pdfplumber 组件完成 PDF 表格的结构化抓取。合理配置线条识别策略与容差阈值是保证数据准确性的关键。以上就是利用pdfplumber库提取PDF中表格数据的详细内容,更多关于Python处理PDF文档的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















