


PyCharm中运行pytest中文编码报错的解决方法

在Windows环境下使用PyCharm执行pytest时,常因配置文件包含中文字符触发UnicodeDecodeError编码解析错误。本文通过定位根因,说明如何清理pytest.ini中的中文配置、规范代码文件读取参数,并通过环境变量校验彻底解决测试运行时的中文乱码与解码失败问题。
错误现象与初步排查
在Windows系统中运行基于pytest的Python测试项目时,终端通常抛出以下异常:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xbc in position 174: invalid start byte
该错误往往伴随大量日志输出显示为问号(???),且连带影响对.yaml等数据文件的正常读取。初期尝试仅修改编辑器默认编码或未生效的环境变量,并未触及底层解析机制的核心冲突。
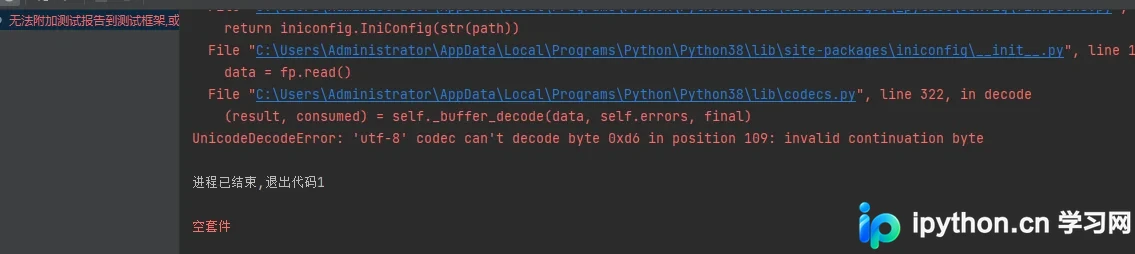
故障根源分析
经对照配置执行顺序发现,问题核心在于项目的初始化配置文件被错误包含了中文字符串。Windows系统下的pytest解析器在处理非ASCII字符时缺乏平滑降级机制,导致启动阶段即发生解码中断,进而引发后续所有依赖该配置环境的测试用例全量崩溃。
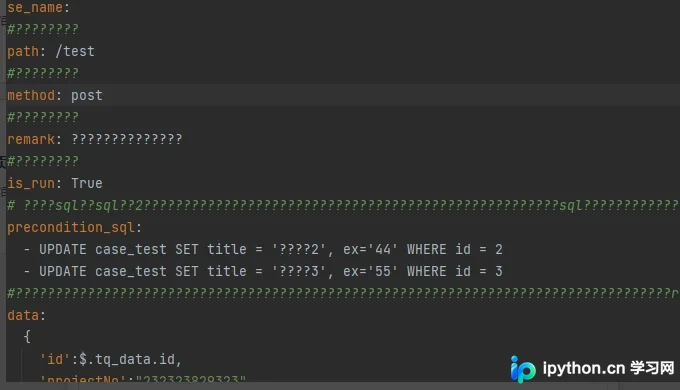
标准修复步骤
第1步:清理项目配置文件中的非ASCII内容
目的:消除触发内部解析器编码拦截的原始诱因。
入口:打开项目根目录下的 pytest.ini 文件。
动作:检索并删除全部中文字段说明,统一替换为英文命名规范。保存文件后关闭编辑器缓存。
重要参数:严禁直接覆盖或删除原有INI结构,仅需剔除多字节字符集文本。
完成状态:保存成功后再次保存文件无语法警告提示。
第2步:重写测试用例中的文件读取接口
目的:确保运行时IO流严格遵循UTF-8协议,避免回退至GBK导致二次乱码。
入口:定位报错路径对应的Python脚本源码。
动作:将旧版文件打开方式显式升级,增加明确的编码声明与安全容错策略:
with open(path, 'r', encoding='utf-8', errors='ignore') as f:
    # 执行后续数据处理逻辑
重要参数:
encoding='utf-8' 强制指定字符集,errors='ignore' 用于过滤潜在脏数据而非终止进程。完成状态:脚本运行时无
OSError 或 UnicodeDecodeError 回溯堆栈。
第3步:重建测试会话并验证执行流
目的:确认配置清理与代码修正是否完全解除阻塞。
入口:PyCharm底部 Terminal 窗口或右侧 pytest 运行配置面板。
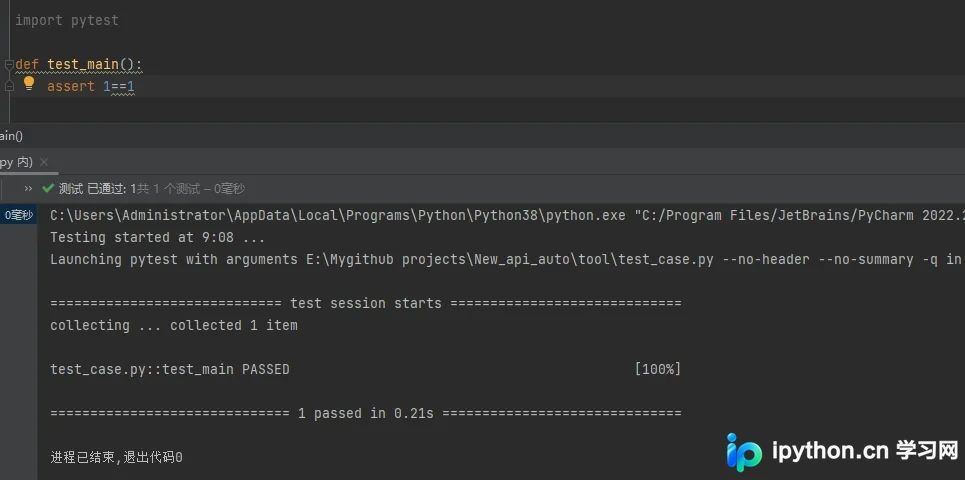
动作:清除历史运行缓存后重新点击执行按钮(Run 'pytest')。
重要参数:保持默认聚合报告模式,暂不引入覆盖率插桩以免掩盖基础IO问题。
完成状态:控制台滚动输出正常的用例通过率、耗时统计,日志渲染完整且无乱码符号。
延伸排错与环境校准
若清理配置文件后仍偶发间歇性乱码,需核对操作系统级环境变量。建议在系统高级设置中添加或更新 PYTHONIOENCODING=utf-8,并在IDE的运行配置(Run → Edit Configurations)勾选 Emulate terminal in output console 以对齐跨平台输出标准。针对涉及外部插件读取的情况,可临时追加命令行参数 -c pytest.ini --no-cov 排除附加模块干扰。
以上就是PyCharm运行pytest中文编码错乱问题的解决详细内容,更多关于Python自动化测试环境配置的实践资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















