


Python爬虫requests模块:查询参数与请求参数的区别及用法

在使用 Python requests 模块进行网页抓取时,准确处理 URL 地址中的参数是成功获取数据的关键。本文将详细拆解查询参数与请求参数的区别,并演示如何使用 params 和 data 关键字自动完成数据的拼接与编码,避免手动字符串拼接导致的字符集错误。
识别两种核心的 URL 地址参数
在使用 requests 发送网络请求前,必须先解析目标网址的结构。常见的 URL 包含两类截然不同的参数:查询参数和请求参数。理解它们的差异能有效提升爬虫编写的准确率。
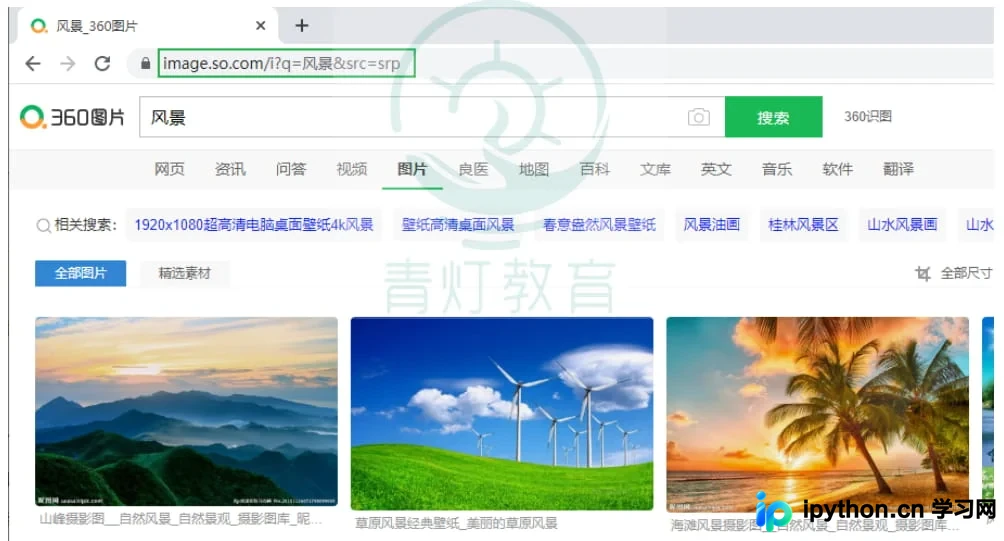
第一步:使用 params 处理查询参数
查询参数位于 URL 问号(?)之后,通常由键值对构成,用于向服务器传递搜索条件或过滤数据。例如:https://image.so.com/i?q=风景&src=srp。
若采用手动拼接字符串的方式处理含中文的 URL,极易引发编码问题。requests 模块提供了 params 关键字参数,直接接收一个字典对象,它会自动将键值对转换为标准 URL 编码格式(如中文转为百分号编码)。
import requests

params = {'q': '风景', 'src': 'srp'}
response = requests.get('https://image.so.com/i', params=params)
print(response.url)
打印出的结果会显示完整的、经过正确编码的 URL:
https://image.so.com/i?q=%E9%A3%8E%E6%99%AF&src=srp
在浏览器开发者工具的抓包界面中,此类参数通常展示在 Headers 栏目的 Query String Parameters 下。
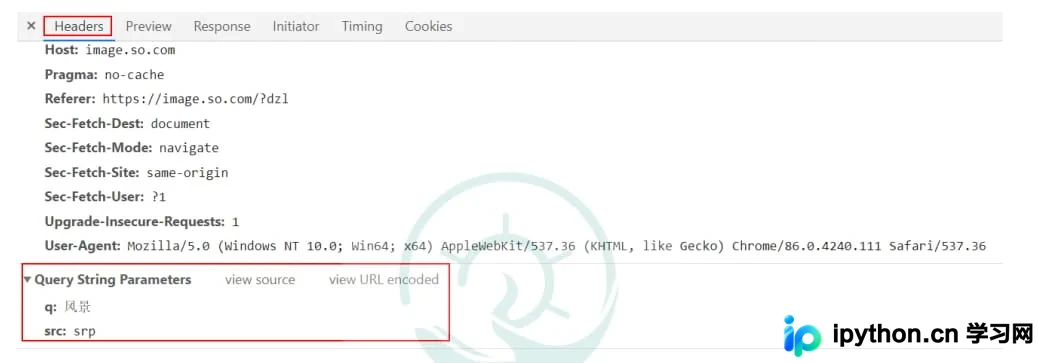
第二步:使用 data 处理请求参数
请求参数与查询参数存在本质区别。它们主要用于 HTTP POST 请求中,向服务器提交表单数据或上传文件。请求参数不会出现在浏览器地址栏的 URL 中,而是隐藏在请求体(Request Body)内。
通过 requests 的 post 方法,只需传入一个字典给 data 参数,模块便会自动将其序列化为表单编码格式(application/x-www-form-urlencoded)发送给后端。
data = {'key1': 'value1', 'key2': 'value2'}
response = requests.post('http://httpbin.org/post', data=data)
在抓包验证时,这类参数位于 Headers 下方的 Form Data 栏目中。
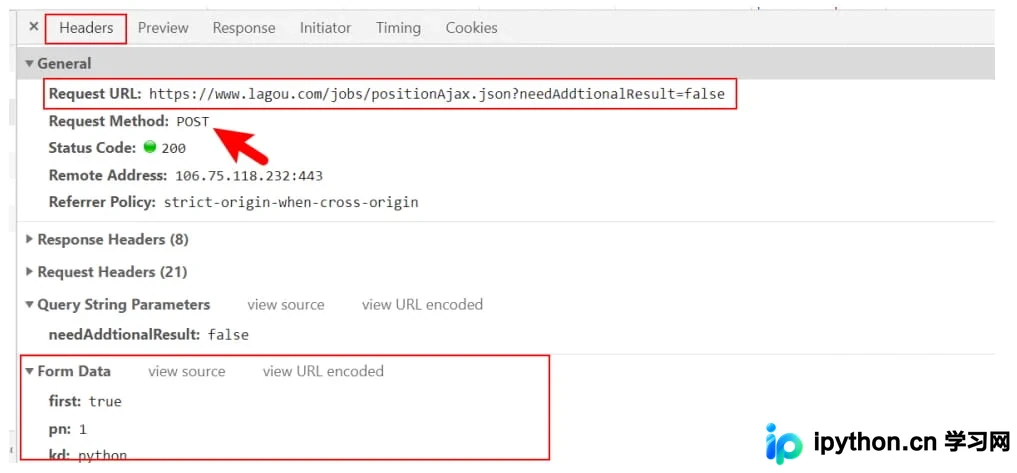
第三步:组合参数与附加请求头配置
实际逆向工程中,许多接口同时需要携带查询参数与表单数据。requests 允许在一次请求中混合使用上述关键字,并灵活注入自定义请求头(如反爬所需的 User-Agent)。
payload = {'username': 'admin', 'submit': True}
query = {'page': 1, 'limit': 20}
headers = {'User-Agent': 'Mozilla/5.0'}

response = requests.post(
    'http://target-site.com/api/data',
    params=query,
    data=payload,
    headers=headers
)
这种组合方式完美复现了浏览器发起复杂 AJAX 或表单提交的原始报文结构,是构建稳定 Python 爬虫的核心操作逻辑。以上就是 Python 爬虫 requests 模块查询参数与请求参数解读的详细内容,更多关于 Python 网络请求封装的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















