


Python目录下文件读取与批量处理方案

Python 处理本地数据时,常需自动获取目录文件列表以替代繁琐的手动筛选。本文基于标准库 os,详细演示如何精准提取单层目标文件、递归收集多级子目录内容,并结合实际业务流完成文件批量重命名。代码附带路径安全校验与异常处理机制,帮助开发者快速搭建稳定的自动化数据预处理管道。
Python 目录文件遍历与读取准备
在启动数据清洗、模型训练集构建或日志分析前,首先需要将目标文件的全路径汇总到列表中。以下分别针对非递归(仅当前层)与递归(含所有子目录)场景给出稳定写法。
第1步:提取单层目录下的匹配文件
目的:快速定位当前工作区内的指定文件,跳过无关子文件夹。
入口:import os 及目标文件夹字符串
动作:使用 os.listdir() 读取条目,利用 os.path.isfile() 排除目录干扰,并按关键字或后缀过滤。合并路径时务必使用 os.path.join() 避免字符串拼接错位。
重要参数:file_path_dir 目标父路径,filter_conditions 文件名字符串包含条件
完成状态:函数返回包含合规路径的列表 file_list,可直接传入后续的读取或解析函数。
import os

def load_file_dir():
    file_path_dir = "download_list_json"
    if not os.path.exists(file_path_dir):
        return []
    file_list = []
    for file_name in os.listdir(file_path_dir):
        current_path = os.path.join(file_path_dir, file_name)
        if not os.path.isfile(current_path):
            continue
        if ".temp" in file_name and "download_list" in file_name:
            file_list.append(current_path)
    return file_list
递归遍历并获取多级目录文件
第2步:深度扫描嵌套文件夹结构
目的:当工程或数据集存在多层级分包时,需一次性收集所有符合规则的完整路径。
入口:os.walk(top) 生成器
动作:逐层返回当前根目录、子文件夹名与文件名。遍历文件名列表,通过后缀过滤后拼接路径。针对 Windows 环境可能产生的反斜杠分隔符,统一替换为 Unix 风格的正向斜杠以保证后续解析兼容性。
重要参数:root 当前遍历根目录,file_names 该层文件列表,replacement_filter 目标后缀如 .json
完成状态:控制台打印出覆盖全树结构的合规文件路径数组。
import os

def load_recursive_dir():
    file_path_dir = "data"
    if not os.path.exists(file_path_dir):
        return []
    file_list = []
    for root, _, file_names in os.walk(file_path_dir):
        for file_name in file_names:
            if not file_name.endswith(".json"):
                continue
            clean_root = root.replace("\\", "/")
            file_list.append(f"{clean_root}/{file_name}")
    return file_list
基于文件列表的批量重命名实战
第3步:自动化整理与命名规范化
目的:解决海量文件手动重命名效率极低的问题,建立统一的索引编号以便程序按序读取。
入口:os.listdir() 获取原始列表,os.rename() 执行变更
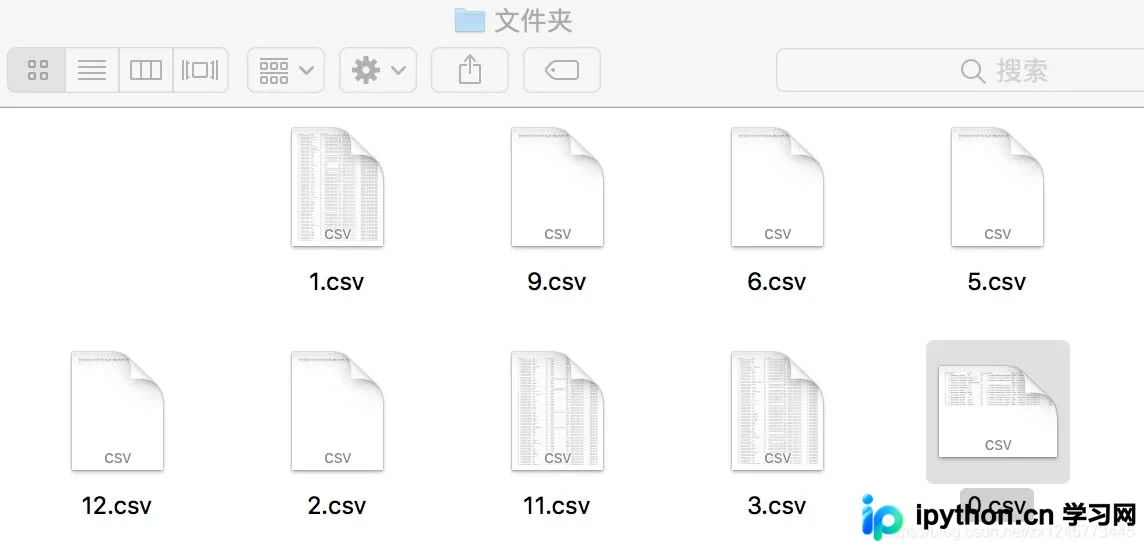
动作:遍历原始文件名,提取有效后缀并拼接新名称序列。加入 try...except 块拦截因权限不足、隐藏文件或路径冲突导致的报错,确保单条失败不中断整体流程。修改前后效果如下所示:
import os

def batch_rename_files():
    target_path = "./target_folder/"
    if not os.path.exists(target_path):
        return
    files = os.listdir(target_path)
    i = 0
    for file in files:
        try:
            used_name = os.path.join(target_path, file)
            ext = file.rsplit(".", 1)[-1] if "." in file else ""
            new_name = os.path.join(target_path, f"{i}.{ext}")
            os.rename(used_name, new_name)
            i += 1
        except Exception:
            pass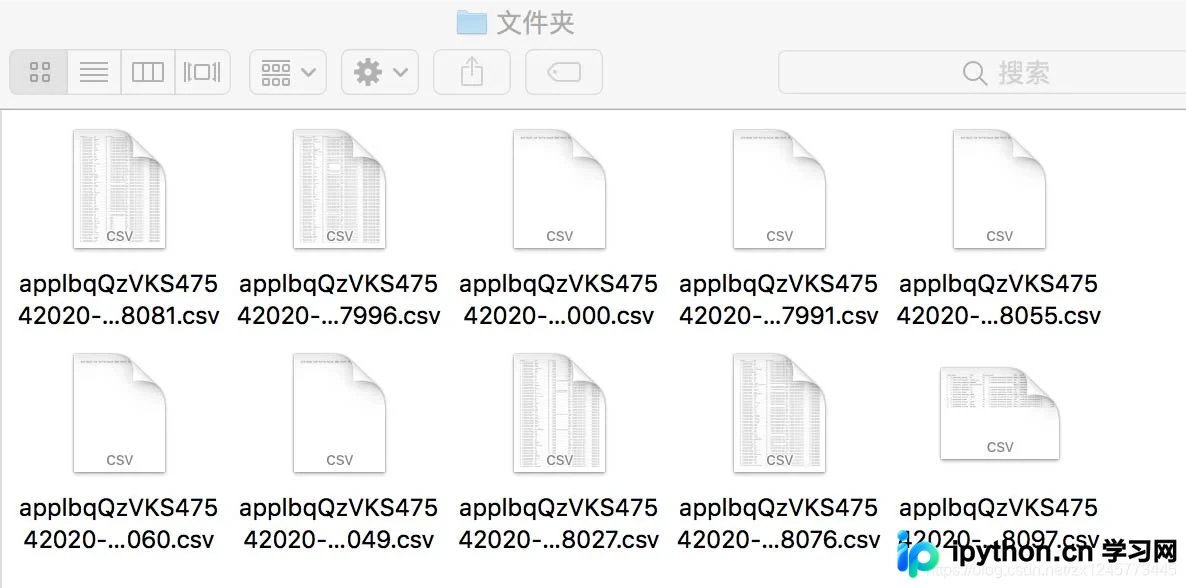
注意事项与排错建议
执行路径操作与文件变更前,请务必先备份重要数据或在小规模测试集上验证逻辑。若 os.rename() 抛出 FileNotFoundError,通常是因为拼接路径缺少末尾斜杠或未使用 os.path.join();若提示权限拒绝,请检查运行环境是否具备对应读写额度。跨平台部署时,建议将 os.walk() 的路径替换逻辑改为 pathlib.Path().as_posix() 以获得更稳健的行为。
总结
通过以上三种典型模式,您可以灵活应对从单层筛选、多级检索到批量格式化的日常开发需求。掌握路径拼接规范与异常容错机制,能有效避免常见运行时错误,让 Python 成为自动化数据流水线的可靠基石。以上就是 Python 目录下文件读取与批量处理方式的详细内容,更多关于 Python 文件系统操作与自动化脚本编写的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















