


pandas中Series和DataFrame的rank方法解析

本文详解pandas中Series与DataFrame的rank排名函数。内容涵盖默认平均排名原理、利用method参数自定义并列值处理策略、设置降序排列以及指定数据框行列维度的完整操作指南,帮助开发者快速掌握数据位次计算与标准化处理方法。
pandas数据排名的核心方法与进阶设置
在pandas数据处理中,rank() 用于将序列(Series)或二维表(DataFrame)中的数值转换为对应的排名等级。与直接返回重排数据的 sort_values() 不同,rank() 会严格保持原始数据的索引位置不变,仅替换为数值的大小次序。理解其背后的平级处理逻辑与参数控制,是进行数据标准化与分位筛选的关键。
第1步:理解默认的平级平均排名逻辑
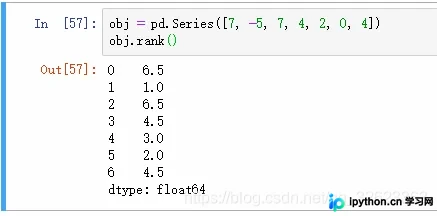
rank() 默认排序时,若遇到相同数值(平级),系统会计算这些名次取平均值并分配给相同的数据。例如在序列 [-5, 0, 2, 4, 4, 7] 中,-5占第1位,0占第2位,2占第3位;两个4原本应占第4和第5位,系统自动取其均值 4.5 分配;7同理取得 6.5。这种设计避免了并列数据被强行分割排名。
第2步:通过 method 参数定制平级值处理规则
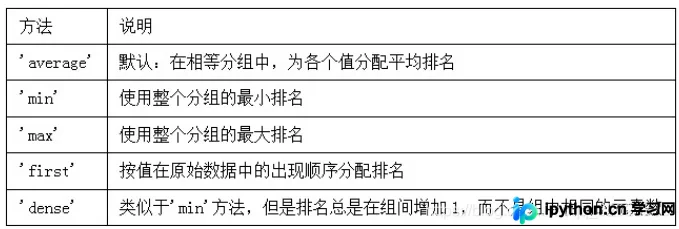
当不需要平均排名,或需根据业务场景灵活处理并列项时,可通过 method 参数调整策略。常用选项包括:
'average':默认值。同组数据获取平均排名。'min':同组数据均获得该组的最小排名(较宽松)。'max':同组数据均获得该组的最大排名(较严格)。'first':按数据在原序列中出现的先后顺序依次递增排名。'dense':类似'min',但后续不同值的排名紧接着当前组(如1,2,2,3而非1,2,2,4)。
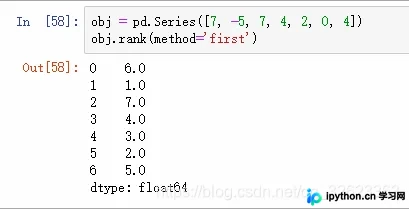
以 method='first' 为例,相同数值的排名不再取平均,而是严格按照读取顺序赋予连续整数。
第3步:切换逆序排名与 DataFrame 多维轴计算
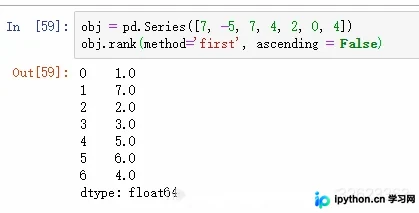
默认排名由小到大升序排列(ascending=True)。若需从高到低排名,只需传入 ascending=False。
对于 DataFrame 表格数据,排名默认沿列方向(纵向)进行计算(axis=0)。若需按横向行进行比较排名,可在调用时将轴参数设置为 axis=1。两者参数组合灵活,可覆盖绝大多数统计打分场景。
总结
掌握 rank() 的核心在于明确平级数据的分值分配方式(method)、升降序方向(ascending)以及计算维度(axis)。合理搭配这些参数,即可快速将原始数据转化为标准化的位次指标。以上就是 pandas 中 Series 和 DataFrame 的 rank 方法解析的详细内容,更多关于 Python 数据处理与 pandas 高级应用资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















