


Python数据分析入门指南:环境搭建与Pandas基础
针对初学者的Python数据分析入门指南,系统讲解基于Miniconda与Jupyter Lab的隔离开发环境搭建,以及Pandas核心数据结构Series、DataFrame的切片、筛选、缺失值清洗与聚合统计基础。
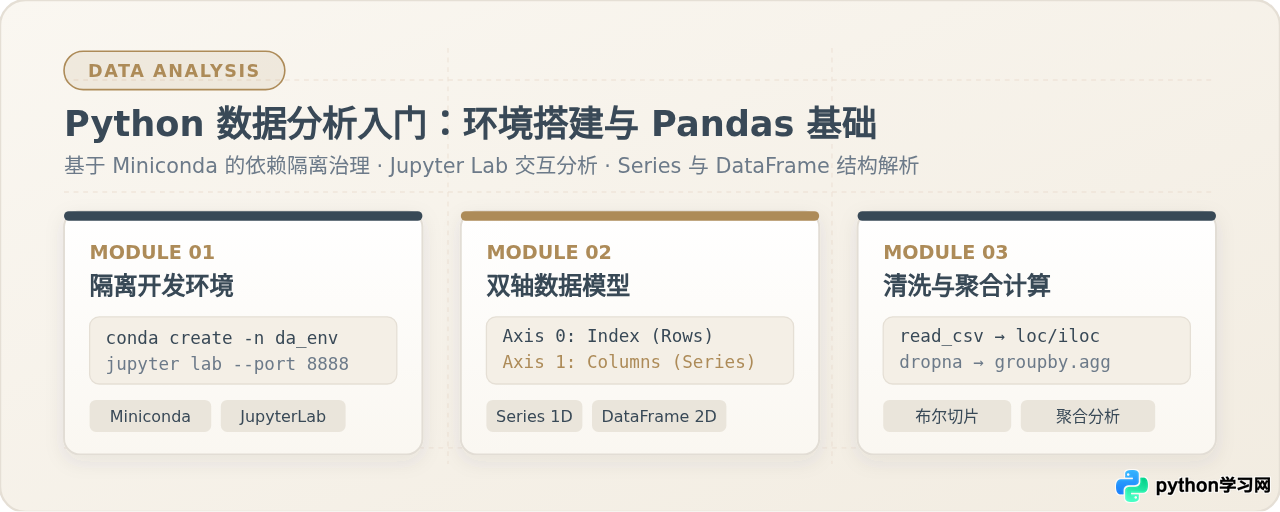
一、隔离环境搭建与开发工具配置
在进行数据分析时,直接使用操作系统默认自带的Python环境并在全局执行 pip install 具有较高风险。操作系统后台的众多工具依赖特定版本的系统级依赖包,随意升级或安装可能导致环境损坏。此外,不同分析项目所依赖的库版本也各不相同。使用Miniconda构建独立虚拟环境,能够将Python解释器和第三方包隔离在专属目录中,保持环境纯净可控。
1. Miniconda的安装与终端核验
相较于体积庞大、预装了大量非必需工具的完整版Anaconda,Miniconda仅包含Conda包管理器、Python以及少量核心依赖,是数据分析的标准起点。
安装完成后,打开操作系统的终端工具(macOS/Linux使用Terminal,Windows推荐使用PowerShell或Anaconda Prompt),执行版本核验命令:
终端执行位置:系统默认 Shellconda --versionconda 24.1.2
若能够正常返回版本号,说明Conda已被正确加入系统环境变量。
2. 创建并激活专属数据分析虚拟环境
推荐为数据分析项目创建基于Python 3.11稳定版本的虚拟环境。指定环境名称为 da_py311:
# 创建指定 Python 版本的独立环境
conda create -n da_py311 python=3.11 -y

# 激活该虚拟环境
conda activate da_py311
激活成功后,终端提示符最前端的标记会由 (base) 变为 (da_py311),这表明后续所有的安装和执行操作均被限制在该隔离环境内部。
3. 安装核心数据分析包与Jupyter Lab
在已激活的 da_py311 环境中,批量安装核心分析组件:Pandas(数据分析核心)、NumPy(数值矩阵底层计算)、JupyterLab(交互式探索环境)以及 openpyxl(用于读取和导出Excel .xlsx文件)。
conda install pandas numpy jupyterlab openpyxl -y4. 启动Jupyter Lab与环境可用性核查
在工作目录终端中输入以下指令,系统会自动在本地启动Web服务并调起默认浏览器:
终端执行位置:已激活的环境 (da_py311)jupyter lab
在Jupyter Lab界面左侧新建一个 Python 3 (ipykernel) Notebook,并在第一个单元格中输入以下测试代码,核验库的导入与版本输出:
import pandas as pd
import numpy as np

print("Pandas 版本:", pd.__version__)
print("NumPy 版本:", np.__version__)Pandas 版本: 2.2.2
NumPy 版本: 1.26.4
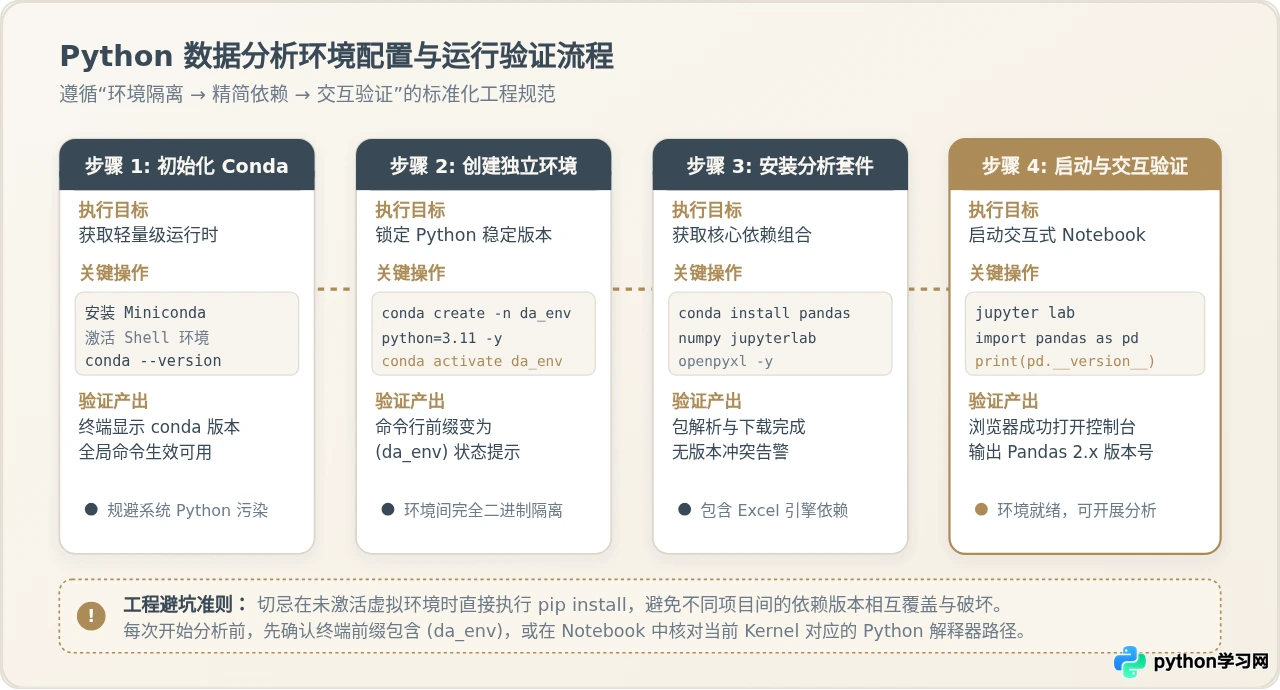
ModuleNotFoundError: No module named 'pandas',通常是因为当前Notebook使用的Kernel对应的是系统Python而非刚创建的 da_py311。请在Jupyter页面右上角点击Kernel名称,切换为 Python [conda env:da_py311]。
二、Pandas核心数据模型解析:Series与DataFrame
在Pandas中,所有数据操作均建立在两个核心数据结构之上:一维的 Series 和二维的 DataFrame。深入理解这两个对象的内存组织方式与索引机制,是熟练运用Pandas进行数据分析的前提。
1. Series:带标签的一维同质数组
Series是能够保存任何数据类型(整型、字符串、浮点型、Python对象等)的一维标记数组。它由两个核心组件构成:数据值(values) 和 索引标签(index)。
执行位置:Jupyter Notebook 单元格import pandas as pd
# 通过 Python 列表构造 Series,并自定义索引
sales = pd.Series([120, 230, 310, 180], index=['Q1', 'Q2', 'Q3', 'Q4'], name='季度销售额')
print(sales)
print("数值数组:", sales.values)
print("索引标签:", sales.index)Q1 120
Q2 230
Q3 310
Q4 180
Name: 季度销售额, dtype: int64
数值数组: [120 230 310 180]
索引标签: Index(['Q1', 'Q2', 'Q3', 'Q4'], dtype='object')
Series内部的每一个元素都严格对应同一个 dtype(同质数据),这使得其底层能够直接利用NumPy的高性能C语言连续内存布局。
2. DataFrame:二维表格型异构数据容器
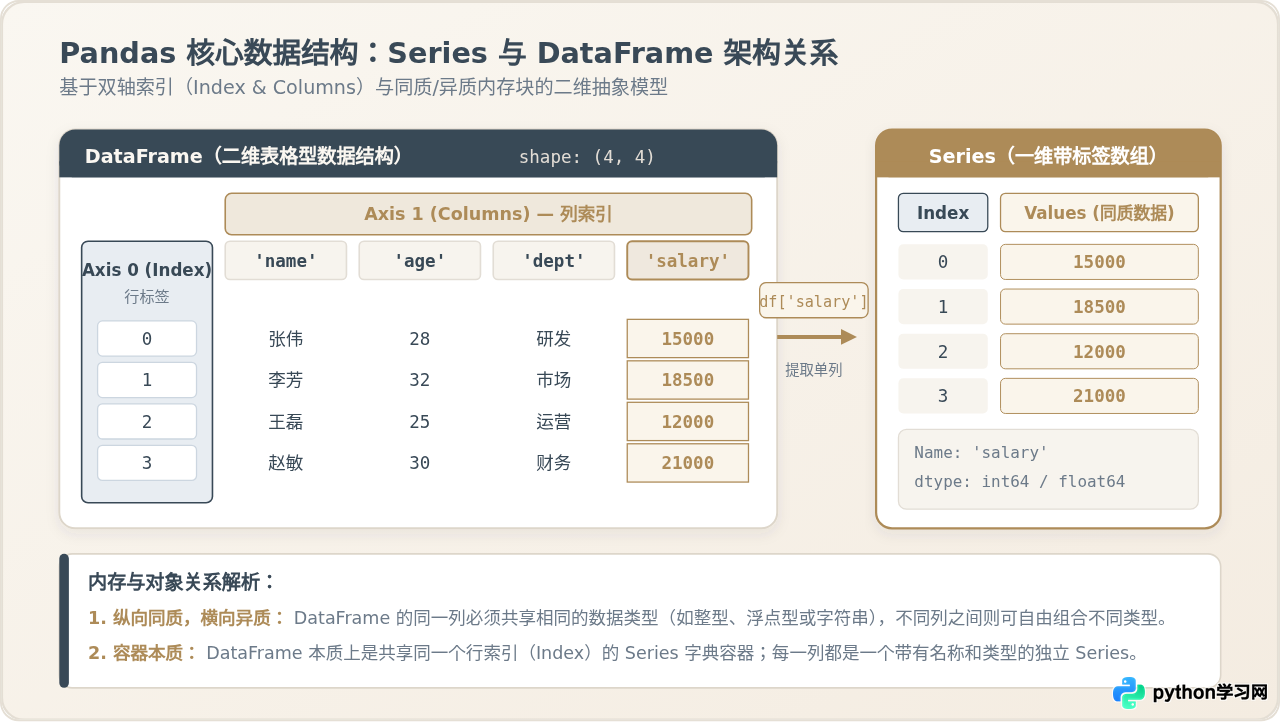
DataFrame是一个二维表格型数据结构,既有行索引(Index,对应 Axis 0),又有列索引(Columns,对应 Axis 1)。它的关键特征是纵向同质、横向异质:每一列内部的数据类型一致,而不同列之间可以拥有完全不同的数据类型(例如一列为整型,一列为文本,一列为时间日期)。
# 通过字典创建二维 DataFrame
data = {
    'name': ['张伟', '李芳', '王磊', '赵敏'],
    'age': [28, 32, 25, 30],
    'dept': ['研发', '市场', '运营', '财务'],
    'salary': [15000, 18500, 12000, 21000]
}

df = pd.DataFrame(data)
print(df) name age dept salary
0 张伟 28 研发 15000
1 李芳 32 市场 18500
2 王磊 25 运营 12000
3 赵敏 30 财务 21000
从本质上看,DataFrame可以视为共享同一个行索引的 Series 字典集合。当我们通过 df['salary'] 提取单列时,返回的对象即为一个标准的Series。
三、数据加载与初步状态探查
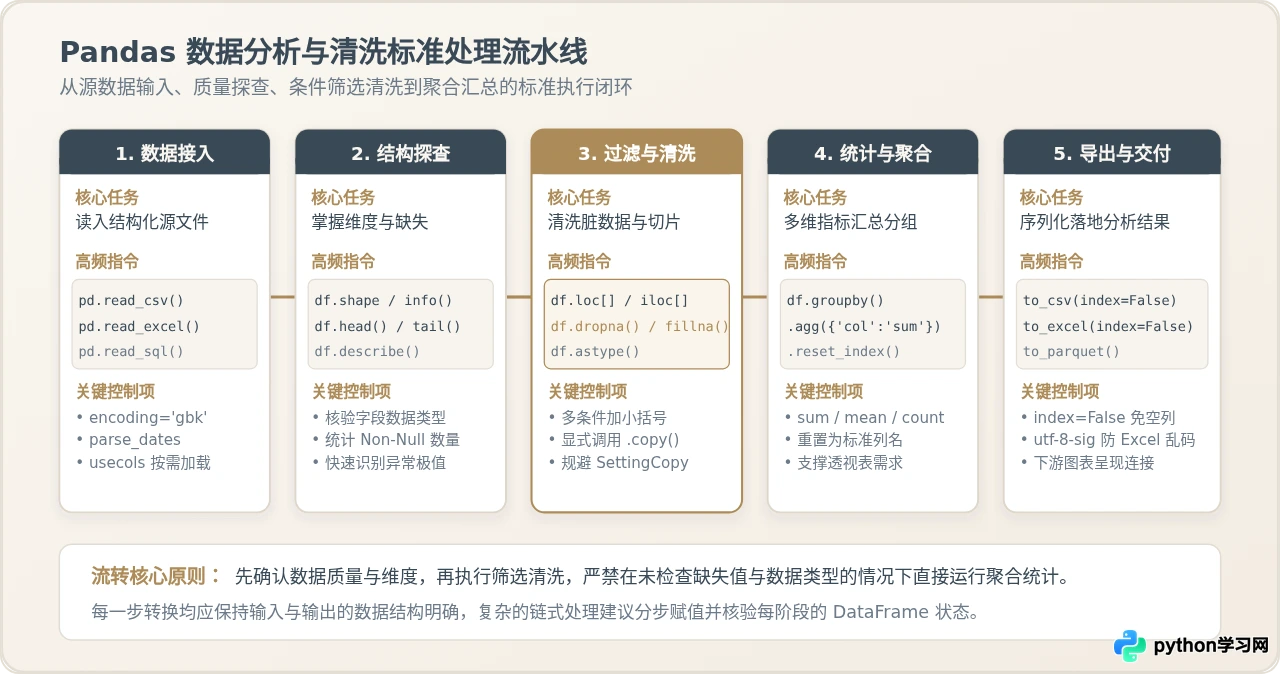
真实的数据分析任务大多始于从外部持久化文件(CSV、Excel、SQL或Parquet)中载入数据。读取数据后,必须第一时间探查数据的维度、列名、缺失情况与基础分布。
1. 文件加载常用方法与参数控制
针对CSV文件与Excel文件,Pandas分别提供了 pd.read_csv() 与 pd.read_excel() 方法:
# 读取 CSV 文件:指定编码、按需加载字段与时间字段自动解析
df_csv = pd.read_csv(
    'orders.csv',
    encoding='utf-8',             # 若包含中文且报解码错误,可换用 'gbk' 或 'utf-8-sig'
    usecols=['order_id', 'date', 'user_id', 'amount'],  # 仅加载指定字段,降低内存占用
    parse_dates=['date']          # 将 date 列直接解析为 datetime64 类型
)

# 读取 Excel 文件
df_excel = pd.read_excel('monthly_report.xlsx', sheet_name='Sheet1')
2. 宏观结构与质量探查指令
数据加载后,切忌盲目打印全部数据。在生产环境中,数据可能包含数十万行,应使用专用诊断函数进行观察:
| 探查属性 / 方法 | 功能说明 | 输出内容示例 |
|---|---|---|
df.shape |
获取数据表形状维度元组 | (10000, 8)(表示1万行,8列) |
df.info() |
输出各列非空计数、数据类型及内存占用 | 字段类型清单与内存开销统计 |
df.head(5) |
预览前 5 行记录 | 前 5 条具体数据记录 |
df.describe() |
生成数值型列的均值、极值、分位数等描述统计 | count, mean, std, min, 25%, 50%, 75%, max |
df.isna().sum() |
统计每一列的空值(NaN)总数 | 列名及对应的缺失行数统计 |
# 打印数据形状与字段类型概要
print("数据维度:", df_csv.shape)
df_csv.info()数据维度: (4, 4)
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 4 entries, 0 to 3
Data columns (total 4 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 order_id 4 non-null int64
1 date 4 non-null datetime64[ns]
2 user_id 4 non-null object
3 amount 3 non-null float64
dtypes: datetime64[ns](1), float64(1), int64(1), object(1)
memory usage: 256.0+ bytes
四、核心数据操作:索引切片、清洗与聚合
在确认数据结构后,接下来的核心环节是对表格进行行列切片抽取、脏数据清洗以及多维度聚合统计。
1. 行列选择:loc 与 iloc 的本质区别
Pandas中进行数据选取的两大基石是 loc 和 iloc,初学者最容易混淆其定位逻辑:
loc(Label-based):基于标签名称选取。行切片按照索引名称查找,区间为闭区间(包含两端边界)。iloc(Integer-position based):基于整数物理位置选取,从 0 开始计数。遵循Python原生切片规范,区间为左闭右开区间(包含起始下标,不包含结束下标)。
# 基于行标签与列名选择(loc)
# 选取索引为 0 到 2 的行(包含 2),以及 'name'、'salary' 两列
sub_loc = df.loc[0:2, ['name', 'salary']]

# 基于整数下标位置选择(iloc)
# 选取第 0 行和第 1 行(不包含 2),以及前 2 列(0 和 1 列)
sub_iloc = df.iloc[0:2, 0:2]

print("--- loc 提取结果 ---")
print(sub_loc)
print("--- iloc 提取结果 ---")
print(sub_iloc)--- loc 提取结果 ---
name salary
0 张伟 15000
1 李芳 18500
2 王磊 12000
--- iloc 提取结果 ---
name age
0 张伟 28
1 李芳 32
2. 条件布尔筛选
布尔筛选是指利用比较运算生成布尔型Series,并将其作为过滤器传入DataFrame中。在多条件筛选时,必须使用位运算符 &(与)或 |(或),并且每一个独立的条件表达式都必须使用小括号显式包裹。
# 筛选 age 大于 26 且 salary 大于 16000 的记录
condition = (df['age'] > 26) & (df['salary'] > 16000)
filtered_df = df[condition]

print(filtered_df) name age dept salary
1 李芳 32 市场 18500
3 赵敏 30 财务 21000
3. 缺失值(NaN)清洗实践
在真实数据集中,由于录入疏漏或传输异常,经常存在空值(显示为 NaN 或 None)。处理缺失值有两种标准策略:剔除与填充。
# 构造含缺失值的样本数据
dirty_data = pd.DataFrame({
    'order_id': [101, 102, 103, 104],
    'amount': [250.0, None, 180.0, None],
    'status': ['已付款', '已付款', None, '已退款']
})

# 策略一:直接剔除关键字段为 NaN 的行
clean_drop = dirty_data.dropna(subset=['amount']).copy()

# 策略二:使用均值或固定值进行缺失填充
# 计算有效数值的均值
mean_val = dirty_data['amount'].mean()
dirty_data['amount_filled'] = dirty_data['amount'].fillna(mean_val)
dirty_data['status_filled'] = dirty_data['status'].fillna('未知状态')

print(dirty_data) order_id amount status amount_filled status_filled
0 101 250.0 已付款 250.0 已付款
1 102 NaN 已付款 215.0 已付款
2 103 180.0 None 180.0 未知状态
3 104 NaN 已退款 215.0 已退款
4. 分组聚合统计(groupby 与 agg)
在数据分析中,类似SQL中 GROUP BY 的需求极为普遍。Pandas通过 groupby() 配合 agg() 实现了灵活的多维度聚合统计计算:
# 构造业务明细数据
sales_record = pd.DataFrame({
    'dept': ['华北', '华东', '华南', '华北', '华东', '华南'],
    'sales': [300, 450, 200, 520, 610, 310],
    'profit': [45, 80, 25, 95, 110, 40]
})

# 按部门(dept)分组,分别计算销售额总和与利润平均值,并重置索引
dept_summary = sales_record.groupby('dept').agg({
    'sales': 'sum',
    'profit': 'mean'
}).reset_index()

# 重命名聚合列
dept_summary.rename(columns={'sales': '总销售额', 'profit': '平均利润'}, inplace=True)
print(dept_summary) dept 总销售额 平均利润
0 华东 1060 95.000000
1 华北 820 70.000000
2 华南 510 32.500000
五、生产级常见问题与避坑指南
在日常使用Pandas时,有几个高频出现的警告与报错直接影响分析结果的正确性,掌握其产生机理可大幅减少排错耗时。
1. 警惕 SettingWithCopyWarning 警告
当编写类似 df[df['age'] > 25]['salary'] = 20000 的代码时,Pandas往往会抛出 SettingWithCopyWarning。这是因为链式索引(即多个中括号连续调用)导致Pandas无法在底层确定返回的是原数据的视图(View)还是副本(Copy),此时的赋值操作可能根本无法反映到原DataFrame中。
正规解法:使用单步 loc 语法直接修改原数据,或者在衍生子数据集时主动调用 .copy():
# 正确做法 1:通过 loc 一次性定位行与列进行修改
df.loc[df['age'] > 25, 'salary'] = 20000

# 正确做法 2:如果需要抽离为新数据集,显式创建独立副本
sub_df = df[df['age'] > 25].copy()
sub_df['salary'] = 20000
2. 规避对 inplace=True 的过度依赖
许多初学者倾向于在各种方法中加入 inplace=True(例如 df.dropna(inplace=True)),误以为这样能够节省内存开销。实际上,在Pandas绝大部分底层实现中,inplace=True 依然会在内部创建副本后再覆盖原变量指针,并不能优化内存占用。相反,它会破坏函数返回对象的特性,导致无法进行链式方法调用(Method Chaining)。
官方与现代代码规范建议采用显式重新赋值的写法:
# 推荐写法:赋值清晰,易于调试与链式拓展
df = df.dropna(subset=['amount']).reset_index(drop=True)
3. 文本编码异常处理与结果持久化导出
在Windows平台使用Excel导出的CSV通常采用GBK编码,直接使用 pd.read_csv() 读取时极易触发 UnicodeDecodeError: 'utf-8' codec can't decode byte... 报错。此时应显式声明 encoding='gbk'。
在完成清洗加工并将结果导出为CSV时,务必加上 index=False 参数,以避免Pandas自动将无意义的 0, 1, 2 行索引作为一列写入目标文件;若目标文件需要使用Excel直接打开,建议指定 encoding='utf-8-sig' 携带BOM头以防止中文乱码:
# 将最终分析结果安全导出为 CSV 文件
dept_summary.to_csv('dept_summary_final.csv', index=False, encoding='utf-8-sig')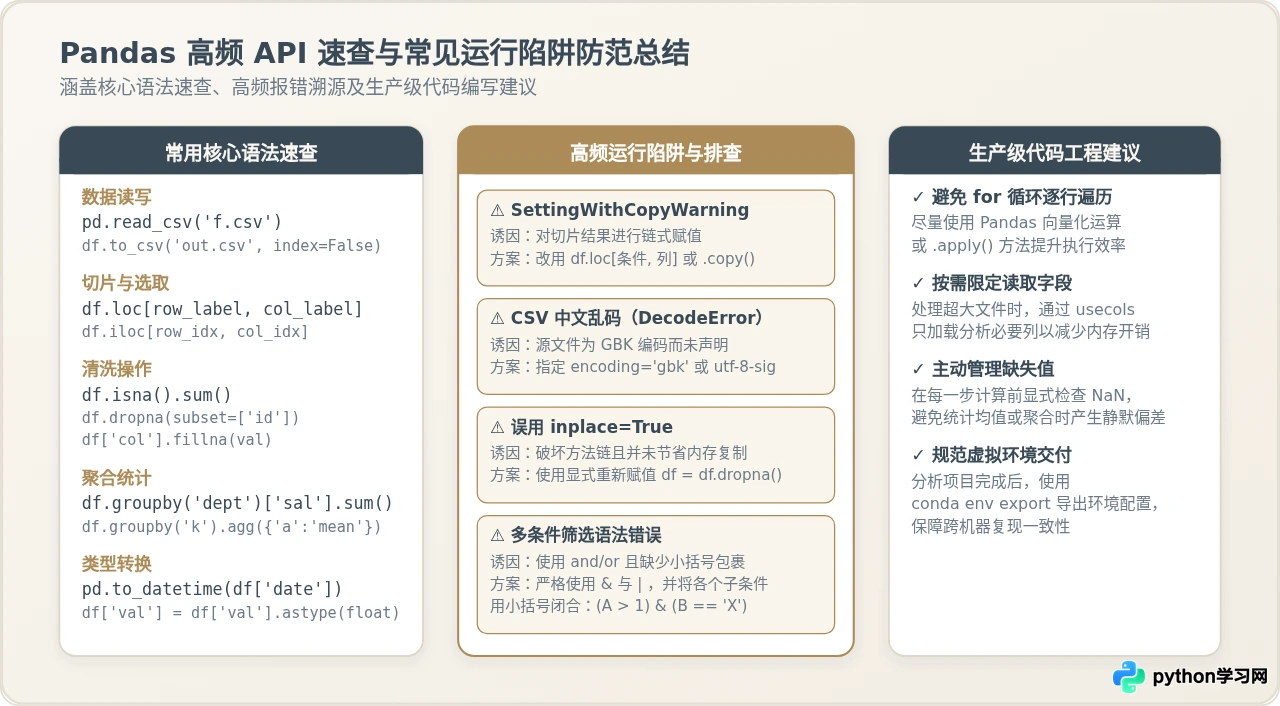
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















