


Python基础文件处理工具开发指南(读写/压缩解压/遍历)

发布时间:2026-10-10 |
4人浏览过
本文提供基于Python开发常用文件处理工具的完整方案,涵盖使用内置函数读写文本、利用os.path识别后缀、通过zipfile打包及子进程调用的解压方案,配合目录遍历获取全量路径。附可复用代码与运行核对方法,适合集成至自动化批处理脚本。
实现目标与核心模块
在自动化运维与数据预处理场景中,频繁需要执行文件的读取、写入、类型校验、归档压缩、解压还原以及深层目录遍历。通过整合os、zipfile与subprocess标准库,可快速构建一套低依赖、高稳定性的文件处理工具集,直接嵌入现有项目调用。
第1步:准备运行环境与操作规范
在执行任何覆盖、解压或批量移动操作前,务必确保目标目录具有读写权限,并对重要数据进行预备份,防止误覆盖导致数据丢失。本工具集默认使用utf-8编码读写文本,适用于主流操作系统环境。
第2步:实现文件读写与类型识别
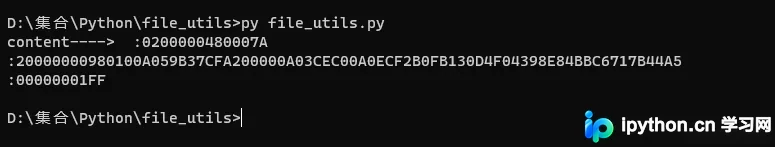
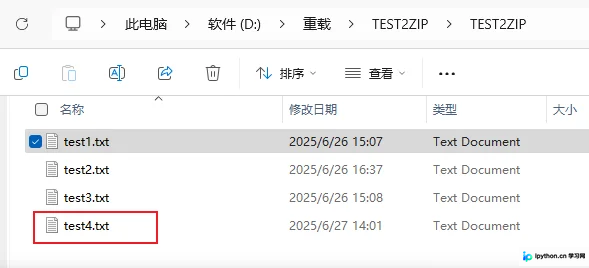
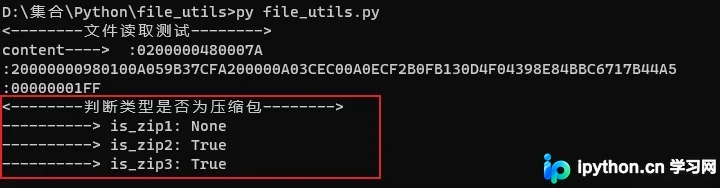
文件读取与写入是基础操作。使用上下文管理器with open()可自动管理文件句柄,避免显式调用f.close()导致的资源泄露。同时,通过os.path.splitext()提取扩展名并对比常见归档格式,可精准识别压缩包类型。
# 文件处理工具集 file_utils.py
import subprocess
import os
import zipfile

def read_file(file_path):
    with open(file_path, 'r', encoding='utf-8') as f:
        return f.read()

def write_file(file_path, content):
    with open(file_path, 'w', encoding='utf-8') as f:
        f.write(content)

def is_pack(file_path):
    ext = os.path.splitext(file_path)[1].lower()
    if ext in ['.zip', '.rar', '.7z']:
        return True
    return False

if __name__ == '__main__':
    # 示例调用
    txt_content = read_file('test.txt')
    print(f"读取内容: {txt_content}")
    write_file('output.txt', txt_content)
    print(f"是否为压缩文件: {is_pack('test.zip')}")
第3步:完成归档打包与目录遍历
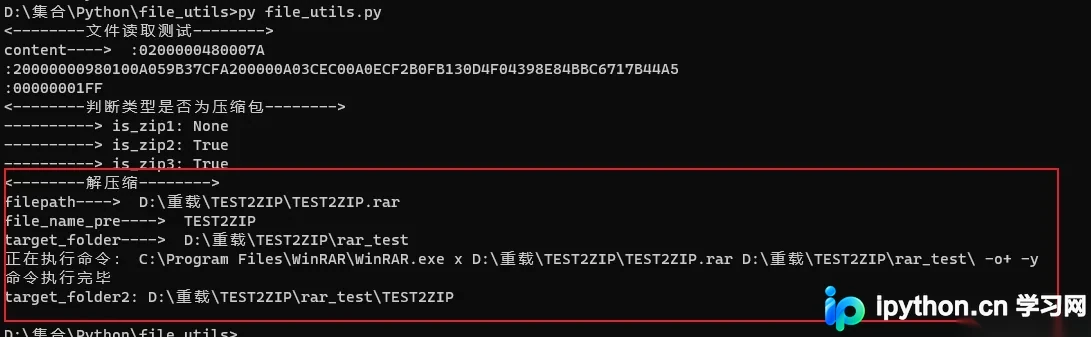
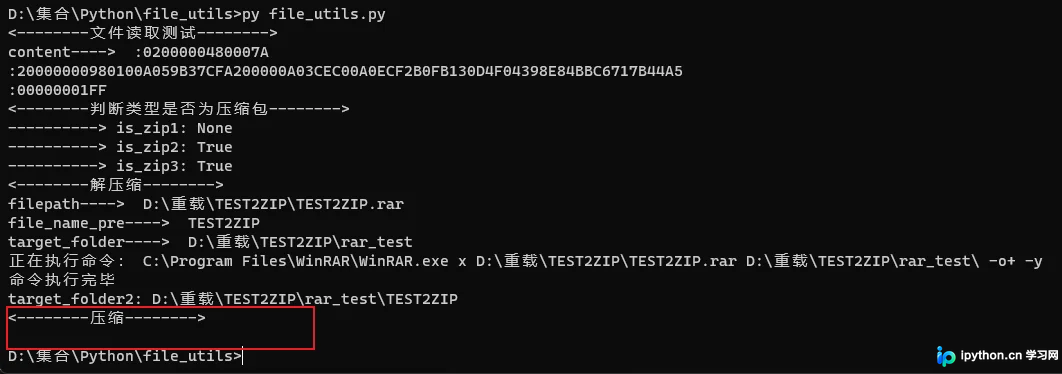
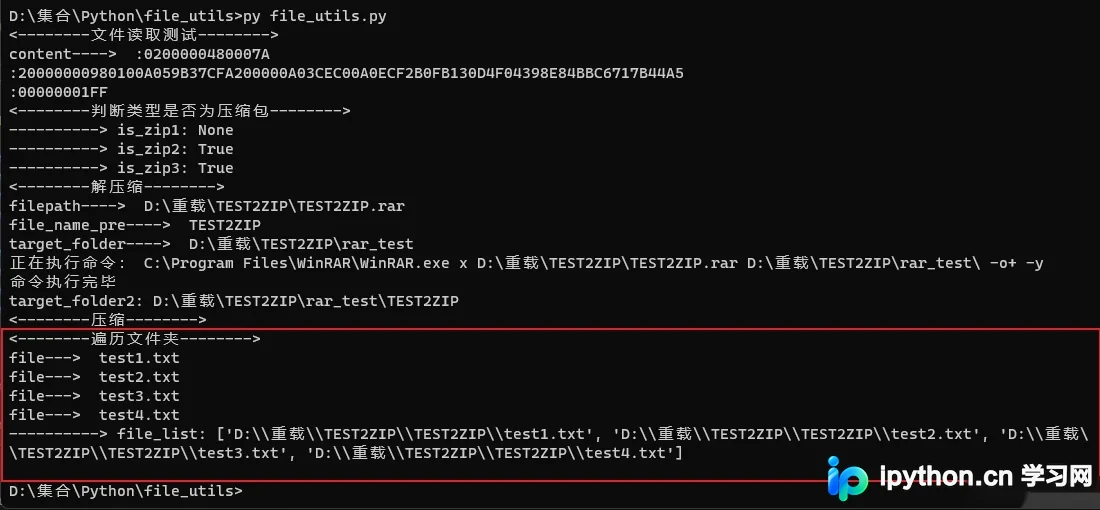
压缩文件夹时使用zipfile.ZipFile结合os.walk递归收集文件,并通过os.path.relpath保留原有目录结构。解压操作因不同格式引擎差异较大,此处提供基于外部命令行工具(如WinRAR)的参数化封装方案,并附带目录遍历函数用于批量扫描。
def zip_folder(folder_path, output_path):
    with zipfile.ZipFile(output_path, 'w', zipfile.ZIP_DEFLATED) as zip_file:
        for root, dirs, files in os.walk(folder_path):
            for file in files:
                abs_path = os.path.join(root, file)
                rel_path = os.path.relpath(abs_path, folder_path)
                zip_file.write(abs_path, rel_path)

def unpack(filepath, target_folder, exe_path='C:\\Program Files\\WinRAR\\WinRAR.exe'):
    file_name_pre = os.path.splitext(os.path.basename(filepath))[0]
    command = [
        exe_path, 'x', os.path.abspath(filepath),
        target_folder.rstrip('\\') + '\\', '-o+', '-y'
    ]
    subprocess.run(command, check=True, stdout=subprocess.PIPE, stderr=subprocess.PIPE, text=True)

def iteration_folder(folder_path):
    file_list = []
    for root, dirs, files in os.walk(folder_path):
        for file in files:
            file_list.append(os.path.join(root, file))
    return file_list
第4步:验证执行结果与常见问题排错
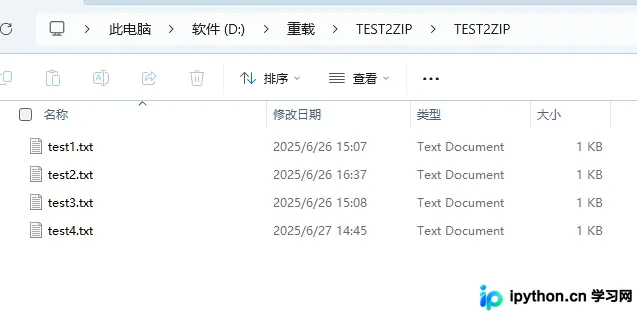
完成部署后,可通过以下步骤核对工具可用性:
- 编码冲突排查:若读取时报错
UnicodeDecodeError,需确认源文件编码格式,并将encoding参数替换为gbk或latin-1。 - 权限拒绝处理:写文件或覆盖系统目录时提示
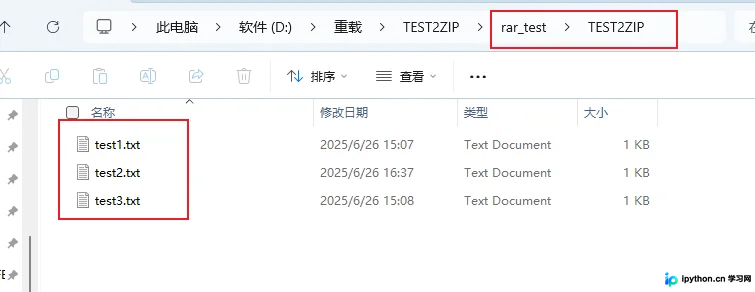
PermissionError,请以管理员身份运行脚本或更换非受保护路径。 - 解压路径错位:部分命令行解压器会额外生成一层同名文件夹作为子目录,解析结果路径时需拼接压缩包基础文件名。
以上就是Python文件读写压缩解压与目录遍历操作的详细内容,更多关于Python实用开发技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















